

Les contenus liés au tag Samsung
Afficher sous forme de : Titre | Flux Les 5 contenus précédents
Le 14nm LPP produit en volume chez Samsung
Samsung SSD 750 EVO : 3, 5 ou 6 ans de garantie
128 Go en RDIMM DDR4 chez Samsung
Samsung 750 EVO, un 850 EVO ''light''
AMD valide le 14nm LPP de GloFo

NVMe PCIe x4 Samsung à 3.2 Go /s
 (0) Réaction


Samsung Japon a organisé un évènement autour de ses SSD au cours duquel il a dévoilé quelques nouveautés. On commence par un nouveau contrôleur NVMe PCIe x4 dénommé Polaris (comme la nouvelle architecture AMD) et qui équipe deux nouveaux SSD professionnels au format M.2, les SM961 et PM961.


Le SM961 utilise de la V-NAND MLC et peut atteindre 3200/1800 Mo /s en lecture/écriture séquentielle et 450K/400K IOPS en lecture/écriture aléatoire 4K. Le PM961 est associé à de la V-NAND TLC et peut atteindre 3000/1150 Mo /s et 360K/280K IOPS. A titre de comparaison le contrôleur précédent Samsung UBX associé à de la V-NAND MLC permettait au Samsung 950 Pro d'atteindre 2500/1500 Mo /s et 300K/110K IOPS. Alors qu'UBX intégrait 3 coeurs Polaris passe à 5 coeurs, Samsung en a également probablement profité pour utiliser un process plus fin (32nm pour UBX). Au passage la capacité maximale de ces SSD M.2 passe à 1 To contre 512 Go pour le 950 Pro. Il est probable que ces SM961 et PM961 servent de base à de futurs "960 et 960 Pro".
Autre nouveauté intéressante, le PM971 qui intègre au sein d'un même packaging BGA jusqu'à 512 Go de V-NAND MLC et un contrôleur PCIe x2 dénommé Photon. Avoir un SSD à ce format n'est pas une première mais la capacité et les performances sont cette fois impressionnantes vu le format : 1500/600 Mo /s en séquentiel et 190K/150K IOPS en aléatoire !
L'EUV possiblement pour le 7nm ?
Le site SemiWiki nous rapporte quelques informations sur l'état de la fabrication EUV, en provenance de la conférence SPIE Advanced Lithography qui se tient actuellement à San José.
Lors de la même conférence l'année dernière, les nouvelles étaient pour rappel plutôt bonnes (voir le lien pour un rappel complet sur la fabrication des processeurs et l'importance capitale de l'EUV !) et l'on espérait une introduction en cours de process pour le 10nm, et une introduction complète à 7nm. Malheureusement, on le rappelait en janvier, TSMC avait calmé les ardeurs en indiquant qu'il faudrait attendre le 5nm pour une éventuelle introduction de cette technologie.
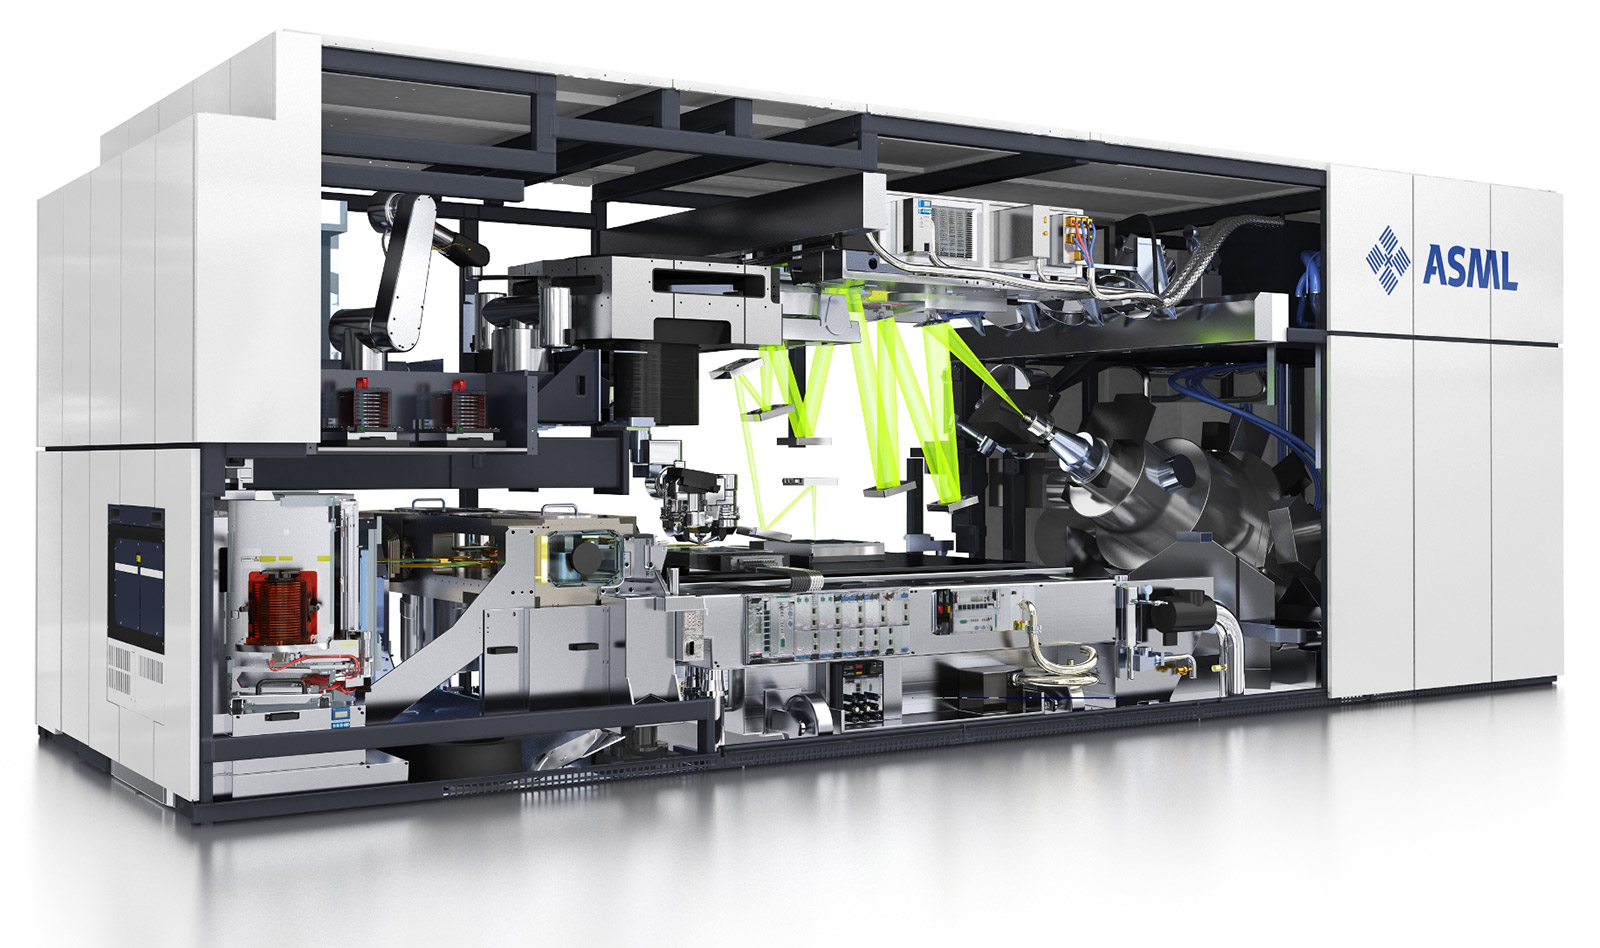
SemiWiki confirme certains chiffres donnés lors de la dernière conférence aux investisseurs de TSMC, à savoir que la machine avait atteint sur une période de quatre semaines une production de 518 wafers/jour, un niveau encore largement insuffisant. Intel a partagé également quelques chiffres, un peu inférieurs à ceux de TSMC, à savoir entre 2000 et 3000 wafers par semaine (285-428 par jour).
On notera quand même que le taux de disponibilité des scanners de la société ASML a augmenté, passant de 55 à 70% chez TSMC (Intel rapportant une disponibilité identique) ! On notera que s'il est question d'une introduction en début de node à 5nm, TSMC laisse la porte ouverte pour le 7nm si jamais des progrès étaient effectués. Intel de son côté n'a pas donné d'information. Samsung envisagerait l'introduction à 7nm selon les présentations, sans plus de précisions.
Si la question de la disponibilité est importante, celle de la puissance de la source lumineuse l'est encore plus. Après avoir été limité à 40 watts l'année dernière, les machines actuellement en évaluation chez TSMC disposent désormais de sources 80 watts. C'est mieux, mais cela reste loin des 250 watts promis par ASML pour fin 2015. Les dernières prédictions sont désormais de 250 watts en 2016-2017, et au delà en 2018-2019, des plages particulièrement larges.
Atteindre les 250 watts de puissance permettrait d'augmenter significativement la cadence de production, atteignant 170 wafers/heure en théorie. ASML a effectué des démonstrations que TSMC et Intel semblent juger prometteuses de 185 et 200 watts. Reste à les voir en production, bien évidemment. Les challenges de cette technologie restent complexes et ne se limitent pas à ces deux points cruciaux, la question des défauts dans les masques est elle aussi importante même si là aussi TSMC et Intel ont visiblement noté quelques progrès. Vous pouvez retrouver plus de détails sur ces points dans l'article de SemiWiki .
L'ITRS prépare l'après loi de Moore
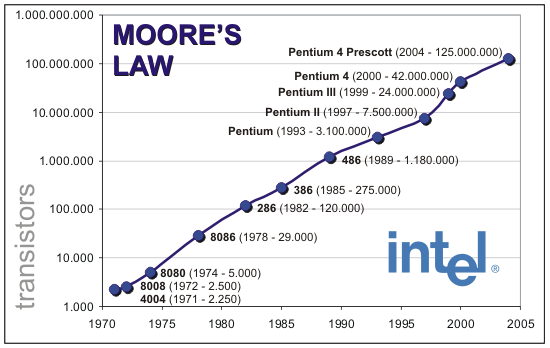
C'est la section actualité de la très sérieuse revue scientifique Nature qui l'affirme : la loi de Moore est arrivée à son terme. Énoncée en 1965 par Gordon Moore, l'un des cofondateurs d'Intel, il s'agit d'une observation par laquelle la quantité de transistors dans les circuits intégrés doublait à peu près tous les ans. Une observation transformée en loi pour prédire que cette cadence pouvait être extrapolée pour les années à venir.
En 1975, la loi avait été révisée pour prendre la forme que l'on connaît actuellement, à savoir un doublement des transistors tous les deux ans. L'importance de la loi de Moore allait cependant au-delà de la simple prédiction puisqu'elle prenait en compte les coûts de fabrication : l'observation se fait sur les puces ayant le coût par transistor le plus faible (tentant donc de prendre en compte les questions de yields et de défauts en fonction de la taille des puces).
Plus qu'une prédiction, la loi de Moore a servie, particulièrement chez Intel, de guide au fil des années, prédisant à l'avance les budgets en nombre de transistors alloués aux ingénieurs, et poussant vers l'avant la nécessité d'investir dans de nouveaux process de fabrications, la fameuse stratégie du Tick-Tock poussée d'abord en interne par Pat Gelsinger au début des années 2000 avant d'être utilisée publiquement pour décrire les générations à venir.
De manière intéressante, au-delà d'Intel, c'est toute l'industrie du semi-conducteur qui s'est mise d'accord autour de la loi de Moore, à savoir non seulement les fondeurs, mais aussi et surtout les fournisseurs d'outils. Le besoin de coordination entre tous les acteurs aura conduit à l'élaboration d'une roadmap, d'abord appelée National Technology Roadmap for Semiconductors dès 1993, avant d'être renommée sous sa forme actuelle, l'International Technology Roadmap for Semiconductors (ITRS).
Le rôle joué par cette roadmap, dont la dernière version a été publiée en 2013 aura été particulièrement important ces dernières années où, passé le 90nm, les challenges techniques ont contraint à des changements d'approches importants. L'augmentation des performances par la fréquence, méthode classique aura atteint un plateau à cause de l'augmentation de la consommation, poussant dans le commerce les stratégies de multiplication des coeurs que l'on connaît. Le rôle de la roadmap, au-delà de la concertation, est de s'assurer de trouver des pistes pour continuer la cadence de réduction des coûts/augmentation des transistors de la loi de Moore.
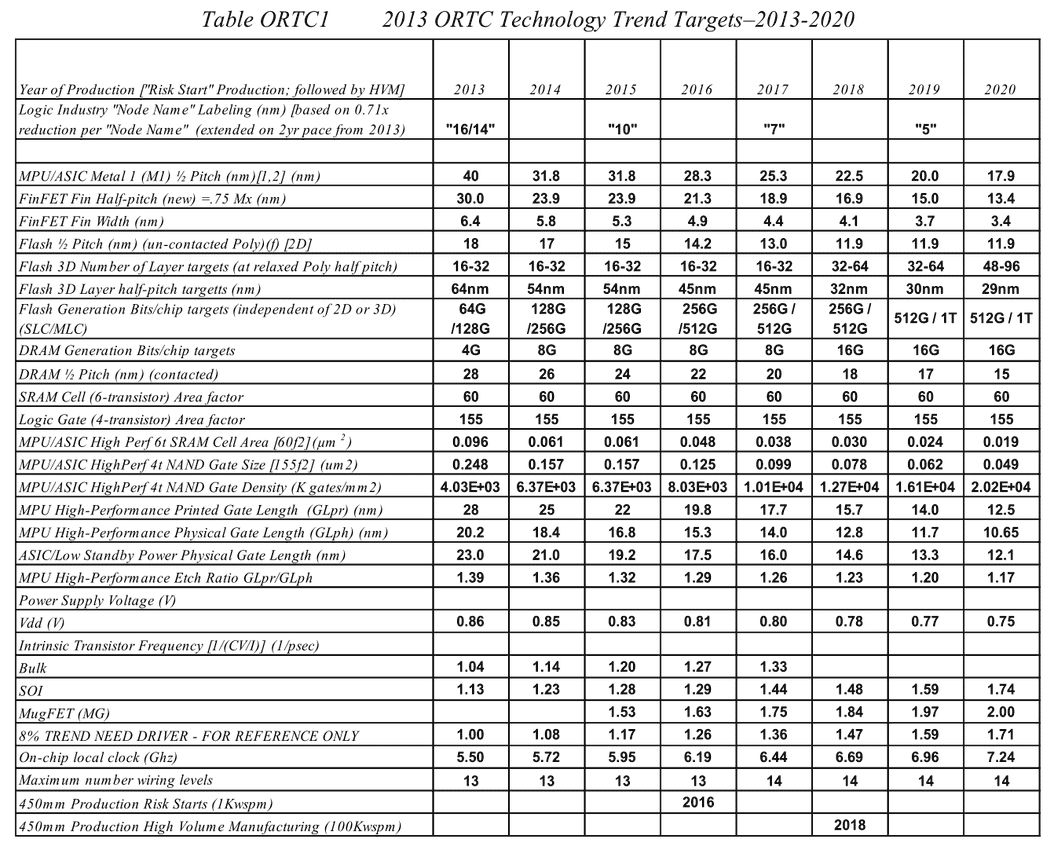
La dernière roadmap ci-dessus donnait des grandes lignes sur la manière de mettre à l'échelle les différents composants des transistors. Après les difficultés autour du 90nm, l'industrie est passé progressivement de la règle dite de la mise à l'échelle géométrique (on réduit tout dans des proportions identiques, le nom du node indiquant en général la taille de la porte) à celle de la mise à échelle par équivalence (equivalent scaling).
Etant donné que différentes parties composant les puces posent des problèmes différents, des règles d'équivalences ont été mises au point pour permettre de continuer a atteindre les buts de réduction des coûts/augmentation de densité imposé par la loi de Moore (on peut voir sur le tableau la couche d'interconnexion M1 et l'écart minimal entre deux transistors FinFET, en passant par des estimations des tailles de blocs fondamentaux comme la SRAM).
Pour 2016, la roadmap annonçait par exemple de la SRAM 6 transistors (6T) haute performance en 10nm autour de 0.048 µm2, ce qui n'est pas très éloigné de ce que présentait Samsung il y a une dizaine de jours de cela. En pratique cependant, on notera qu'on est globalement assez en retard sur la roadmap qui prévoyait des débuts de production à petite échelle en 10nm en 2015 (Risk Start dans la roadmap, suivi de HVM, fabrication en volume). Chez TSMC par exemple, la production risque est prévue pour la fin 2016 avec une production en volume pour 2017. Intel prévoit ses puces en volume pour 2017 également.
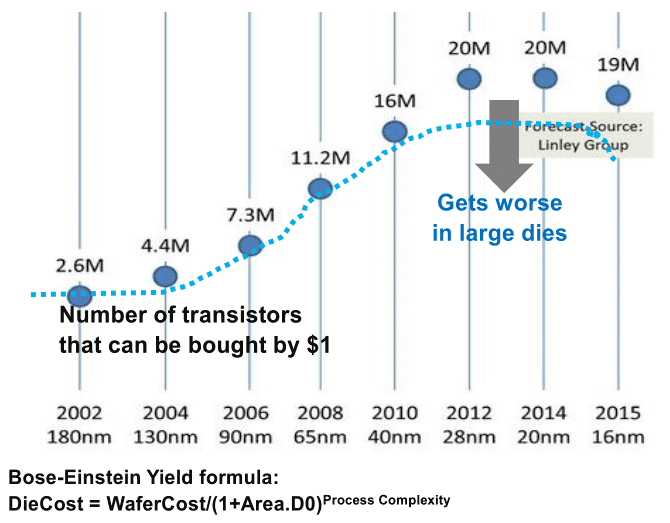
Évidemment depuis 2013 les choses se sont un peu plus compliquées et l'absence de roadmap en provenance de l'ITRS n'a pas forcément aidé. En pratique, la réduction des coûts s'est arrêtée, avec même un retour en arrière à 16nm signant de facto la fin de la loi de Moore, comme on peut le voir sur cette estimation ci-dessus tirée d'une présentation de l'ITRS en février 2015.
L'absence de nouvelle roadmap en provenance de l'ITRS aura même donné lieu à des divergences d'interprétations fortes, Intel titillant ses concurrents sur la question de la densité théorique. TSMC et Samsung ont fait pour rappel le choix de conserver un BEOL (Back End of Line, la partie basse d'une puce qui sert à l'interconnexion des transistors) commun entre le 20 et le 16nm pour accélérer la cadence de mise en production. En pratique chez TSMC, malgré le BEOL commun, le half pitch M1 reste tout de même dans les clous à 32nm (entre 40 et 31.8 sur la roadmap).
La densité pratique reste de toute manière très différente de ce que peuvent proposer des formules grossières comme celle utilisée par Intel (qui multipliait le pitch M1 par le pitch entre deux portes), qui pour exploiter les FinFET aura fait le choix d'utiliser pour certains de ses transistors critiques des structures plus larges composées de plusieurs fins (dans des proportions non négligeables même si la proportion exacte est rarement évoquée de manière précise par Intel).
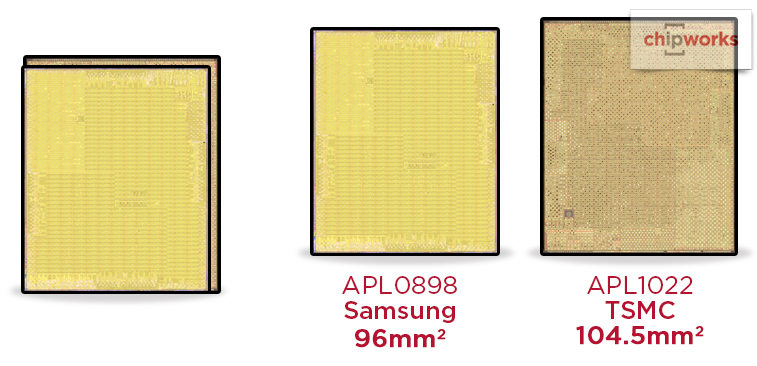
Cumulé a de multiples autres détails (différents types de blocs sont présents avec des densités différentes, de la SRAM aux blocs plus ou moins critiques) il est impossible de tirer grand-chose de la théorie. L'écart entre un Core M Broadwell 14nm fabriqué par Intel (82mm2 pour 1.3 milliards de transistors) et un A8 fabriqué par TSMC en 20nm (89 mm2 pour 2 milliards de transistors) montre qu'il est difficile de comparer quoique ce soit à moins de prendre deux puces strictement identiques. Cela aura été possible pour l'A9 d'Apple, dont la superficie atteint 96mm2 chez Samsung contre 104.5mm2 chez TSMC.
Le mois prochain, l'ITRS devrait donc enfin communiquer une nouvelle roadmap qui d'après Nature tirera définitivement un trait sur la question de la loi de Moore comme moteur d'évolution unique. D'après Nature, la prochaine roadmap se concentrera sur les applications pratiques, allant du smartphones aux puces serveurs et regardera les applications pratiques, que ce soit au niveau circuits d'alimentations, des capteurs nécessaires, ou d'autres blocs de siliciums répondant à des besoins particuliers.
La véritable question est de savoir ce que comportera réellement cette roadmap qui serait rebaptisée d'après Nature International Roadmap for Devices and Systems, abandonnant même le mot transistor !
Ce que l'on sait, c'est que la réorganisation de l'ITRS en 2014 s'est faite autour de groupes de travaux, avec notamment un groupe baptisé « More Moore » pour évoquer les pistes techniques pour les prochains nodes, dont vous pouvez retrouver ci-dessous la dernière présentation datant de février 2015.
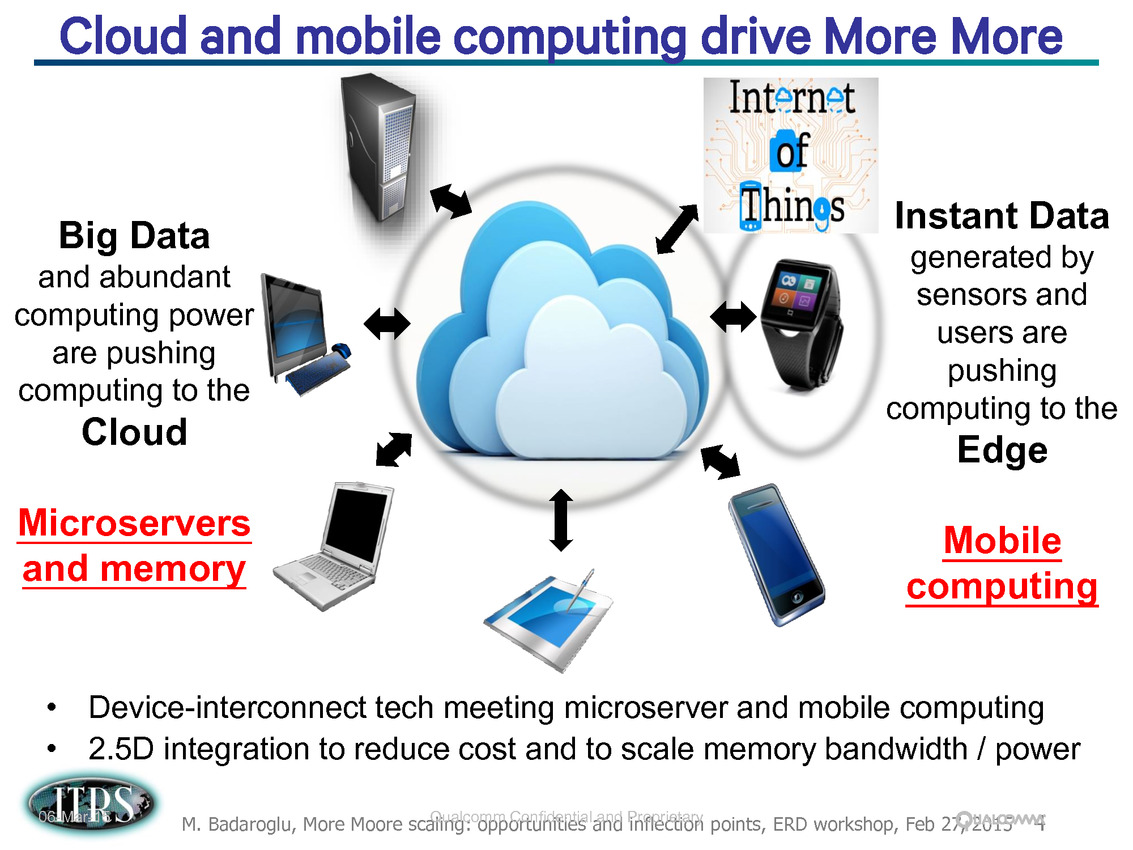
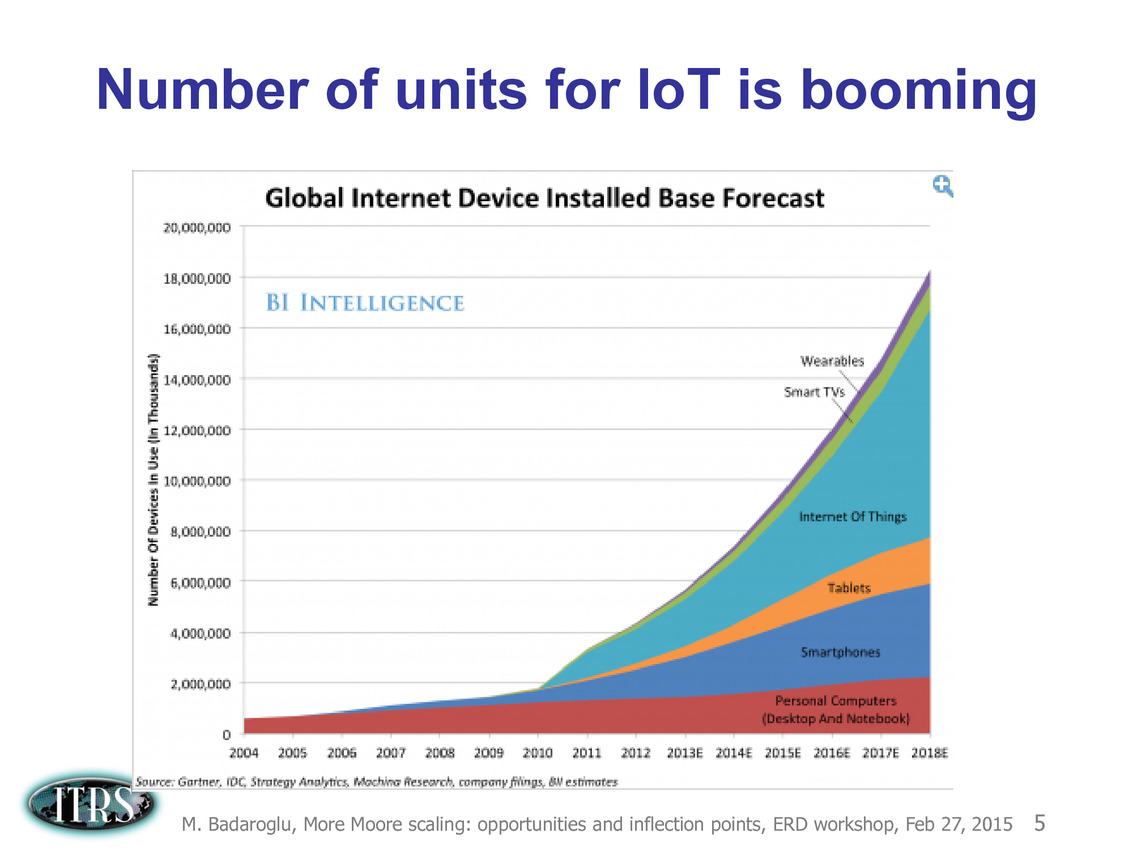
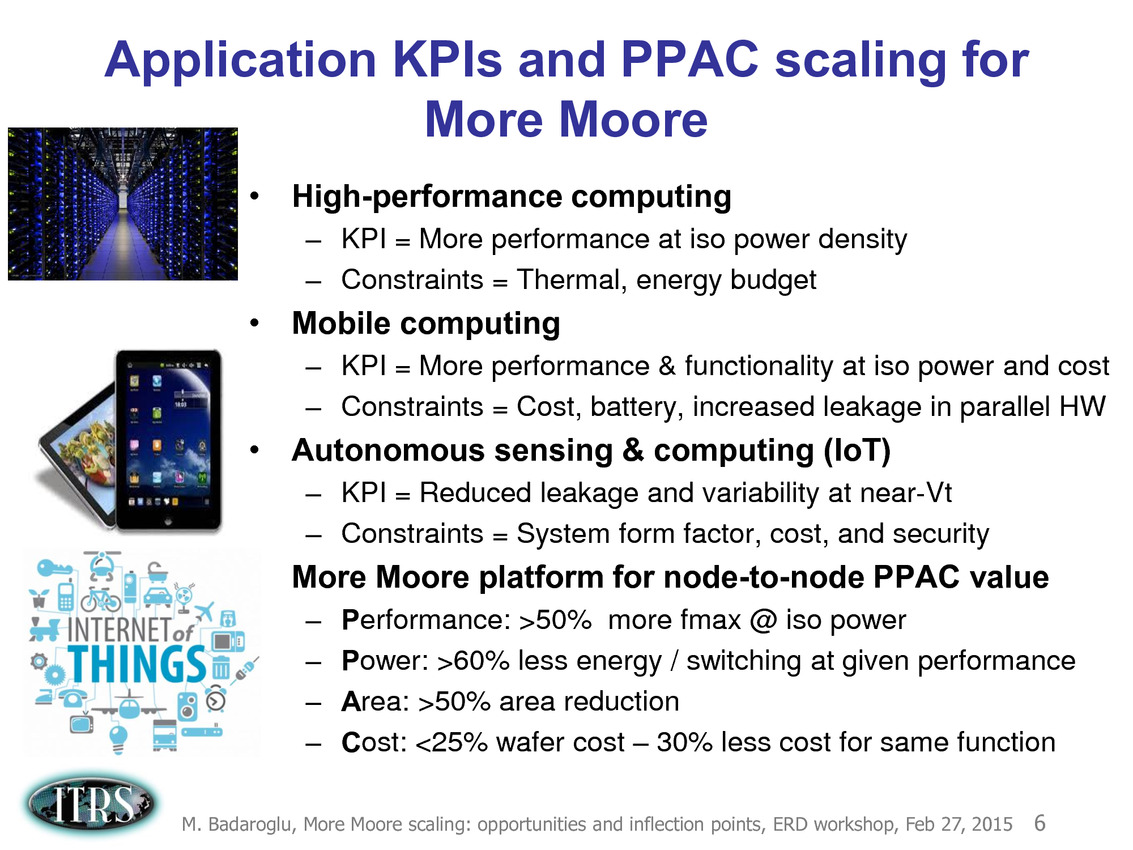
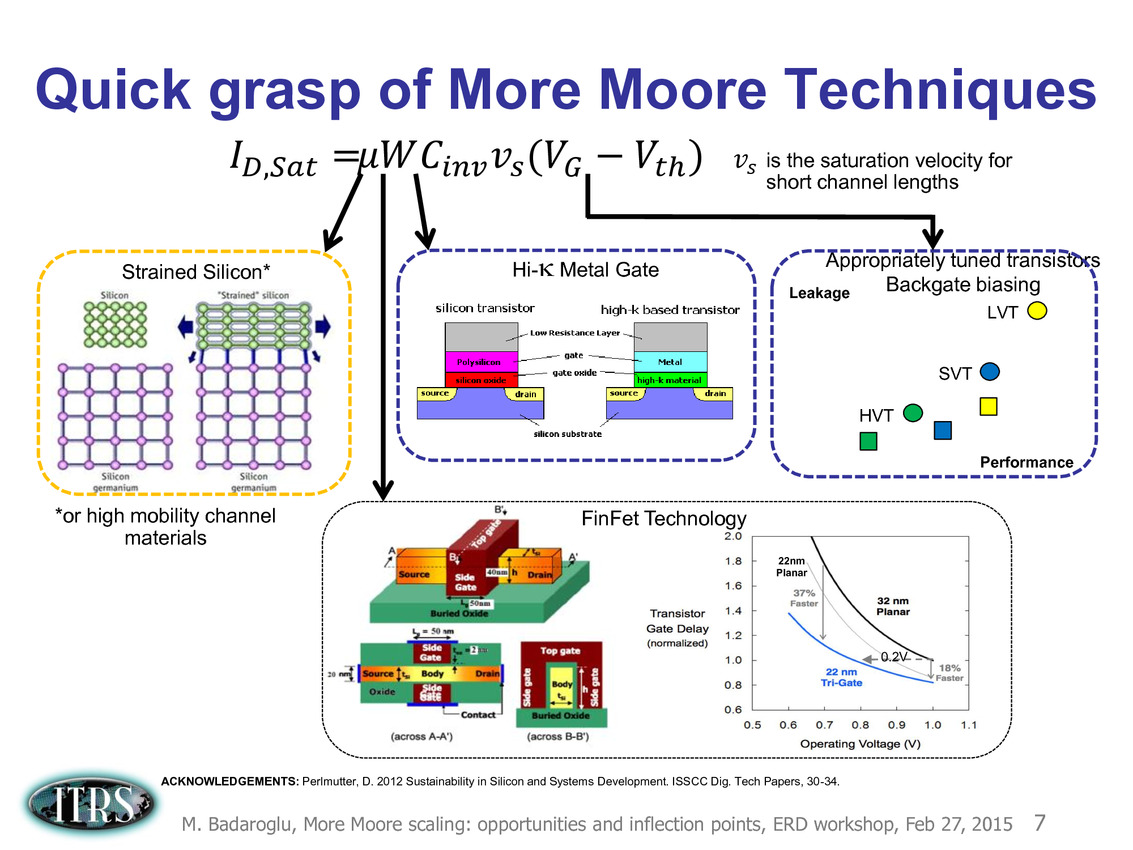
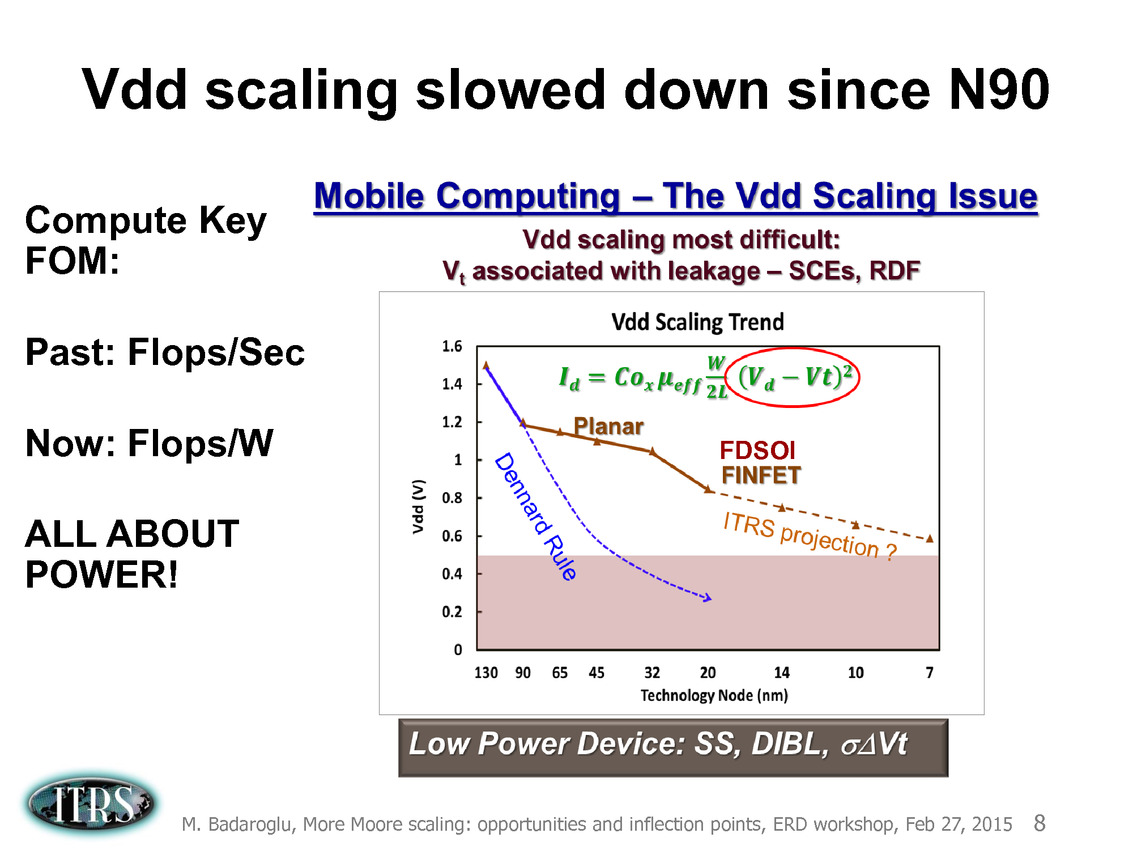
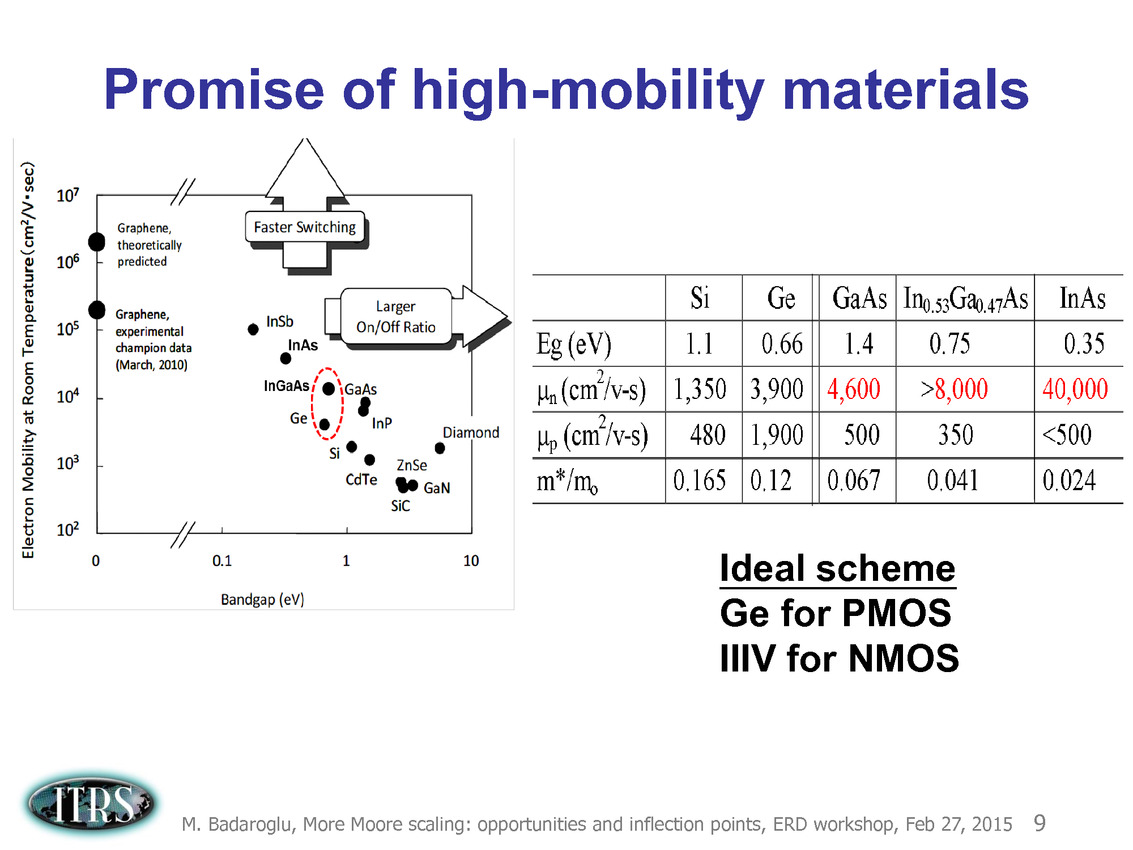
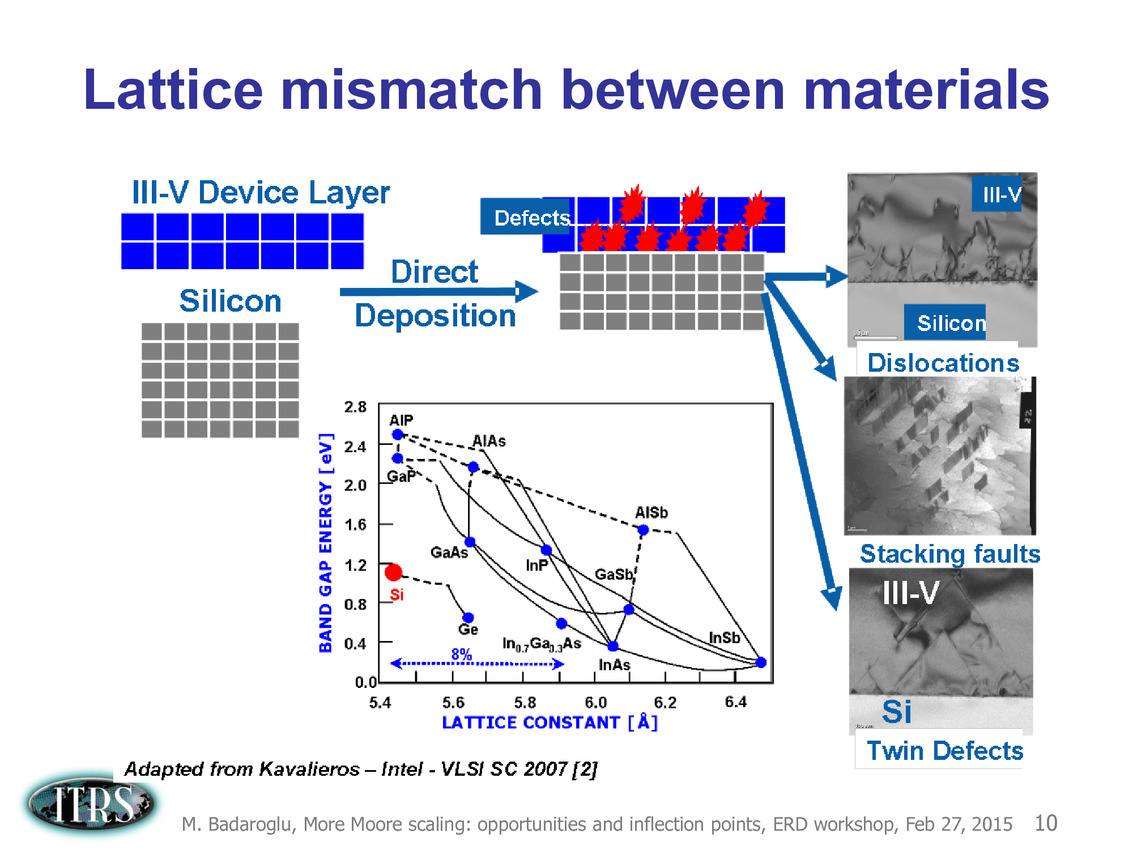
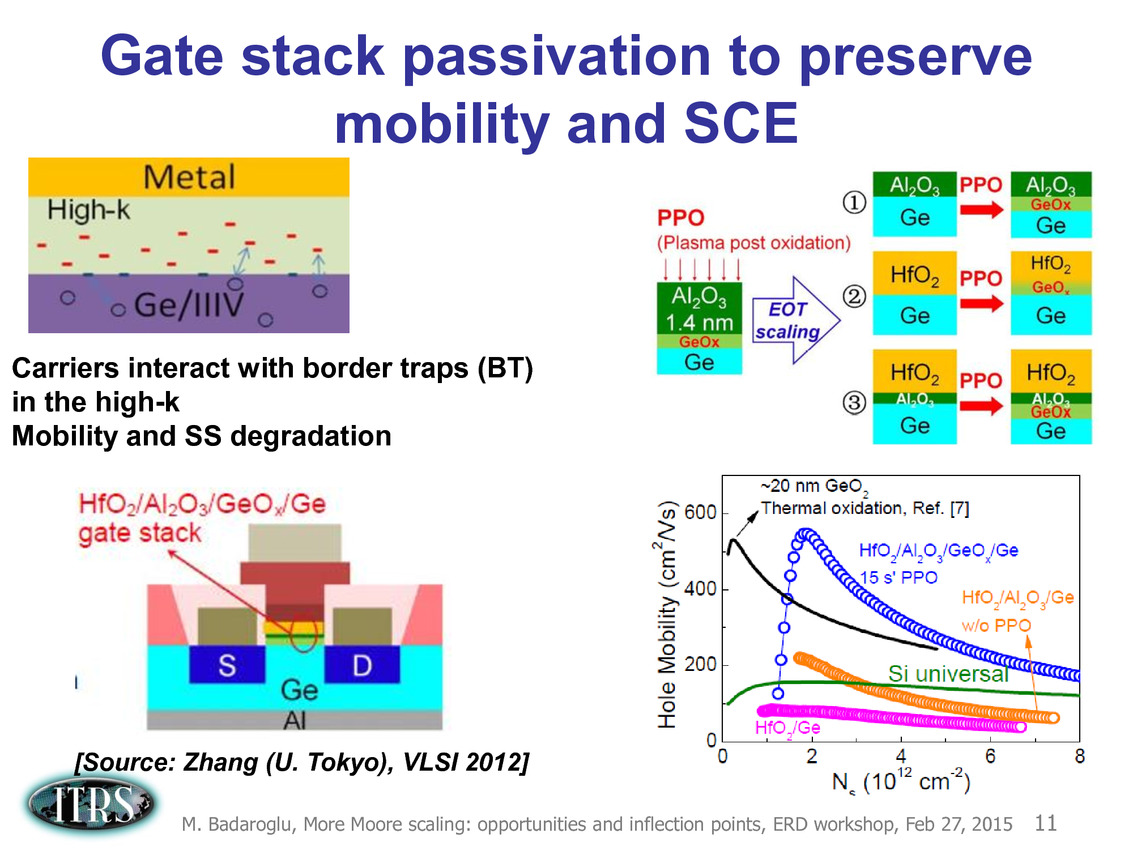
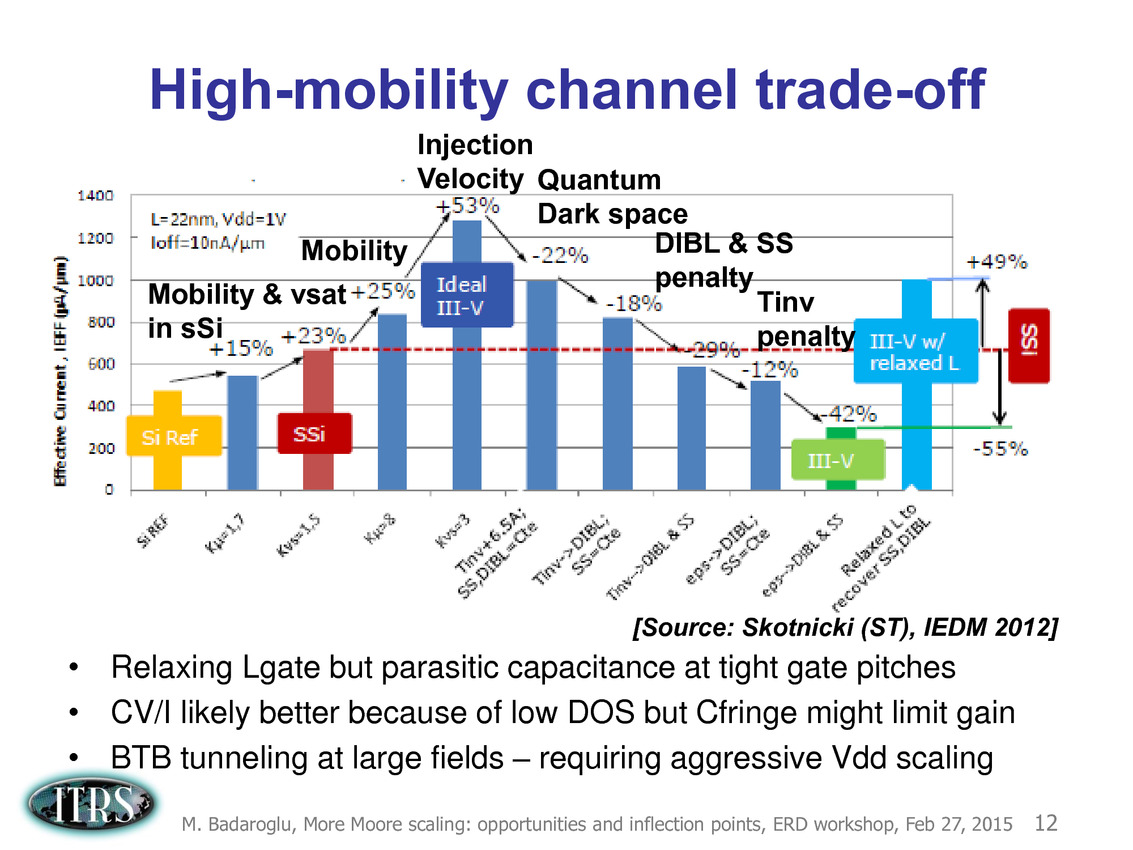
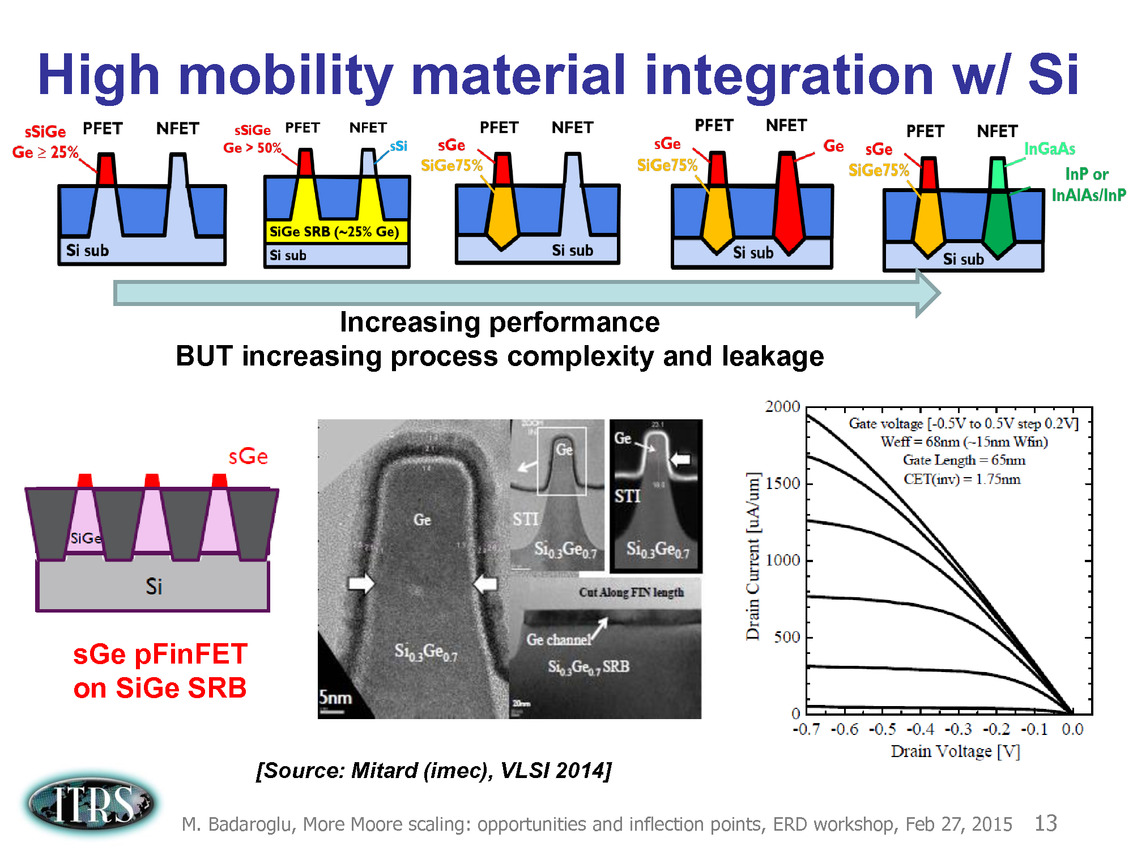
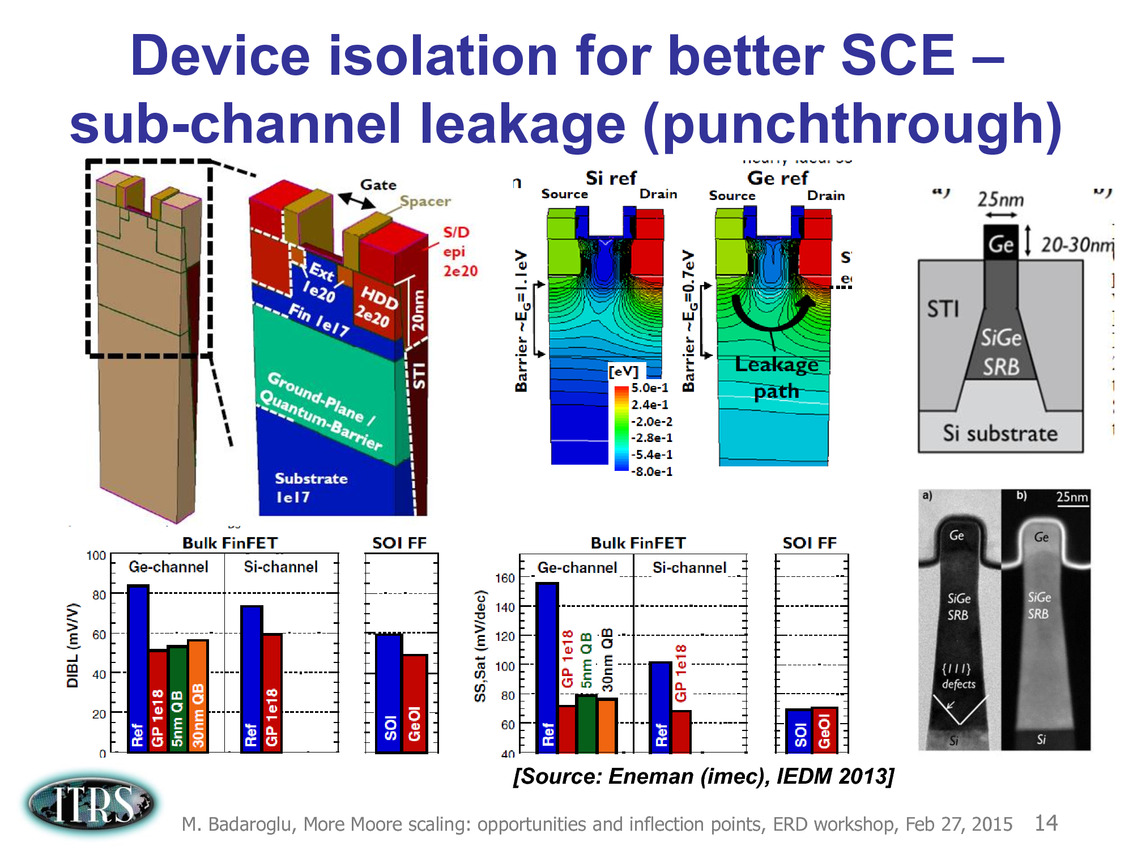
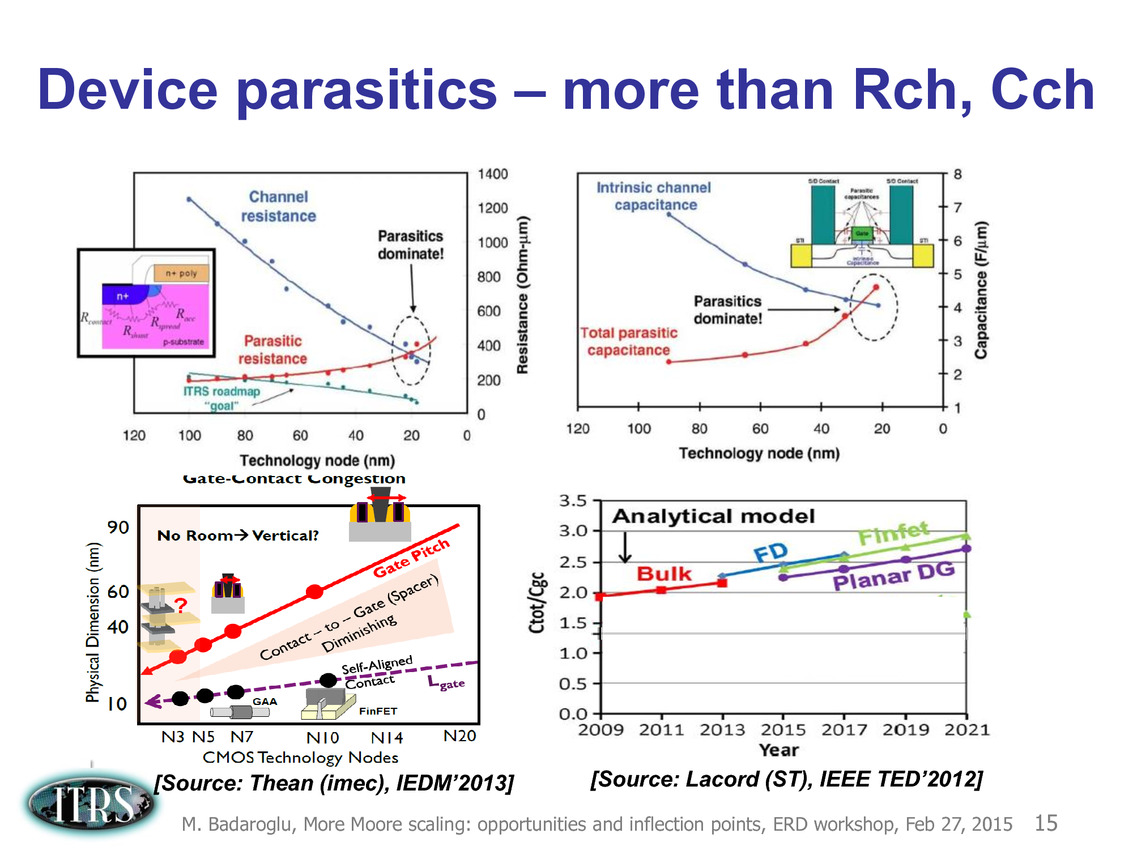
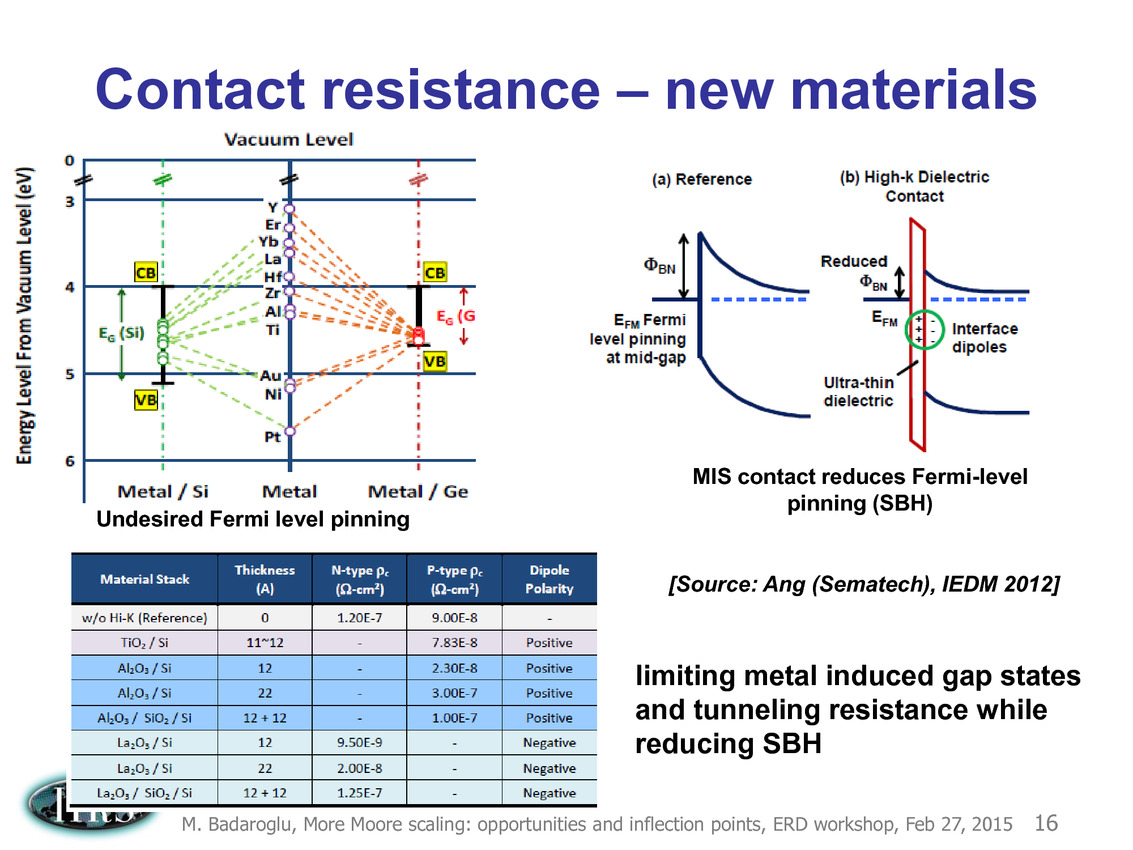
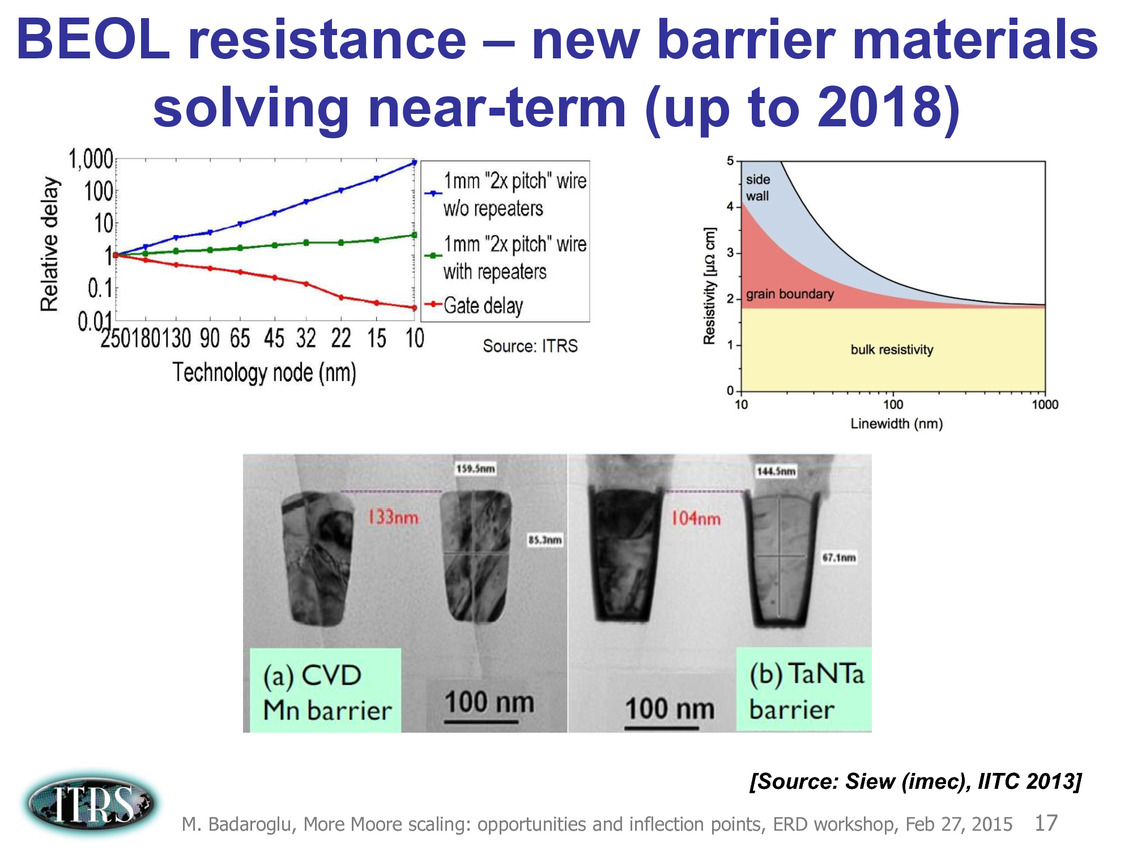
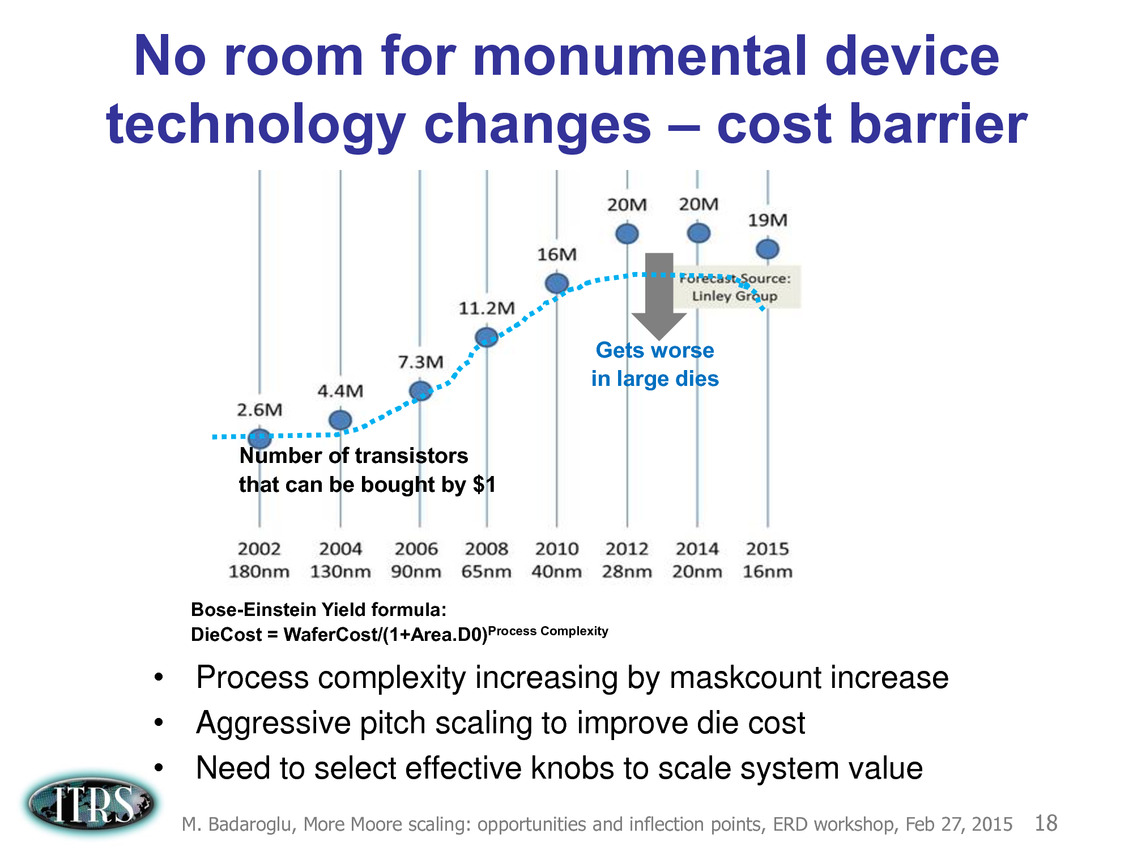
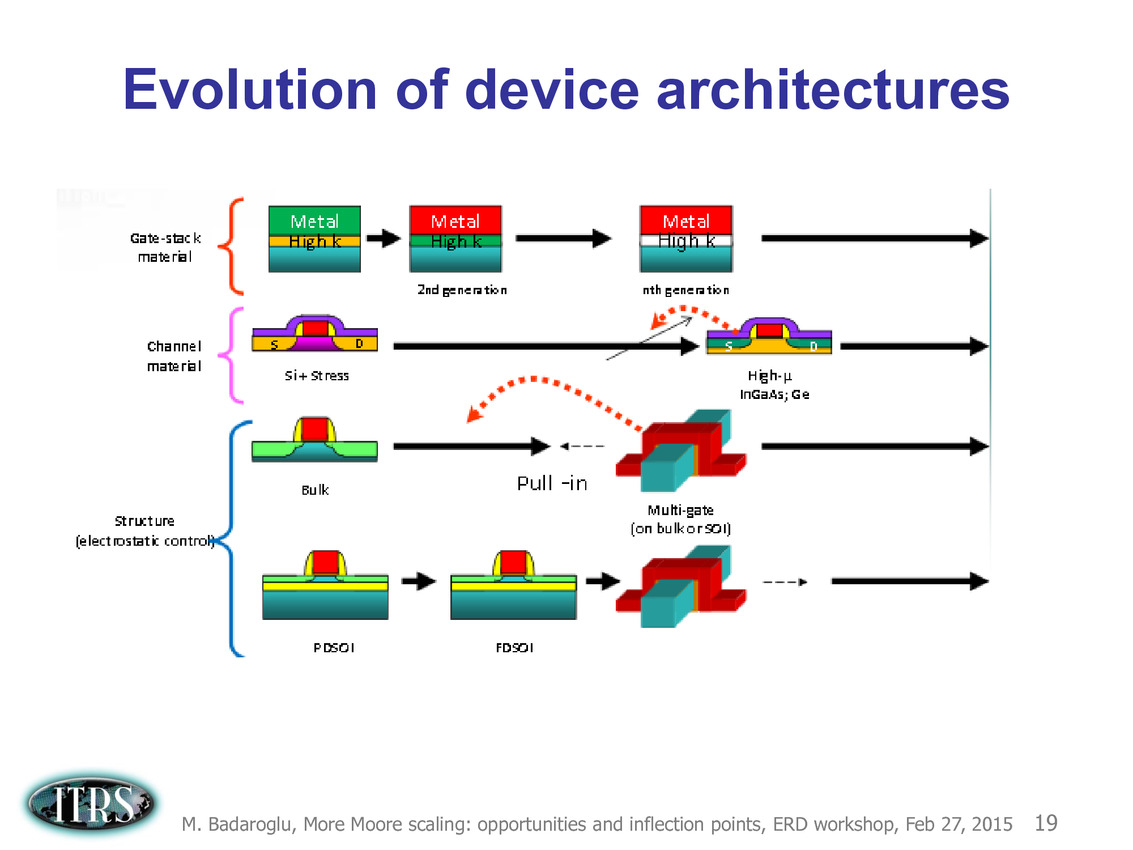
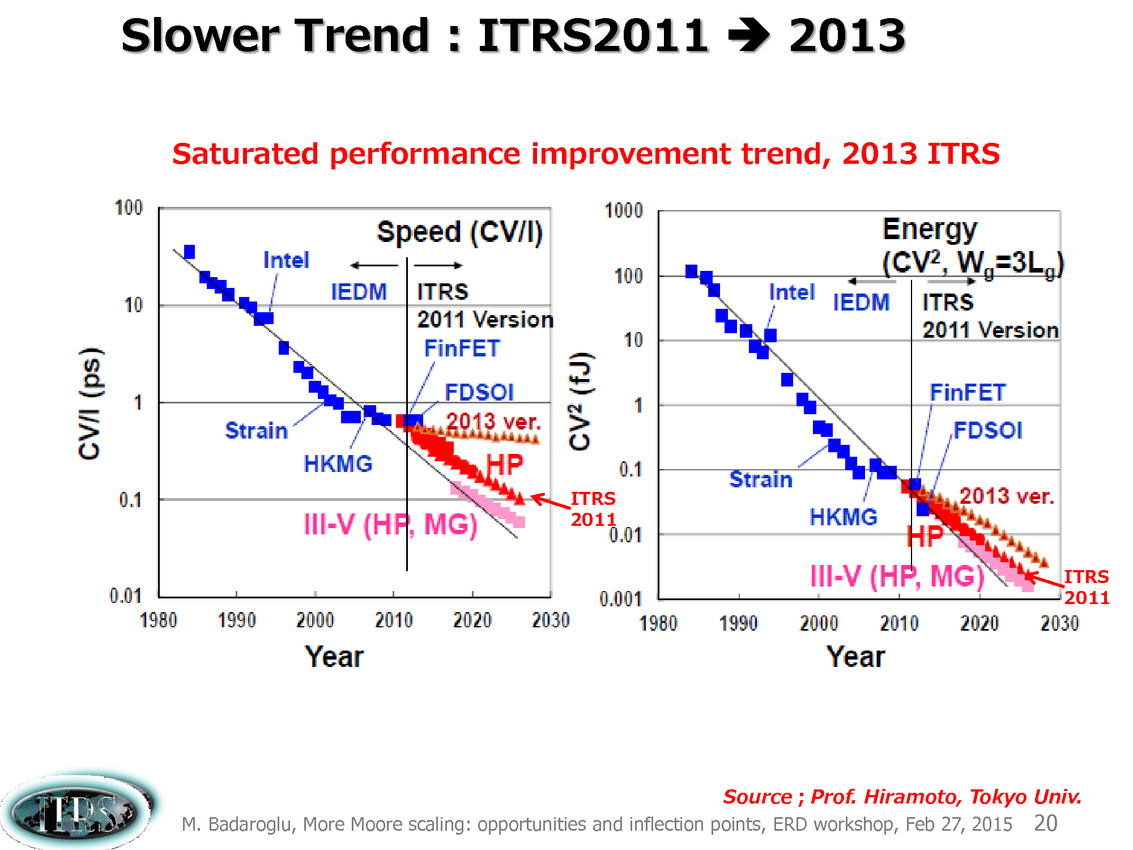
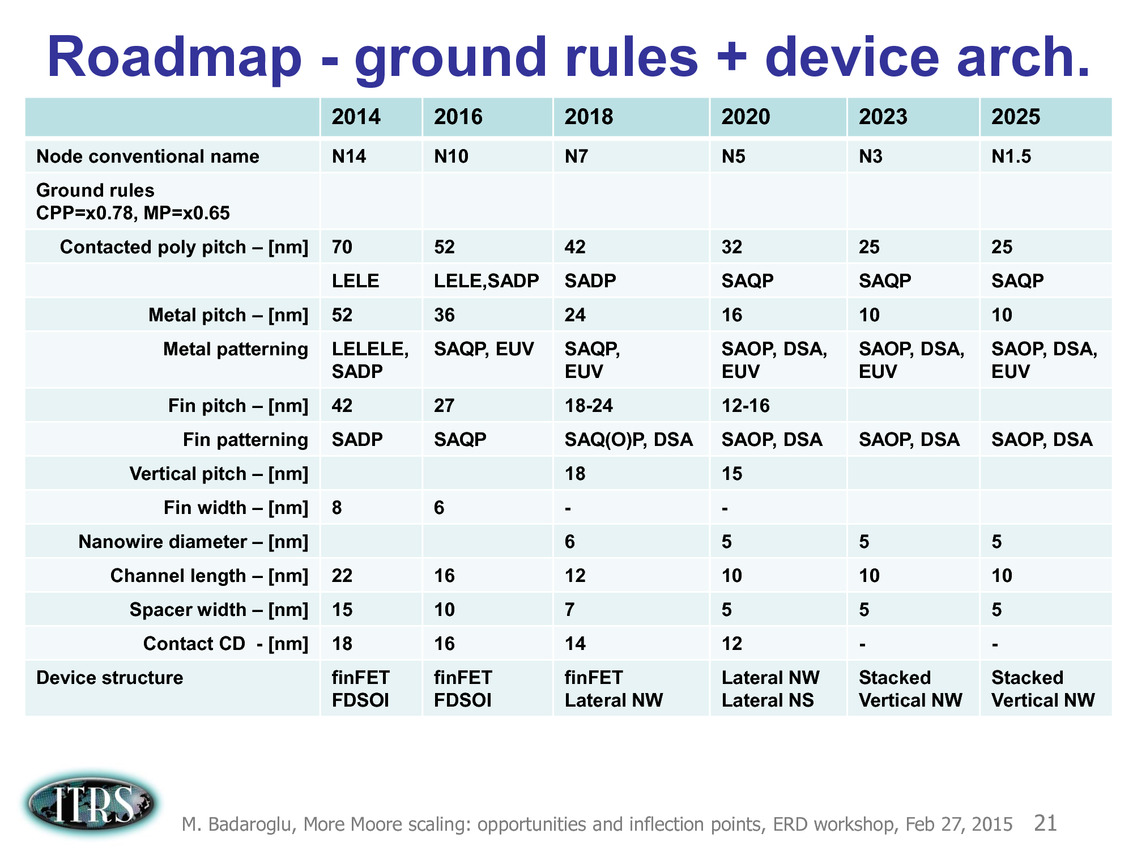
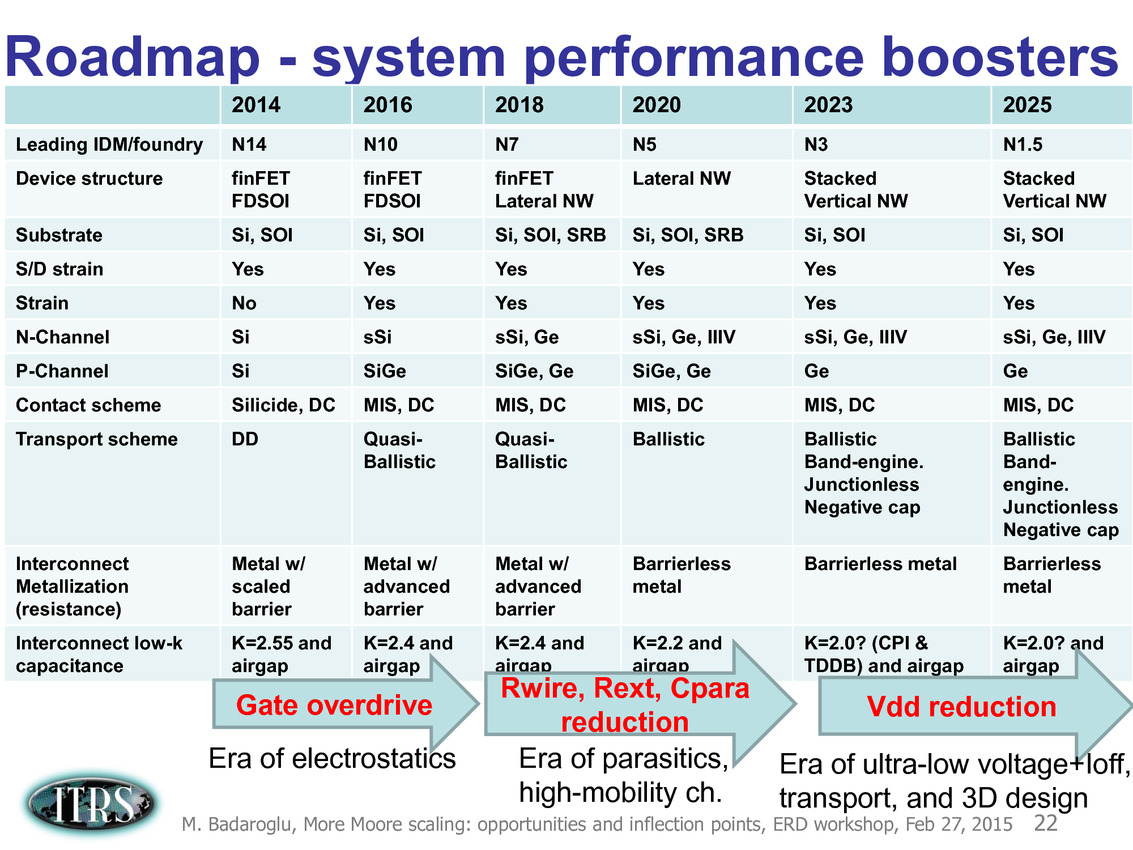
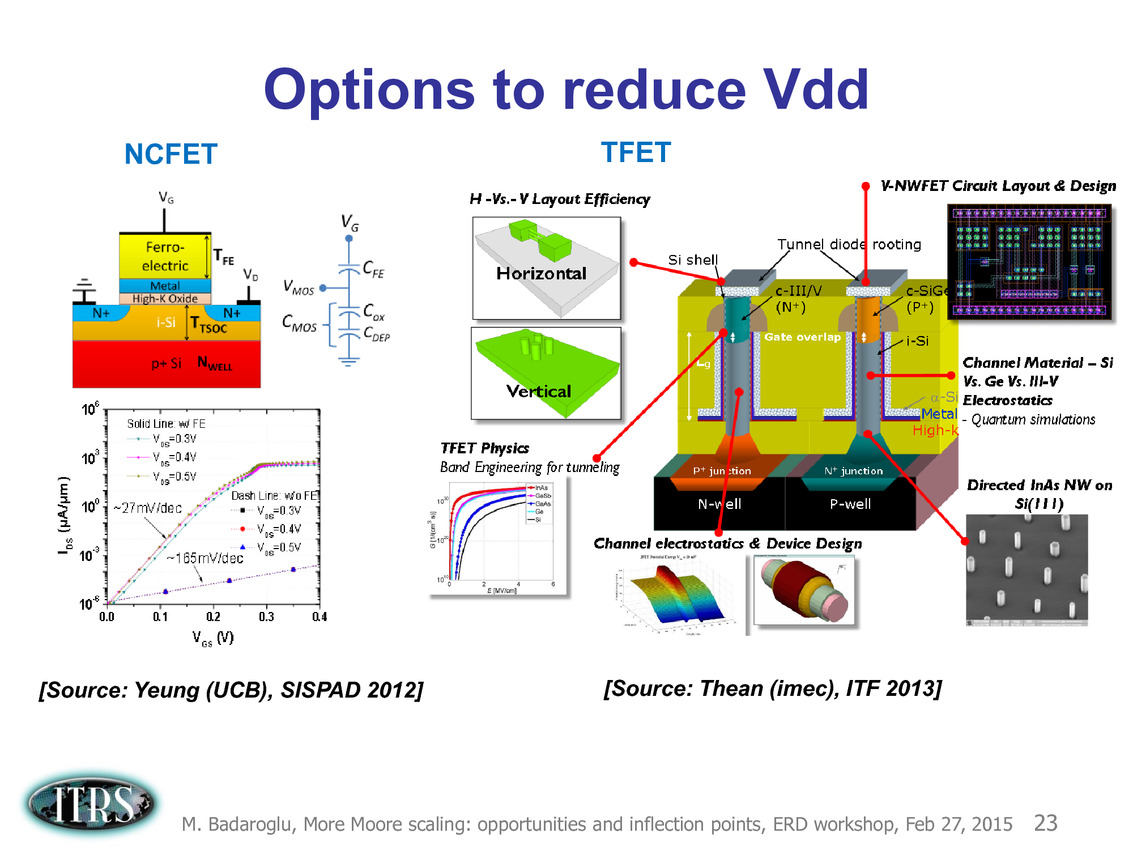
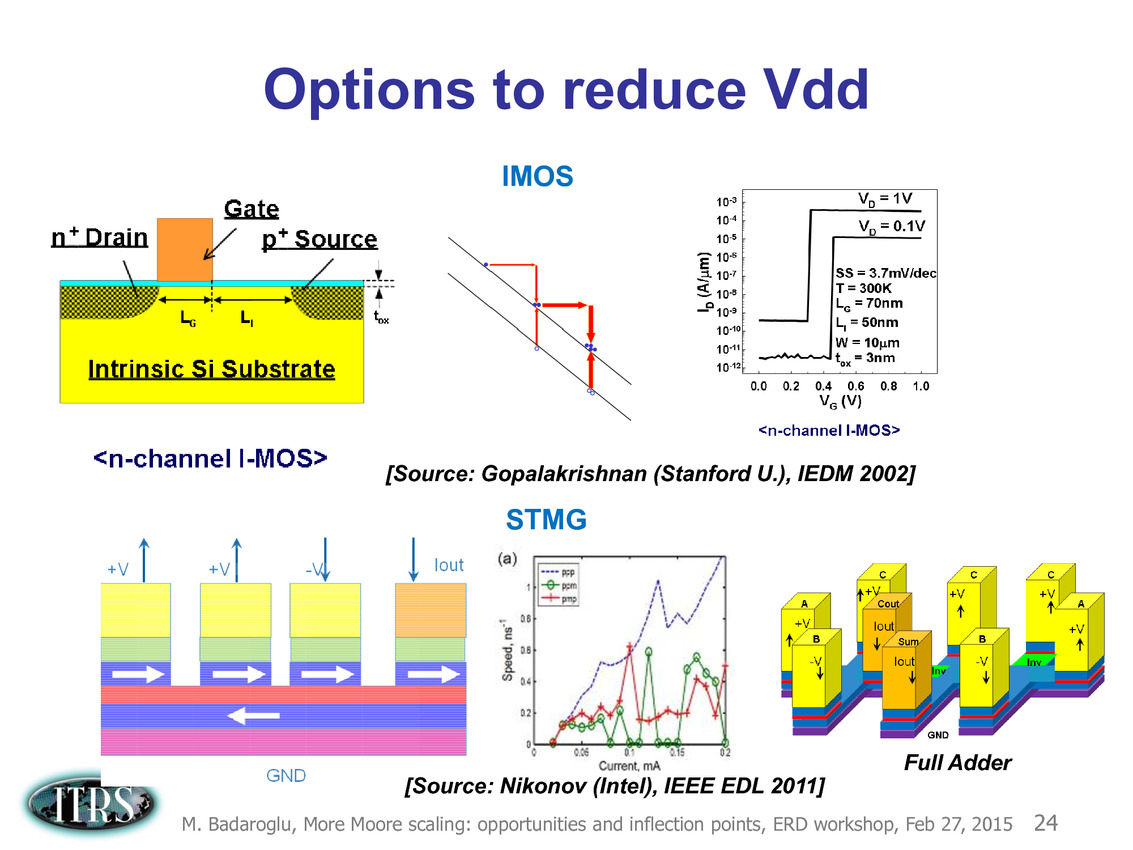
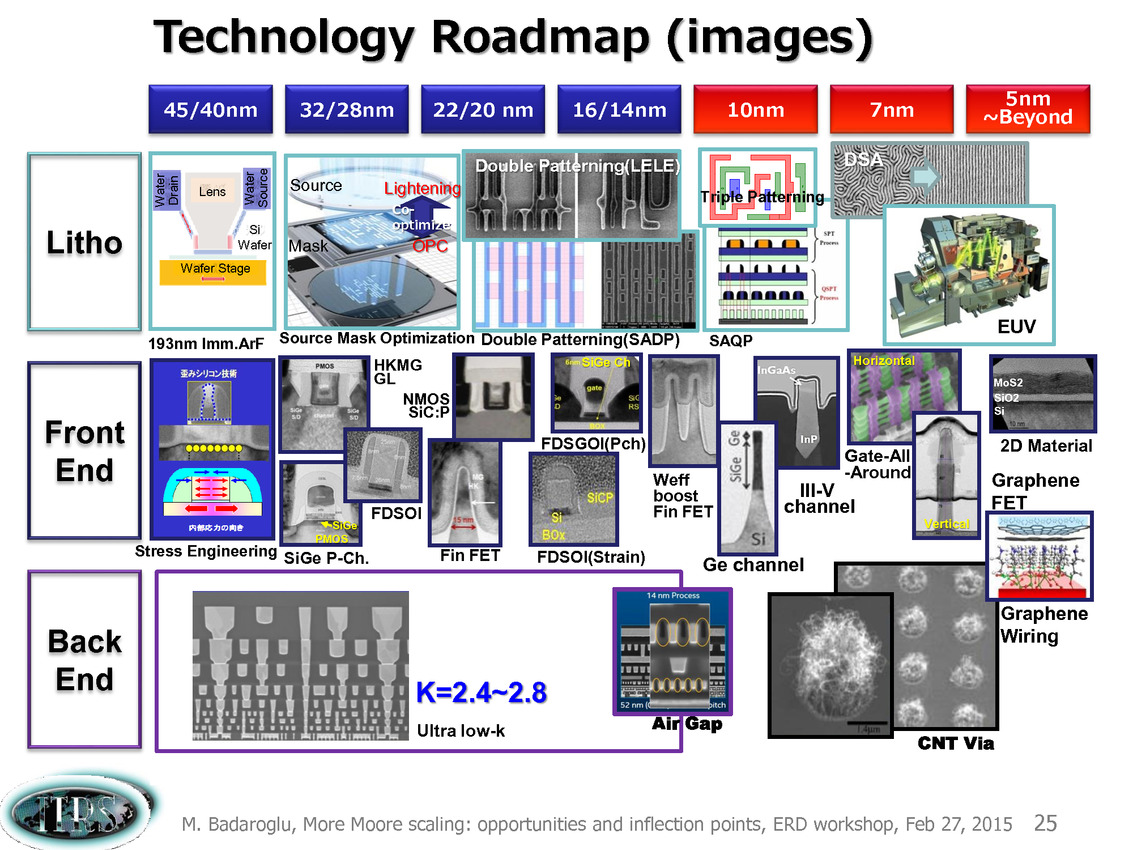
Une présentation intéressante qui évoque de multiples pistes et où l'on trouve un début de roadmap que nous avons remis ci-dessous :
En pratique, après l'ère de la mise à l'échelle géométrique, et l'ère des équivalences, l'ITRS évoque l'ère du "3D Power Scaling" dont les meilleurs représentants sont la NAND 3D ou des technologies comme la mémoire HBM. Des techniques complexes à appliquer aux puces logiques même si la présentation évoque quelques pistes et alternatives.
On attendra donc le mois prochain pour en savoir un peu plus !
Samsung présente sa SRAM 10nm
Lors de l'ISSCC (International Solid-State Circuits Conference), Samsung a été le seul a communiquer sur le 10nm via la présentation d'une puce de 16 Mo de SRAM gravée en 10nm FinFET de 75.6mm². Deux types de cellules ont été présentées, la première mesure 0,040 µm² et est optimisée pour la densité alors que l'autre de 0,049µm² cible le support d'une intensité plus importante.
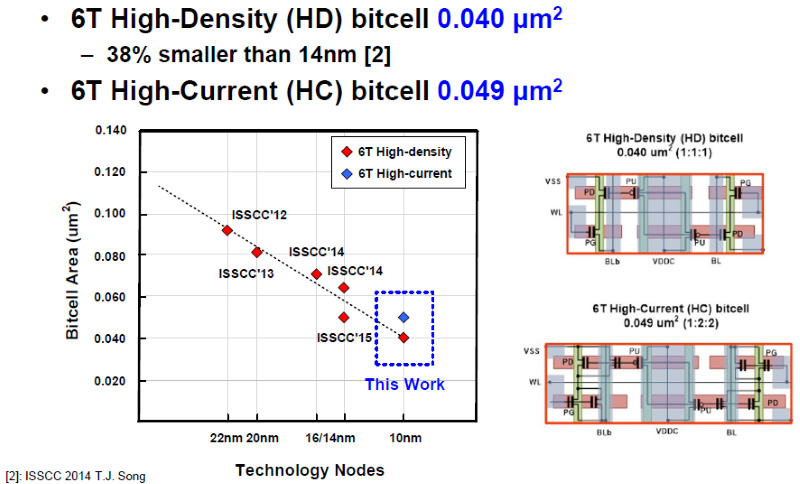
Lors de l'ISSCC 2014, Samsung avait présenté une cellule SRAM 14nm de 0,064 µm², la version 10nm fait donc au mieux 0,63x cette taille (TSMC est pour sa part à 0,07 µm² en 16nm). A titre de comparaison Intel avait présenté fin 2014 une première cellule SRAM 14nm de 0,0588 µm² avant de tomber à 0,050 µm² lors de l'ISSCC 2015 il y a un an. En 22nm Intel était à 0,092µm² sur une cellule optimisée pour la densité et à 0,108µm² sur celle optimisée pour le performance/puissance et utilisée dans les processeurs.
On peut donc s'attendre à ce qu'en 10nm Intel soit capable de produire des cellules de SRAM nettement plus petites que celles de Samsung, preuve si il le fallait qu'il ne faut pas se baser uniquement sur la désignation du process… la taille de la SRAM n'étant pas non plus le seul facteur à prendre en compte. Samsung n'as pas donné de détail sur les gains en terme de consommation ou de vitesse sur ce 10nm qui devrait être produit en volume à partir de la fin de l'année.
La HBM2 4 Go Samsung en production
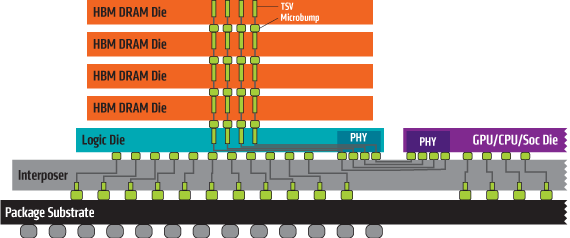
Samsung vient d'annoncer qu'il avait débuté la production en volume d'une puce HBM2 d'une capacité de 4 Go. Offrant une bande passante de 256 Go /s, elle est composée de 4 die de 1 Go empilés, chacun comprenant environ 5000 trous pour l'interconnexion via TSV. Par rapport à la HBM utilisée sur l'AMD Fury, la capacité est multipliée par 4 et la bande passante par 2. Le tout est gravé en process 20nm, Samsung indique qu'il devrait également produire une version 8 Go via 8 die empilés cette année.
 Les 5 contenus précédents

