

Actualités cartes graphiques
 Les 5 actualités précédentes
Nvidia lance le GeForce GTX 650 Ti Boost
Baisse pour les GeForce GTX 650, 650 Ti et 660
L'ASUS GTX 670 DirectCU Mini en photos
GeForce 314.22 WHQL pour BioShock Infinite
GTC: Les Tesla K20X dans le Piz Daint suisse

GDC: AMD, Intel, Nvidia, Qualcomm... à la GDC


Lors de la GDC, dont l'édition 2013 s'est terminée vendredi dernier à San Francisco, les plus importants fournisseurs de technologies graphiques (les GPU Radeon, Mali, PowerVR, HD Graphics, GeForce, Adreno) étaient présents avec notamment pour but de convaincre les développeurs de jeux vidéo d'exploiter toutes les possibilités de leurs produits récents à travers des techniques de rendu toujours plus évoluées que ce soit sur PC ou dans le monde mobile, qui progresse à vive allure.
En plus de diverses présentations, AMD, ARM, Imagination, Intel, Nvidia et Qualcomm étaient présents à travers des stands principalement exploités pour mettre en avant leurs outils maisons : AMD GPU PerfStudio, ARM Mali Graphics Debugger, Imagination PVRTune, Intel Graphics Performance Analyzers, Nvidia Nsight, Qualcomm Adreno Profiler…
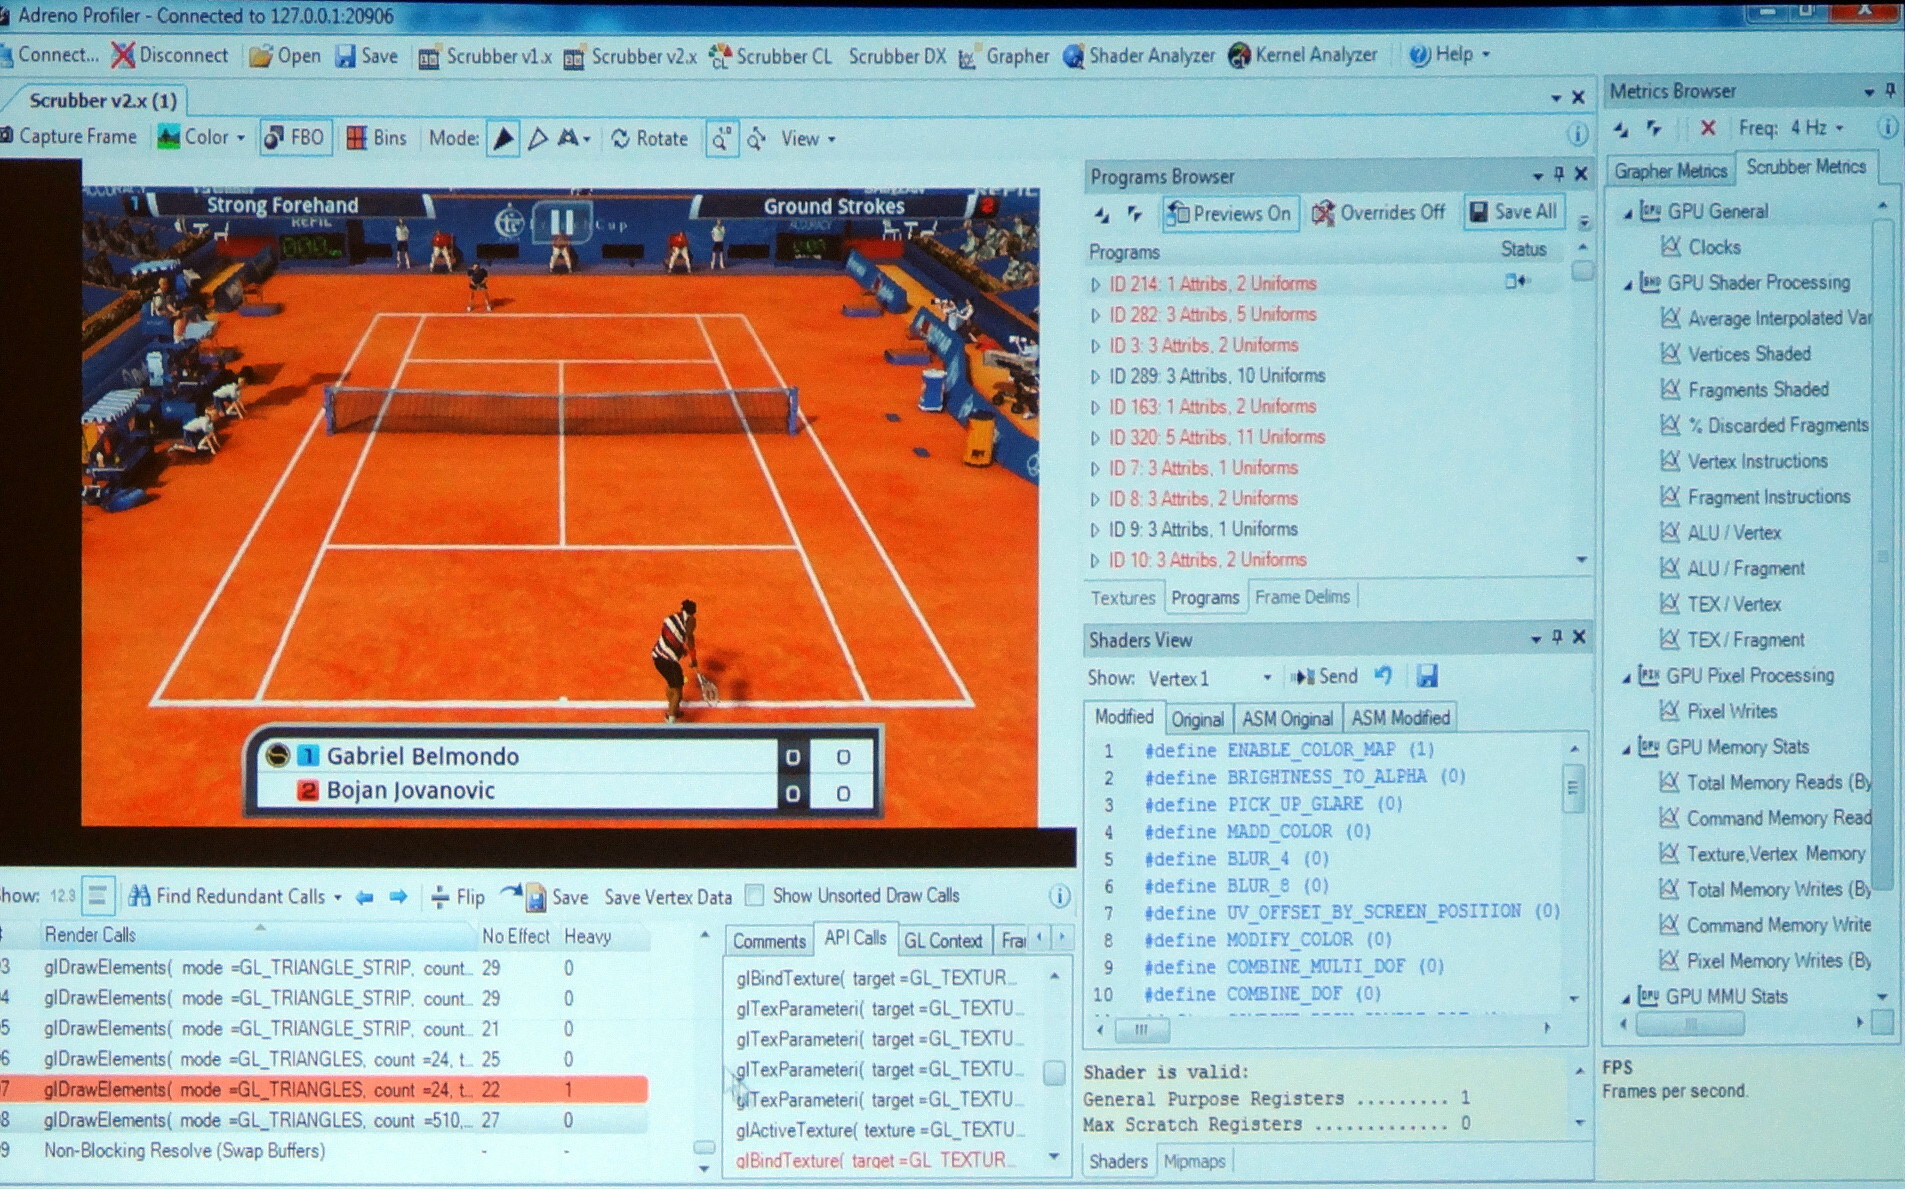
Ici en exemple, l'Adreno Profiler de Qualcomm qui permet d'observer assez facilement le comportement des GPU Adreno et d'appliquer des modifications à la volée pour identifier des bugs ou des goulots d'étranglement (bottlenecks). Il est ainsi possible de modifier un shader, de désactiver la synchronisation verticale, de réduire la taille de toutes les textures, etc., et d'observer l'impact en temps réel sur le smartphone ou sur la tablette.
Les outils de tous les acteurs cités proposent des possibilités similaires, chacun ayant des petits avantages ou inconvénients par rapport à la concurrence. Ils sont en général autant adapté au débogage et à l'optimisation de la partie graphique que de la partie "compute" éventuellement exposée pour les GPU.
Lors de plusieurs rencontres avec des développeurs, nous avons voulu savoir quels outils ils préféraient et pourquoi. La réponse de nos interlocuteurs a été unanime : aucun ! Pourquoi ? Tout simplement parce que la multiplication de ces outils devient problématique et que peu importe leurs qualités ou leurs défauts, devoir utiliser un outil spécifique à chaque marque de GPU est tout sauf pratique, d'autant plus quand il faut en supporter bon nombre comme c'est le cas sous Android.
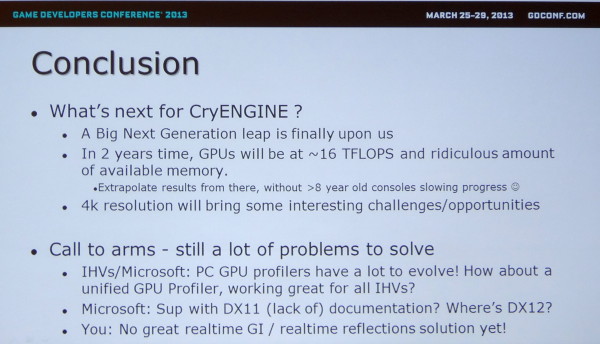
Même avec seulement 3 acteurs, c'est un problème dans le monde PC comme le rappelle Crytek en parlant des opportunités et défis à venir. Il serait ainsi intéressant que Microsoft et Google proposent des outils de développement plus évolués qu'actuellement et dans lesquels les concepteurs de GPU pourraient venir s'interfacer pour proposer autant de détails que dans leurs propres outils mais d'une manière plus ou moins unifiée.
Notez au passage que Crytek en profite pour rappeler à Microsoft qu'il serait peut-être bon de travailler sur la documentation de DirectX !
GDC: Intel PixelSync et InstantAccess
Intel profite de la GDC pour annoncer deux nouvelles extensions graphiques dédiées au GPU intégré des processeurs Core de 4ème génération (Haswell). Celles-ci permettent de passer outre les limitations des API graphiques et ont pour but de rendre l'utilisation du GPU plus efficace, principalement en économisant de la bande passante mémoire, une denrée rare pour les GPU intégrés.
PixelSync
La première technologie se nomme Pixel Shader Ordering, ou PixelSync en langage commercial. Elle permet de garantir l'ordre d'écriture en mémoire des pixels affectés par une transparence. Traditionnellement, ce sont les ROP qui s'en chargent aidés par un principe qui consiste à rendre les surfaces transparentes en dernier lieu, une fois que toutes les surfaces opaques ont été traitées.
Si le mélange (blending) est personnalisé et traité via un pixel shader, ce qui est nécessaire avec des formats de données personnalisés ou avec plusieurs niveaux de transparences, cet ordre n'est plus garanti et dès qu'un pixel est terminé, il est écrit en mémoire, peu importe si un pixel précédent, peut-être plus lourd à calculer est toujours en cours de traitement. Ce côté aléatoire dans l'ordre d'écriture des pixels en mémoire pose problème dans le cas du traitement des surfaces transparentes, d'autant plus si elles sont multiples : puisqu'elles doivent être mélangées à la surface qu'elles laissent entrevoir, cette dernière doit avoir été traitée avant.
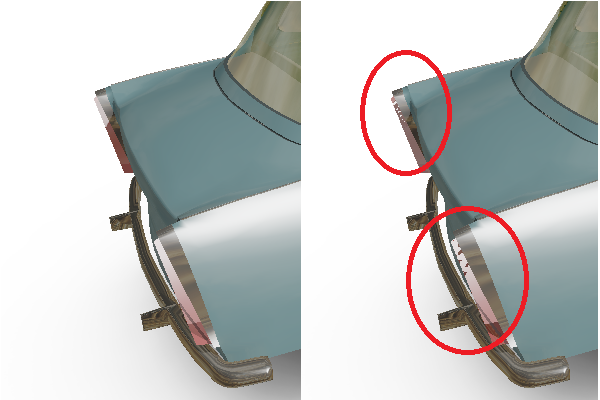
A droite, un exemple de rendu sans technique de respect de l'ordre des pixels lors d'un mélange. Aléatoirement, la face inférieure du phare peut être rendue par-dessus la partie supérieure. A gauche, PixelSync évite ce problème.
Une solution à ce problème a été présentée par AMD avec les Radeon HD 5000 et se nomme Order Independant Transparency (OIT), une technique utilisée pour les cheveux TressFX dans Tomb Raider. Elle consiste, pour les zones affectées par des transparences multiples, à retenir en mémoire tous les pixels qui correspondent à une même coordonnée à l'écran. Une fois la scène passée en revue, ils sont triés et mélangés dans le bon ordre. Cette approche est lourde puisqu'elle peut décupler le nombre de pixels écrits en mémoire. Avec PixelSync, Intel en propose une version simplifiée : si le moteur graphique s'arrange pour soumettre les triangles transparents au GPU dans le bon ordre, cet ordre sera respecté.
Le coût en performances de Pixel Sync sera en général nettement moindre que celui de l'OIT, et simplement lié au fait que le traitement de certains pixels devra se mettre en pause pour garantir l'ordre d'écriture en mémoire. C'est cependant moins flexible et moins passe-partout mais cette approche peut avantageusement remplacer l'OIT dans certains cas simples (ce n'est pas utilisable pour TressFX bien entendu). Codemaster a d'ores et déjà annoncé mettre en place cette optimisation pour GRID 2, tout comme Creative Assembly pour Total War Rome 2.
Vous pourrez retrouver une démo de PixelSync par ici .
InstantAccess
La seconde extension proposée pour Haswell, Direct Ressource Access (DRA) ou InstantAccess, représente la version Intel de la technologie Zero Copy d'AMD. Attendue depuis des lustres, elle permet d'éviter des transferts presque surréalistes entre le CPU et le GPU. Bien que cela paraisse naturel puisque ceux-ci partagent une même mémoire centrale, le problème est que les API graphiques ne sont pas prévues pour ce cas de figure et qu'elles demandent le transfert inutile de certaines données d'une zone mémoire réservée au CPU à une autre zone mémoire réservée au GPU.
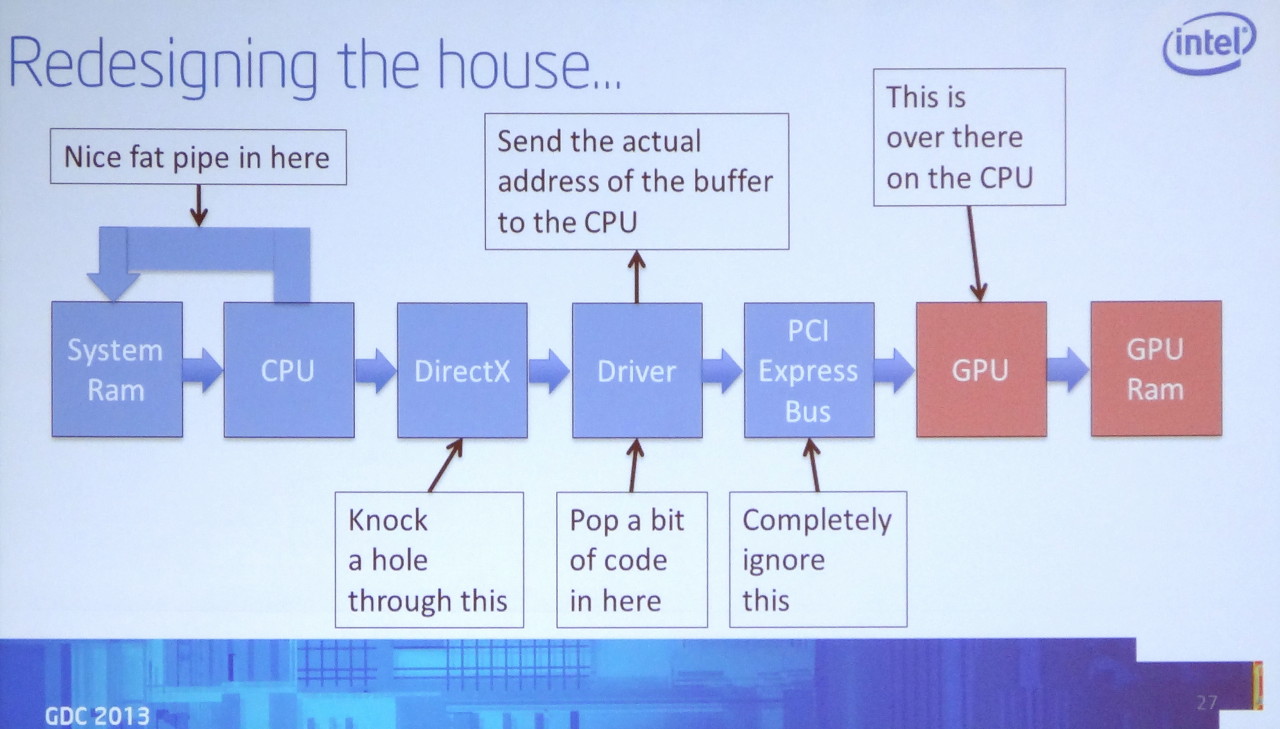
InstantAccess tout comme Zero Copy permettent d'éviter ce cas de figure à travers un mécanisme qui donne au CPU un pointeur vers certains buffers présents dans la mémoire réservée au GPU, tout en protégeant ces espaces mémoire lorsque cela est nécessaire, typiquement quand le GPU doit y accéder. De quoi éviter de perdre du temps et de gaspiller de la bande passante mémoire avec des copies inutiles.
Vous pourrez retrouver une démo d'InstantAccess par ici .
Plus de micro-saccades en CFX en juillet ?
 A l'occasion d'un long article sur le sujet , AnandTech indique qu'AMD compte (enfin!) mettre en ligne en juillet un pilote réglant le problème de micro-saccades rencontré de manière plus ou moins fréquente, principalement en CrossFireX lorsque l'on désactive la synchronisation verticale. Un problème lié à la technologie AFR (Alternate Frame Rendering) qui n'est pas tout neuf puisque nous en avions déjà parlé en... mars 2000, sur la Rage Fury MAXX !
Ce pilote laissera à l'utilisateur le choix entre deux réglages. Le premier correspond au comportement actuel, c'est-à-dire que l'image sera affichée dès qu'elle est prête, alors que le second décalera dans le temps l'affichage d'une image si elle est trop proche de la précédente.
Si le comportement actuel, qui correspond à une non prise en compte du problème, permet d'être au plus près de l'action il peut aussi entraîner des problèmes de fluidité (micro-saccades) dans les cas où peu de temps sépare les images rendues par chacun des GPU. On peut ainsi avoir des images qui restent dans le frame buffer (la partie mémoire lue pour l'affichage à l'écran) pendant 2ms, 40ms, 2ms, 40ms etc… ce qui donne une impression de fluidité moindre que si on était sur 21ms, 21ms, 21ms, 21ms, etc… pour une moyenne qui reste pourtant dans les deux cas à 21ms soit 47,6 fps.
Décaler les images qui arrivent trop rapidement n'est pas une nouveauté et c'est le choix que fait Nvidia depuis longtemps en SLI sous le nom de frame metering. Cela entraine toutefois une latence plus importante sur le rendu graphique de certaines images, dans le cas cité plus haut il faut ainsi rajouter 19ms de présence à l'écran sur les images les plus "rapides" (temps qui sera déduit sur les plus "lentes"). Dans certains cas le choix actuel d'AMD, qui sera toujours possible, permet donc d'afficher une image plus récente par rapport à l'état du jeu.
Attention, ce problème de variabilité est surtout présent lorsque la synchronisation verticale n'est pas activée, ce qui est le cas lors des mesures de performances afin que celles-ci soient les plus précises possibles, mais aussi pour certains utilisateurs qui préfèrent ce mode considéré généralement comme plus réactif. Si la qualité d'affichage est en effet réduite, du fait de cassure pouvant apparaître à l'écran puisque plusieurs images distinctes rendues peuvent se suivre sur une même affichée, c'est aussi le mode qui permet d'avoir une image affichée au plus proche de l'état du jeu. Beaucoup préfèrent conserver la synchronisation verticale active et ne sont alors pas concernés par ce problème, ceux qui préfèrent conserver la synchronisation verticale désactivé peuvent utiliser un limiteur de framerate comme ceux intégrés dans MSI After Burner ou Radeon Pro pour le contourner.
La variabilité des latences inter-image est un sujet qui fait débat depuis l'introduction par The Tech Report d'un protocole de test mesurant cette dernière à l'aide de FRAPS. Ceci a permis fin 2012 de mettre le problème en avant chez AMD sur certains titres DX9 en mono GPU (la source de ces micro-saccades est autre qu'en CFX, et a été corrigée via des pilotes récents, d'autres corrections pour les titres DX10 et plus sont à venir).
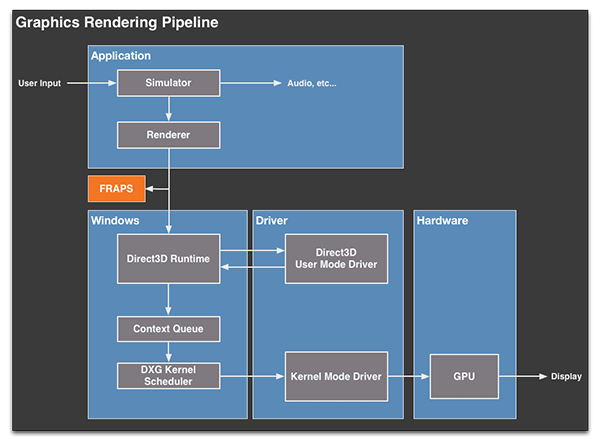
Il faut toutefois noter que le fonctionnement même de FRAPS fait que la mesure de latence inter-image ne se fait pas au bon endroit dans le rendu graphique global et n'était donc pas forcément synonyme d'un problème réel à l'affichage (et vice-versa). Fraps mesure en effet le temps qui s'écoule entre deux appels DirectX de rendu de frame, et non le temps entre les deux affichages de l'image.
Source : AnandTech
Ce sujet refait surface à l'occasion de la mise à disposition de testeurs par Nvidia d'un nouvel outil plus adéquat (présenté par PCPer ici , là ou encore ici et utilisé là ), le FCAT pour Frame Capture Analysis Tool (présenté par Nvidia sur son blog aujourd'hui ). La publication de l'article d'AnandTech sur le sujet, qui précède donc une vague de publications sur le sujet (en sus de PCPer, AnandTech et Tom's Hardware viennent de lui consacrer un dossier) et qui fait suite à un entretien avec les équipes d'AMD, n'est sans doute pas étrangère à ceci : c'est ce qu'on appelle du Damage Control. Reste donc à voir si les paroles seront suivies d'actes, et si ces pilotes résoudront également le comportement souvent très problématique du CrossFireX en tri-écran.
GDC: La Radeon HD 7990 d'AMD en approche
Un temps annulée puis laissée aux mains de quelques partenaires, la Radeon HD 7990 aura connu une gestation longue et compliquée. AMD vient cependant de confirmer qu'un design de référence était actuellement en cours de finalisation

Aucune information concernant les spécifications finales, si ce n'est que la carte est équipée de 2 connecteurs PCI Express 8 broches, mais nous pouvons cependant observer qu'il s'agit d'un design proche de celui présenté à l'AFDS 2012, qui est légèrement différent du design de la FirePro S10000.


Pour accompagner la sortie future de cette Radeon HD 7990 "officielle", AMD prépare une nouvelle démo technologique qui mettra une nouvelle fois en scène Ruby. Cette démo est développée en partenariat avec Crytek, elle repose donc sur le CryEngine 3, et Illfonic (Nexuiz) et a pour but de se rapprocher d'un rendu cinématographique avec une utilisation de nombreux effets de particules, de la tessellation et d'un effet de Depth of Field évolué.
Cette démo est encore en développement et nous n'avons pu en observer qu'un bref extrait sur un petit écran, difficile donc de se faire une idée précise de la qualité du rendu final. Notez que la technologie TressFX, dédiée au rendu des cheveux n'est pas encore de la partie, mais elle est bel et bien en cours d'intégration.

GDC: Cloud gaming: AMD lance les Radeon Sky
En marge de la Game Developer Conference 2013, AMD vient de présenter sa stratégie pour le cloud gaming qui va permettre à la société de pouvoir toucher les joueurs sur des marchés dont elle est actuellement absente (smartphones) ou peu présente (tablettes), ainsi que toucher un plus large public directement au niveau d'une TV non équipée d'une console ou d'un HTPC.
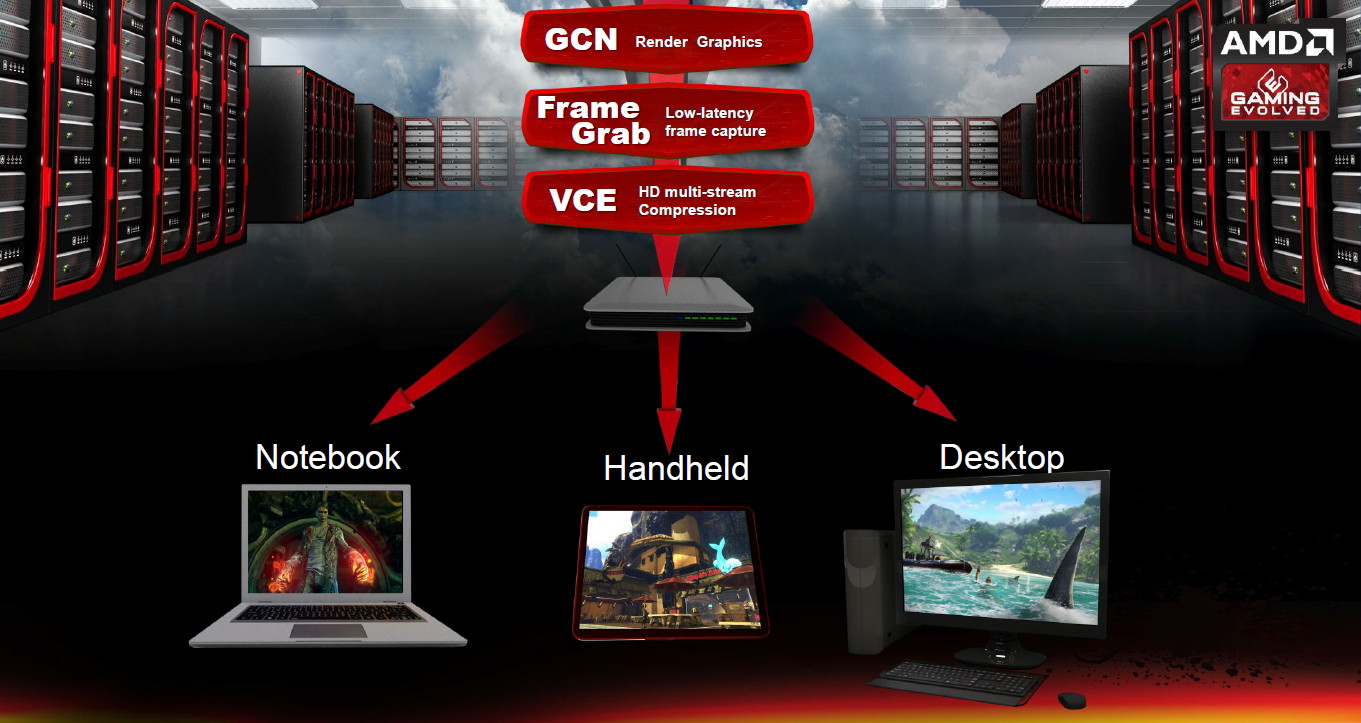
Pour toucher ce large public à travers le streaming, comme le fait Nvidia avec GRID for Gaming, AMD a développé une plateforme spécifique : RapidFire. Cette plateforme est prévue, à terme, pour supporter plusieurs streams par GPU et est optimisée pour une latence réduite. Pour cela, AMD a mis au point une technologie vidéo spécifique, Frame Grab, qui permet de récupérer directement les images rendues par les GPU et de les encoder en profitant du moteur d'encodage h.264 dédié (VCE) qu'ils intègrent.
Des variantes dédiées des cartes graphiques maisons seront également proposées sous peu : les Radeon Sky 900, 700 et 500. Celles-ci sont respectivement dérivées des FirePro S10000, S9000 et S7000, le plus gros modèle étant équivalent à une bi-Radeon HD 7950.
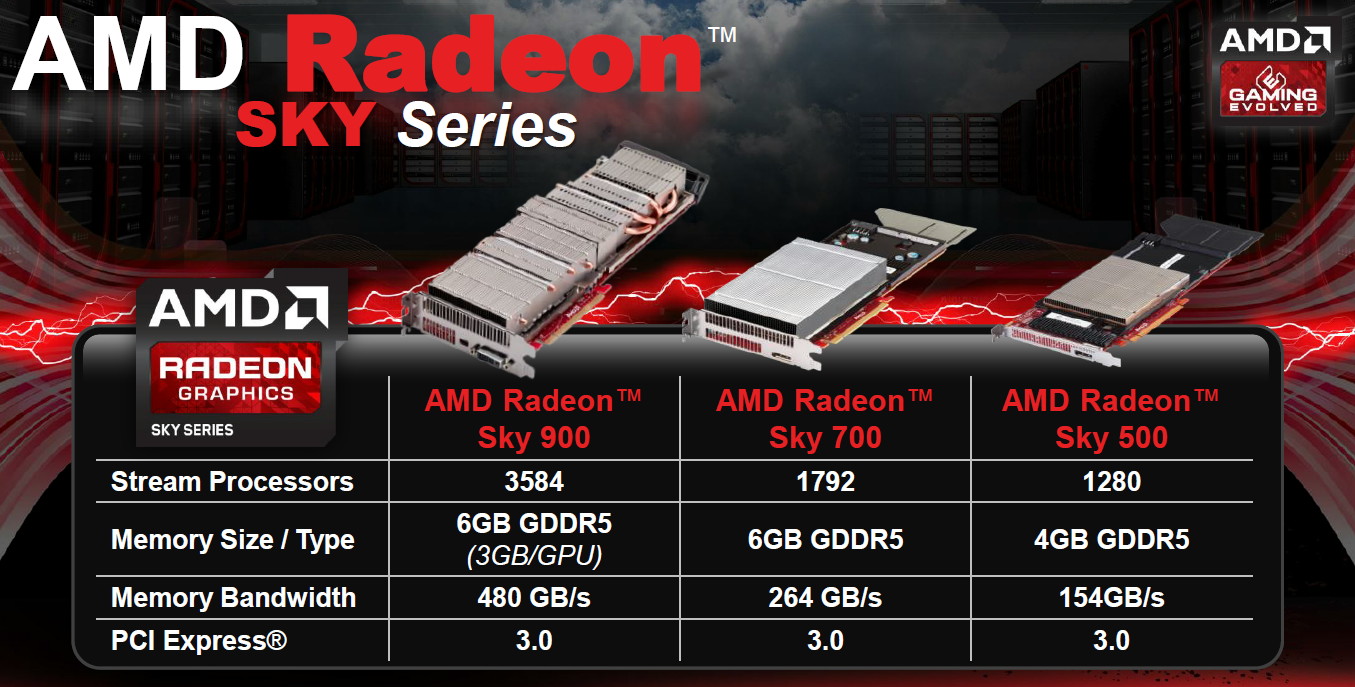
Comme à son habitude, et contrairement à Nvidia qui vise la commercialisation de serveurs GRID complets, AMD met en avant une approche centrée sur des partenariats avec plusieurs acteurs du cloud gaming : CiiNOW, otoy, ubitus et G-cluster Global. Ceux-ci vont intégrer, ou envisagent de le faire, les Radeon Sky dans leurs plateformes actuelles, en supportant éventuellement RapidFire, ou une partie de cette technologie, certains ayant déjà développé leurs propres solutions.
Nous avons pu observer plusieurs de leurs systèmes en démonstration, mais notre avis actuel est plutôt mitigé. Si la latence n'était pas un problème du tout, forcément quand le serveur est à 2 pas du client, la qualité de compression n'était par contre pas à la hauteur, avec une pixellisation très importante comme nous pouvions l'observer sur les première démonstrations de GRID. La technologie RapidFire n'a de toute évidence pas encore été intégrée, tout du moins sur le plan vidéo, et la compression se fait actuellement en software, avec une qualité réduite (h.264 base profile) pour ne pas trop affecter la latence. Avec RapidFire et l'utilisation du moteur d'encodage du GPU, la compression devrait passer au h.264 high profile et donc atteindre un meilleur niveau de qualité. Reste à voir quand cette intégration pourra se faire en pratique, AMD parle de Q2, et quels seront alors les résultats.
Les 5 actualités précédentes

