Actualités cartes graphiques
 Les 5 actualités précédentes
GDC: Démo Nvidia: RealTime Dynamic Fracture
GDC: Démo Activision: rendu de visage réaliste
L'ASUS GTX 670 DirectCU Mini lancée
3DMark et GLBenchmark 2.7 pour Android sont là
GeForce 700M : de qui se moque Nvidia ?

Test : Nvidia GeForce GTX 650 Ti Boost


Nous venons de mettre à jour le dossier consacré à la Radeon HD 7790 pour y intégrer le test de la GeForce GTX 650 Ti Boost 2 Go. Nous en avons profité pour ajouter BioShock Infinite au panel de test et mettre à jour les résultats sous Crysis 3, Far Cry 3 et Tomb Raider qui entre temps ont reçu un nouveau patch.
Notez que nous avons utilisé les pilotes 314.22 de Nvidia qui apportent des optimisations pour BioShock Infinite ainsi que pour Tomb Raider. Si des gains de 60% sont annoncés dans ce dernier cas par Nvidia, comme nous le supposions, ils concernent avant tout l'outil de bench intégré qui repose sur un rendu de type cinématique avec des propriétés quelque peu différentes des scènes de jeu classiques. Nous n'avons observé aucun gain dans notre scène de test.
Dossier : AMD Radeon HD 7790 et GeForce GTX 650 Ti Boost en test
GDC: Windows RT et les jeux : quel succès ?
Une image vaut parfois mieux qu'un long discours :
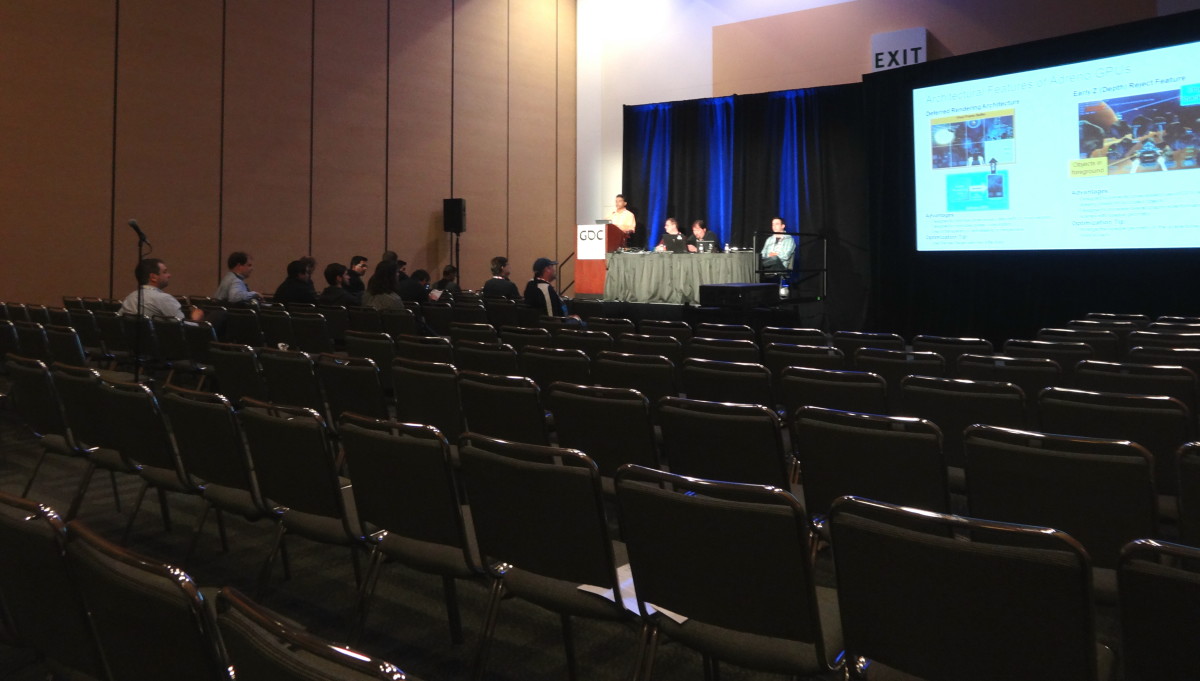
Le moins que l'on puisse dire c'est qu'à la GDC les développeurs ne se bousculaient pas pour assister aux quelques sessions liées à Windows RT. Ici en exemple le portage de Vendetta Online vers cet OS, présenté en association avec Qualcomm et que nous nous sommes contentés d'illustrer à partir du milieu de la salle. En dehors des représentants de Guild Software, de Microsoft et de Qualcomm, la salle était tristement vide.
Notez qu'à l'opposé, les sessions de Sony sur la PS4 et de Valve faisaient partie des plus populaires avec des files énormes et l'impossibilité de faire rentrer tout le monde dans les salles pourtant plutôt grandes qui avaient été prévues. De toute évidence, les déçus ne se sont pas rabattus sur les sessions Windows RT !
GDC: L'architecture PowerVR Series 6 Rogue
Dans une session dédiée à l'architecture PowerVR, Imagination a donné quelques détails sur l'architecture Series 6, nom de code Rogue, qui a été dévoilée il y a plus de deux ans et qui devrait très bientôt arriver dans différents SoC.
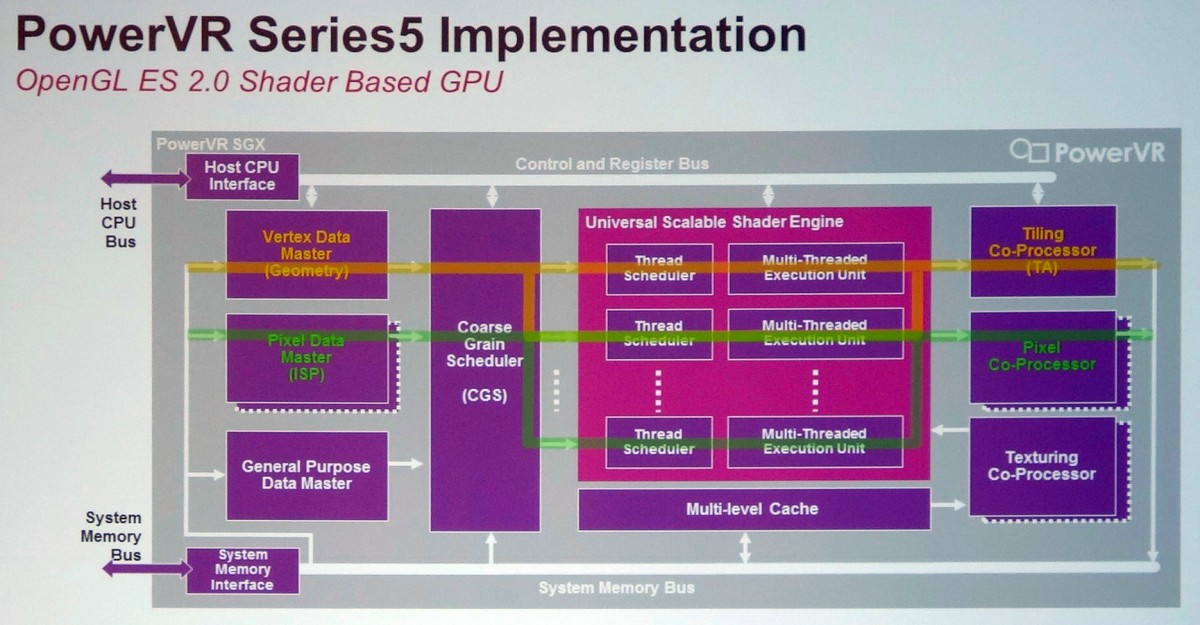
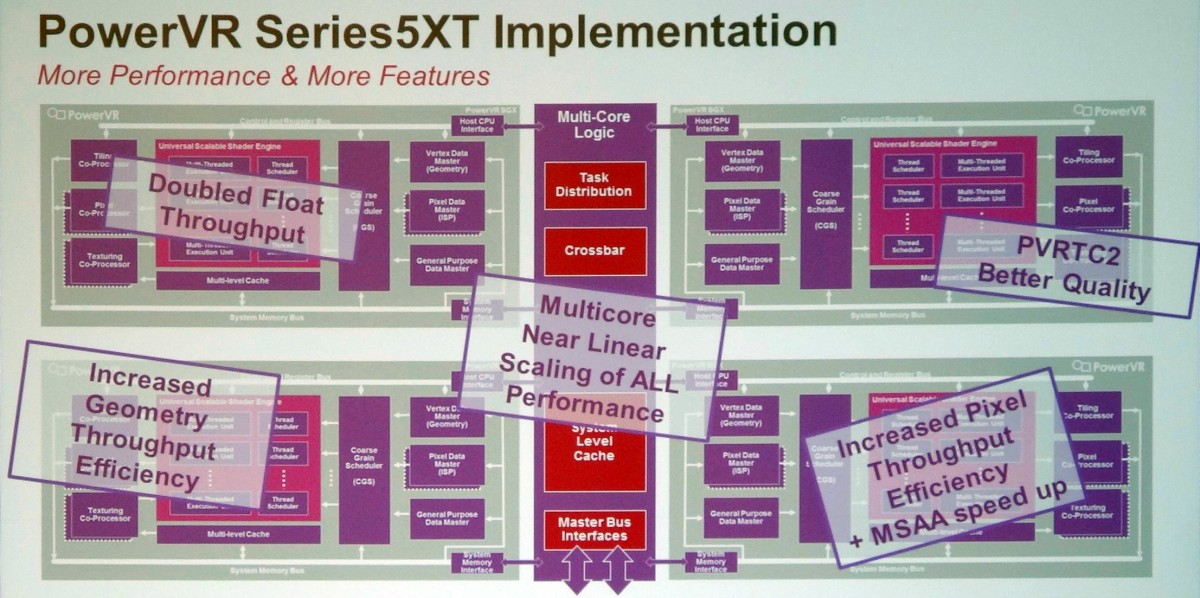
L'architecture PowerVR Series 5 est exploitée depuis de nombreuses années, par exemple dans les SoC Atom Intel ou dans l'A4 d'Apple. Elle a évolué il y a un peu plus de 3 ans pour passer en version Series 5XT avec le PowerVR SGX543 qui a doublé la puissance de calcul (elle passe de 8 à 16 MAD par cycle) et amélioré l'efficacité au niveau des débits de triangles et de pixels, notamment avec MSAA. Le support d'OpenCL a par ailleurs été introduit.
Par ailleurs, Imagination a introduit la possibilité d'avoir recours au multicore pour démulitplier la puissance des GPU PowerVR. L'ensemble du GPU SGX543 représente alors un core qui peut être dédoublé jusqu'à 8x, le tout étant piloté par un distributeur de tâche qui intègre un cache commun. Cette notion de core est donc ici assez proche d'un core CPU et n'a rien avoir avec la notion de core utilisée par Nvidia dans ses GPU, y compris Tegra. Comparer le GeForce ULP 72 cores du Tegra 4 au PowerVR SGX543MP4 "seulement 4 cores" est donc un non-sens, même si comme vous vous en doutez le côté commercial ne s'en prive pas.
Notez que le PowerVR SGX544 a ajouté le support de DirectX en niveau 9_3 alors que le PowerVR SGX554 a doublé une nouvelle fois la puissance de calcul qui passe à 32 MAD par cycle par core.
Avec l'architecture PowerVR Series 6, Imagination a dû faire face à la problématique de la consommation énergétique. Dédoubler les cores Series 5XT c'était "simple", mais les GPU finissaient alors par devenir trop gourmands. L'architecture a donc été revue pour devenir similaire à celle des GPU desktops modernes et pouvoir multiplier, à l'intérieur d'une structure fixe, des blocs (USC - Unified Shading Clusters) comprenant des unités de calcul et d'autres des unités de texturing. De quoi supprimer la redondance pour rendre le GPU plus compact et plus économe.
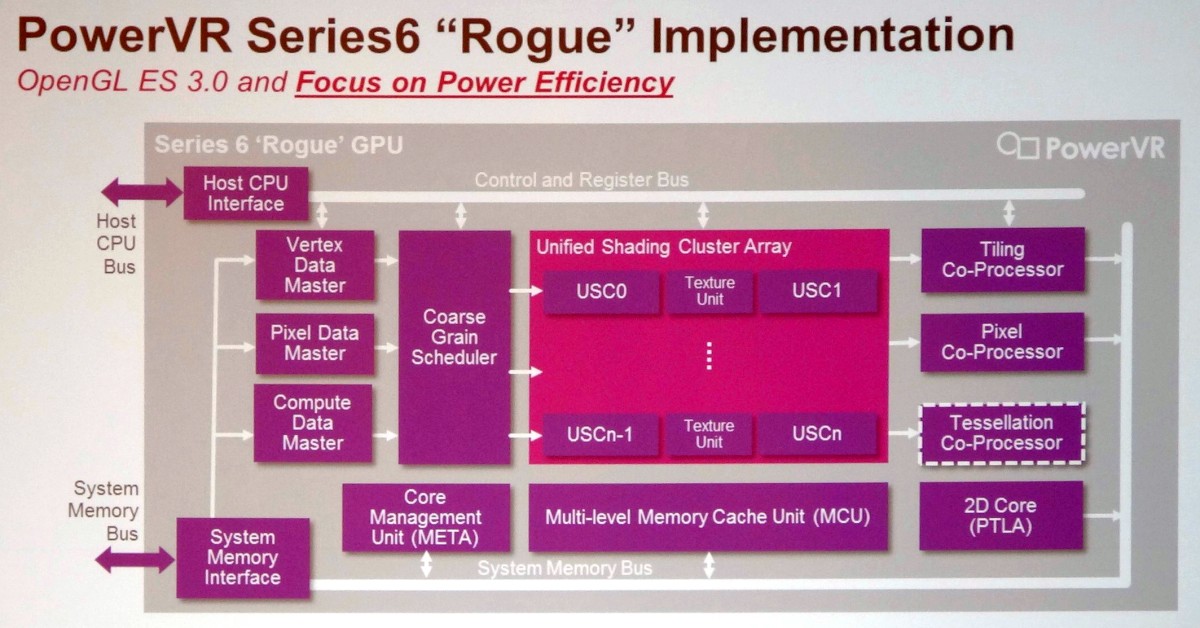
De nombreux petits raffinements ont été apportés à l'architecture, toujours dans le but de la rendre plus efficace. C'est le cas par exemple du passage à un fonctionnement perçu de type scalaire des unités de calcul (comme pour les GeForce 8+ et les Radeon HD 7000+) ou encore du support d'une compression lossless pour la géométrie et les pixels. Le support d'OpenGL 3.0 est complet et du côté DirectX on passe au niveau 10_0. Le support de DirectX 11_1 est par ailleurs possible, optionnellement, avec notamment l'ajout d'un tessellateur.
Parmi les détails, Imagination précise ceci :
- les unités de texturing ont gagné en performances lors d'accès dépendants
- le support de la basse précision lowp (FX10) a été abandonné, ne restent que le mediump (FP16) et le highp (FP32)
- les branchements dynamiques sont dorénavant traités par groupes de threads et peuvent être moins performants en cas de divergence, comme sur GPU desktop et contrairement aux Series 5
- lors de l'utilisation de MRT - Multiple Render Targets (écriture vers plusieurs buffers en une seule passe), il faut prendre garde à ne pas dépasser 128 bits par pixel, le maximum supporté pour profiter du buffer lié au tile rendering, ce qui se traduit grossièrement par "HDR + MSAA + MRT = pas bien"
Imagination prévoit actuellement 6 variantes, les PowerVR G6100, G6200 et G6400 ainsi que les PowerVR G6230, G6430 et G6630. D'après ce que communique Imagination, les G6x30 affichent des débits bruts similaires aux G6x00 mais avec quelques améliorations de l'architecture pour gagner en performances. S'il est possible que ces G6x30 soient compatibles avec le niveau 11_1 de DirectX, nous estimons plus probable que ce support ne soit prévu que pour une variante future.
Le second chiffre représente le nombre d'USC : 1 pour le G6100 jusqu'à 6 pour le G6630. Chaque paire d'USC, excepté pour le G6100 bien entendu, est associée à un bloc d'unités de texturing, mais Imagination ne précise pas le nombre d'unités de calcul (MAD) par USC. Il s'agira probablement de 32 unités de calcul par USC, avec, en terme de puissance brute et à fréquence égale, un G6100 qui serait équivalent à un SGX544MP2 et un G64x0 qui serait équivalent à un SGX554MP4.
Si ces GPU semblent prometteurs sur le papier, il faudra cependant patienter jusqu'à l'arrivée des premiers SoC qui les intégreront, et d'informations plus complètes, pour se faire une idée plus précise de leur niveau de performances.
Annoncé il y a plus de 2 ans, le Nova A9600 de ST-Ericsson devait être le premier SoC à intégrer un GPU PowerVR Series 6. Malheureusement le Nova A9600 a fait les frais du divorce entre STMicro et Ericsson.
GDC: Architecture GPU : IMR, TBR ou TBDR ?
Durant la GDC, il n'était pas question uniquement des GPU PC ou console : le monde du GPU mobile était également à l'honneur tant il se développe à une vitesse fulgurante. Compte tenu du nombre important d'acteurs à ce niveau, des contraintes fortes en terme d'efficacité énergétique et une bande passante mémoire très limitée, différents types d'architectures s'y côtoient, avec des compromis différents. L'occasion de faire le point entre les variantes IMR, TBR ou TBDR, en nous basant sur quelques slides récapitulatives proposées par Imagination.
Rappelons tout d'abord deux concepts :
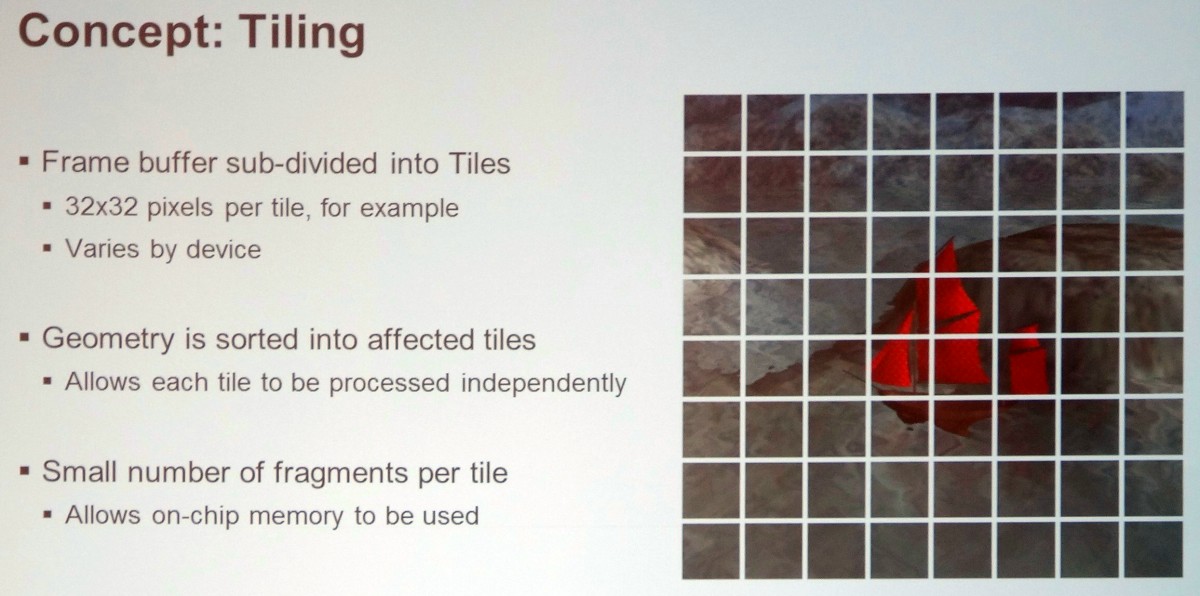
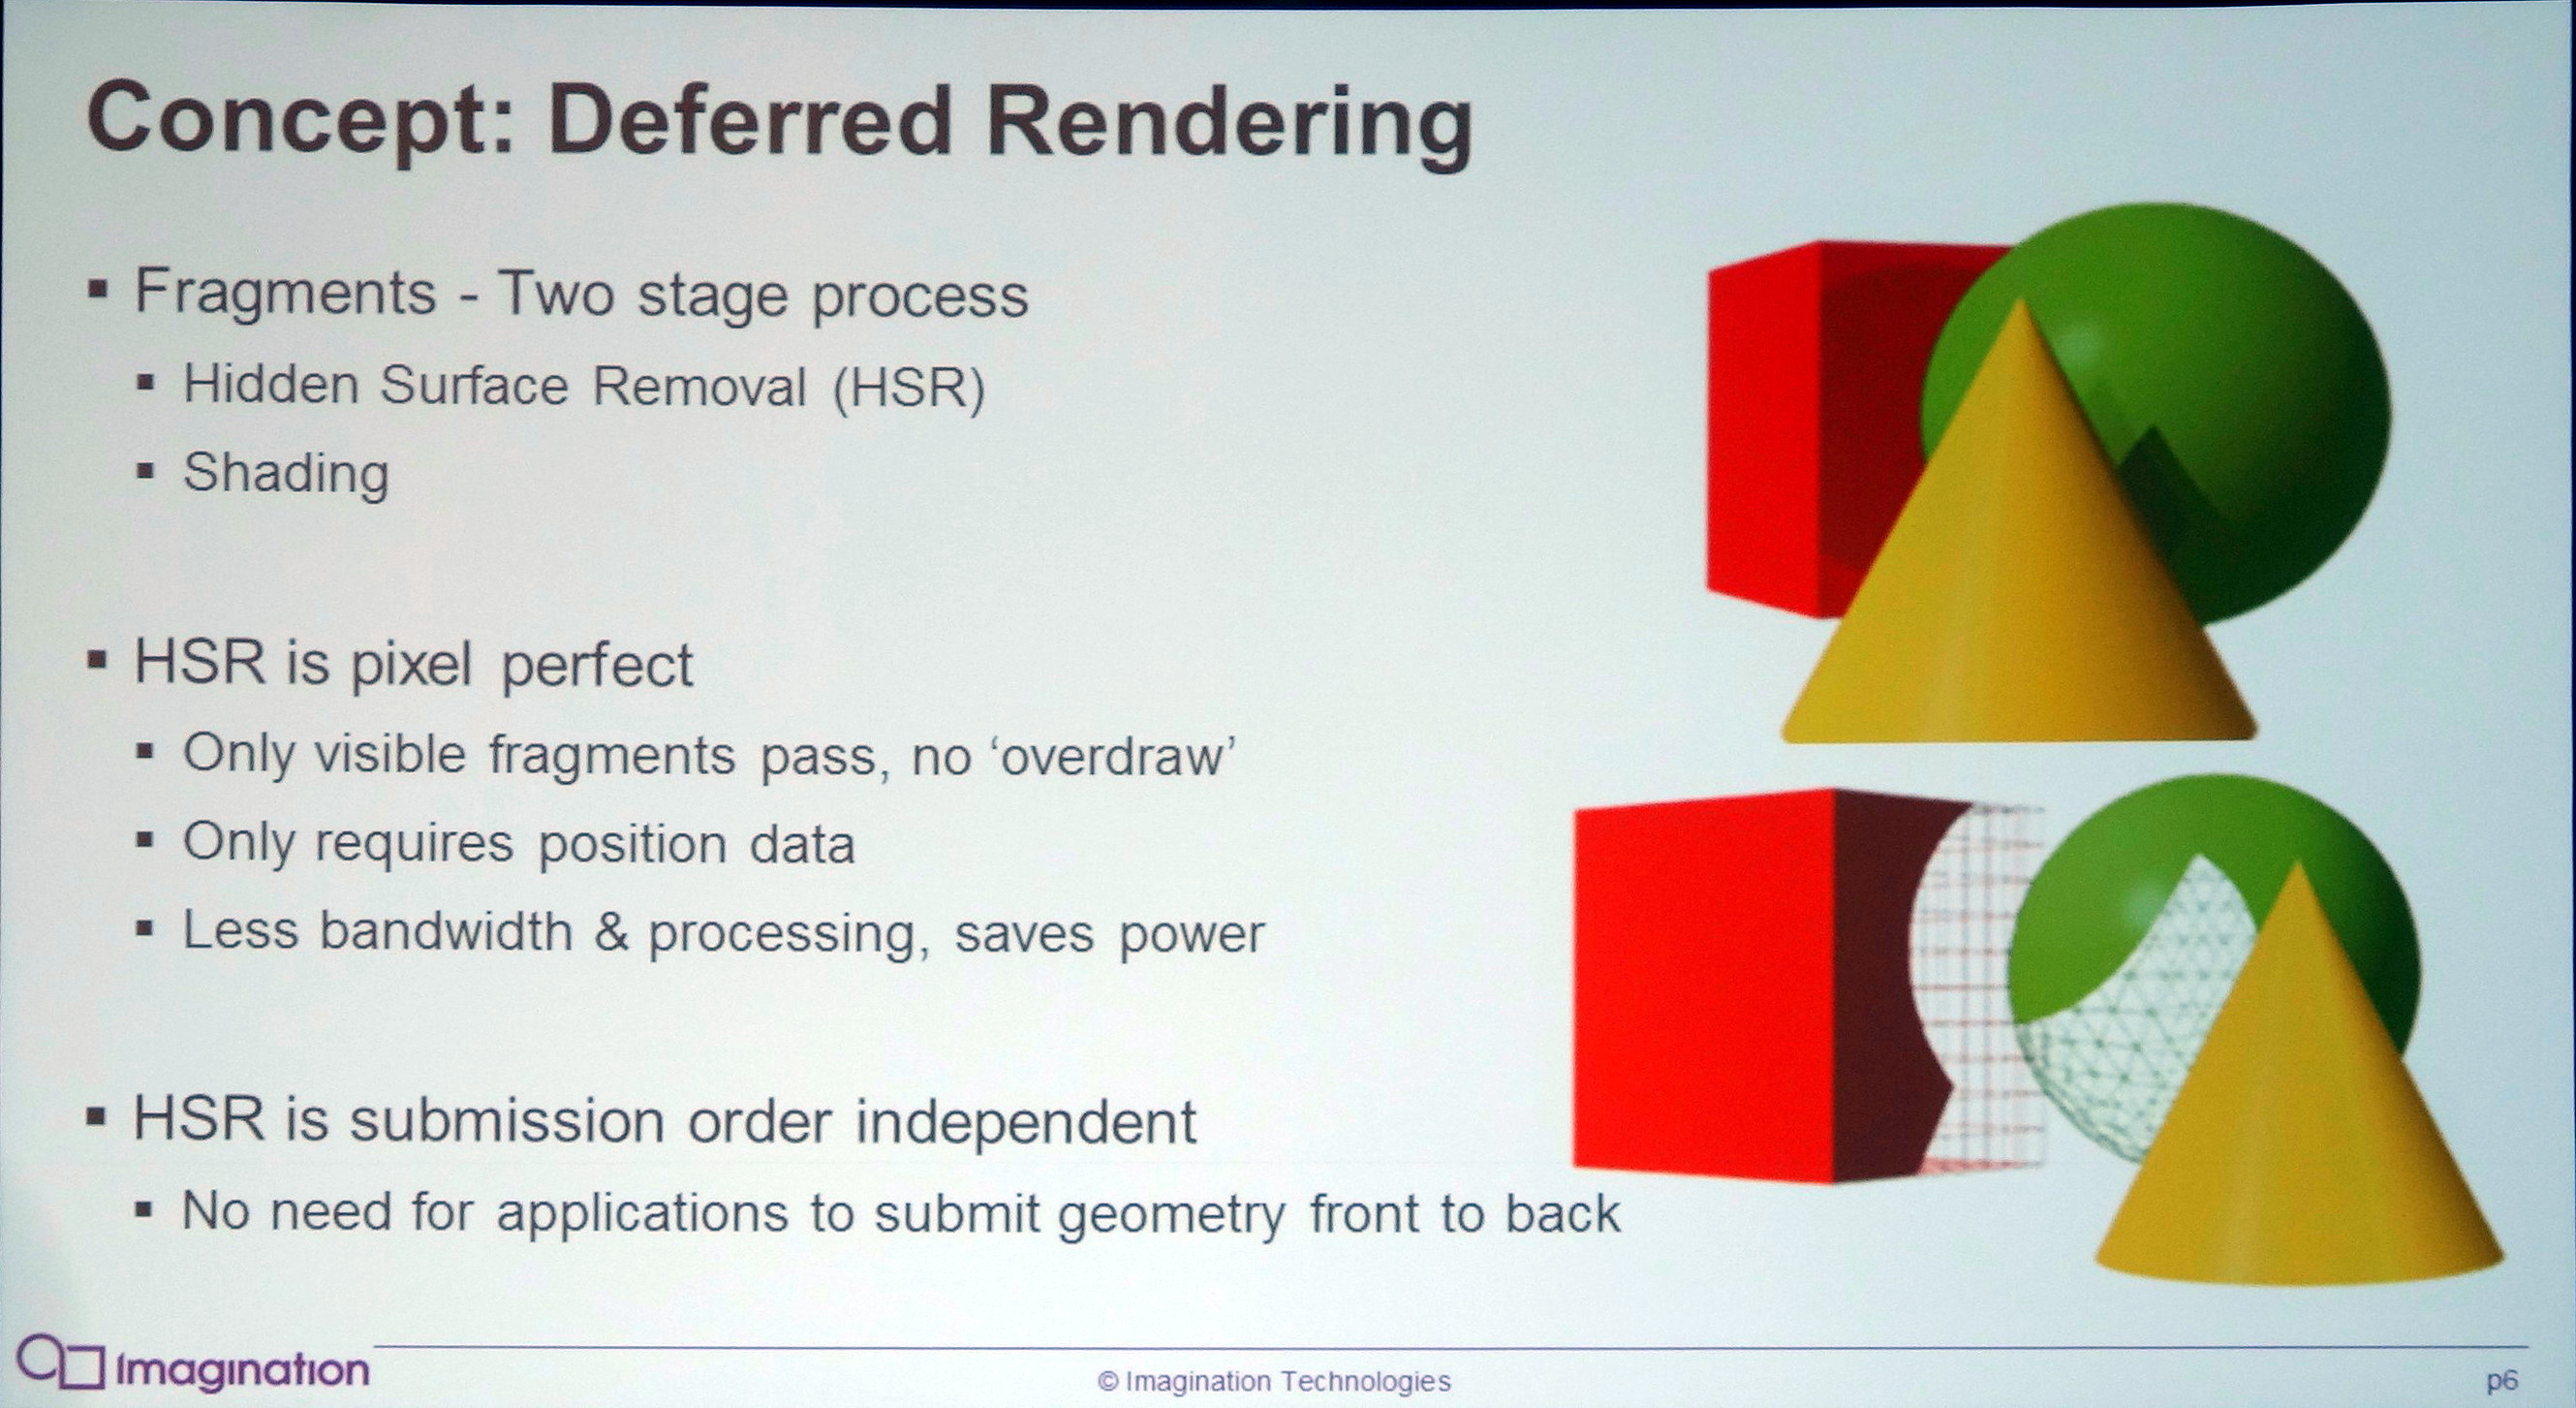
Le rendu basé sur des tiles (tuiles), également appelé binning, consiste à subdiviser le framebuffer en un ensemble de petites zones de l'image qui seront rendues les unes après les autres et qui peuvent tenir dans un petit cache interne au GPU. Cela a pour avantage d'éviter de passer par la mémoire externe et de gaspiller de la bande passante mémoire lors de l'écriture de pixels "temporaires". Imagination parle par exemple de tiles de 32x32 pixels, en précisant que la taille exacte est variable selon le GPU Power VR.
Le rendu différé permet de se baser sur une première passe dans laquelle la géométrie est passée en revue pour ne retenir qu'un seul pixel à finaliser par point de l'écran et ainsi réduire, voire supprimer, l'overdraw (le rendu de pixels masqués). Le rendu différé peut être implémenté de manière logicielle comme le font de nombreux moteurs graphiques pour ne calculer la partie complexe de l'éclairage qu'une fois par pixel. Il peut également être implémenté de façon matérielle en tant que technique de HSR (Hidden Surface Removal) pour permettre au GPU de déterminer l'unique pixel visible par point de l'écran.
Il existe trois grands groupes d'architectures GPU (notez qu'étant donné qu'il s'agit de slides d'Imagination, les points cités sur celles-ci se contentent de mettre en avant les avantages du TBDR maison) :
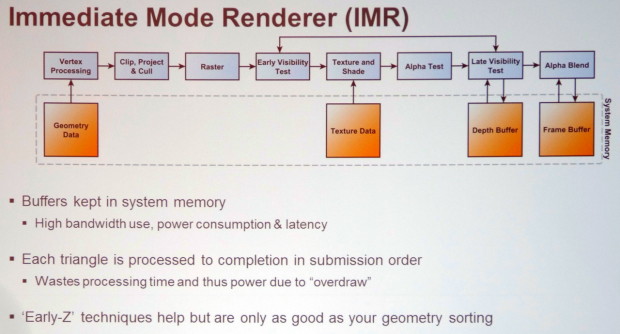
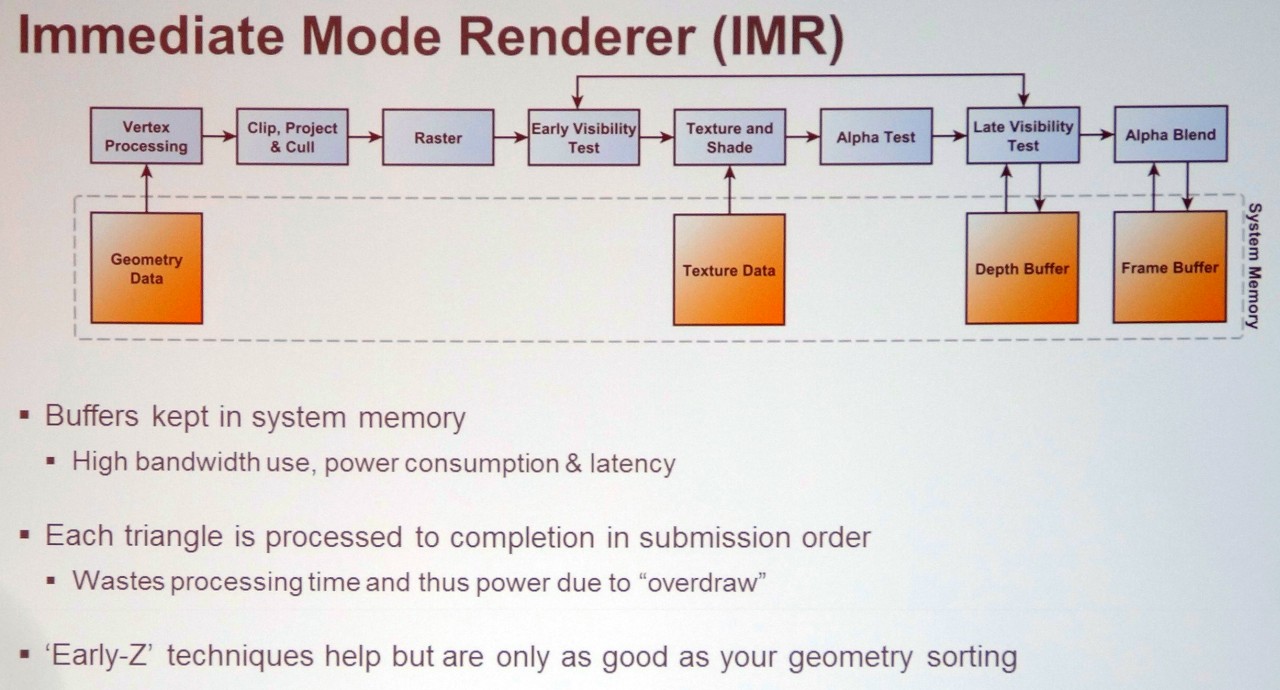
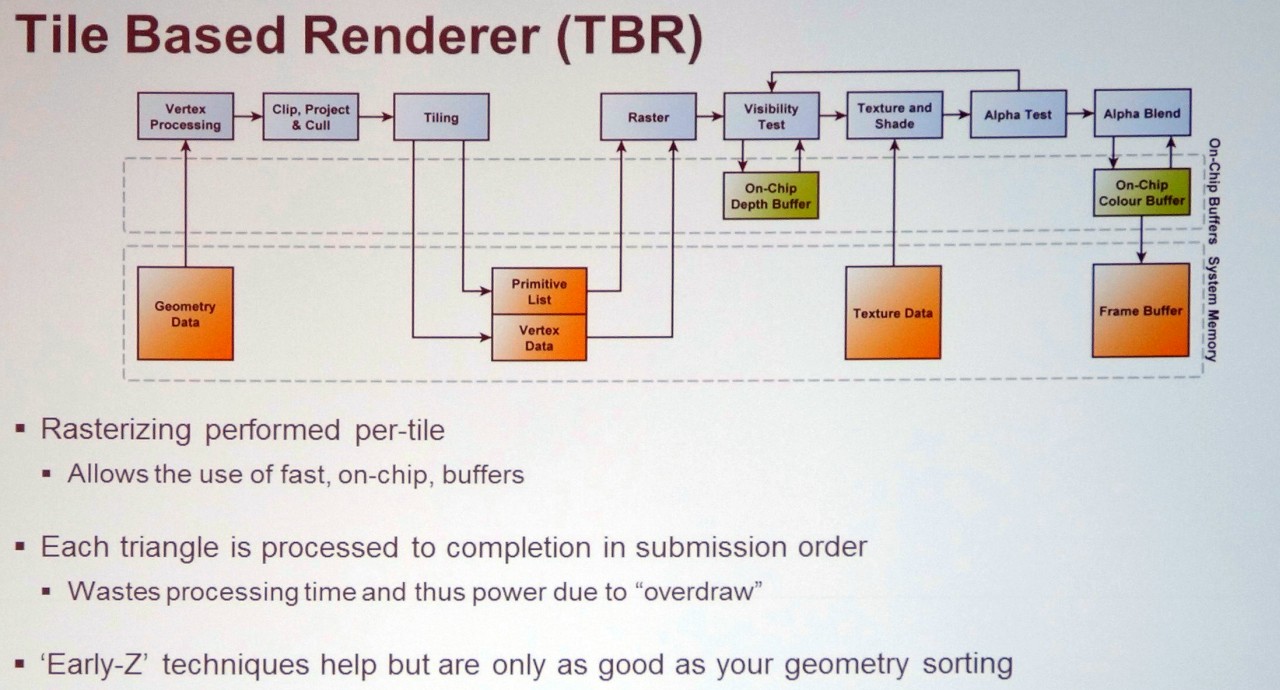
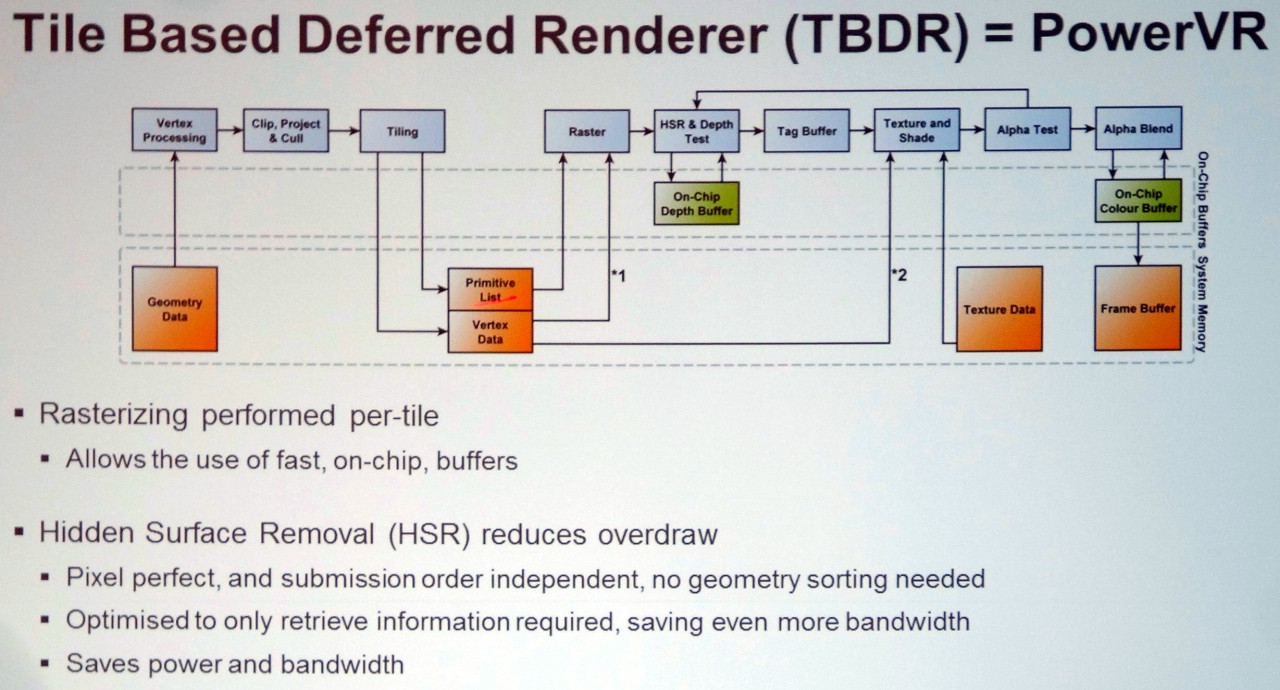
| [ IMR – Immediate Mode Renderer ] [ TBR – Tile Based Renderer ] [ TBDR – Tile Based Deferred Renderer ] | Agrandir Agrandir Agrandir |
L'IMR ou le rendu immédiat représente l'approche "naturelle" du rendu sur base de primitives : la géométrie est transformée pour prendre place dans la scène, les triangles sont directement découpés en pixels les uns à la suite des autres, les pixels sont rendus et écris en mémoire. Cette approche est très flexible mais peut consommer beaucoup de bande passante mémoire et entraîner le calcul de pixels masqués quand un triangle caché par un autre est rendu avant celui-ci. Les GPU d'AMD, d'Intel et de Nvidia (y compris Tegra), ainsi qu'optionnellement les GPU Adreno de Qualcomm, exploitent l'IMR et disposent de nombreuses optimisations pour éviter de gaspiller trop de ressources.
Le TBR ou binning, soit le rendu tile par tile "simple", est exploité à des degrés divers par les GPU Mali d'ARM, Adreno de Qualcomm voire dans certains cas Xenos de la Xbox 360 et HD Graphics d'Intel. Pour être efficace et éviter de devoir traiter plusieurs fois la géométrie (pour chaque tile), cette approche doit être combinée à un rendu en deux étapes. La première consiste à passer en revue toute la géométrie et à écrire en mémoire la position de chaque primitive (triangles) après transformation ainsi qu'un lien vers toutes les tiles que chacune affecte. Le rendu classique peut ensuite se faire tile par tile, en ne traitant que les triangles qui s'y retrouvent et en ne gaspillant pas de bande passante mémoire externe, que ce soit pour écrire des pixels cachés ou pour des opérations de mélange lorsque des objets transparents sont rendus.
Dans certains cas, cette approche est cependant peu efficace, par exemple lorsque la géométrie est très complexe et représente autant, voire plus, de données à écrire en mémoire que ce qui est économisé au niveau des pixels. Par ailleurs, lorsque de petits triangles (qui peuvent être traités en un seul cycle) croisent plusieurs tiles, le rasterizer peut se retrouver débordé puisqu'il va devoir les traiter une fois pour chaque tile. Cette perte d'efficacité potentielle est la raison pour laquelle les GPU d'Intel et de Qualcomm supportent l'IMR en plus du TBR.
Le TBDR exploité par les GPU PowerVR ajoute au TBR le principe du rendu différé : se débarrasser de l'overdraw. Ainsi une technique de HSR (Hidden Surface Removal) hardware basée sur un lancer de rayon permet pour chaque pixel de retrouver le triangle visible au milieu de l'ensemble de la géométrie liée à la zone de rendu, ce qui est bien entendu facilité par le rendu par tile. Notez que le TBDR peut perdre d'avantage en efficacité que le TBR quand la géométrie devient très complexe puisque le moteur de HSR va avoir plus de mal à déterminer les triangles visibles et potentiellement devenir le facteur limitant.
Par contre, en plus de n'écrire en mémoire externe qu'un seul pixel par point de l'écran, seulement un pixel est calculé par les GPU de type TBDR, ce qui permet des économies supplémentaires au niveau de la puissance de calcul et de texturing. Notez qu'en contrepartie, certaines techniques de rendu demandent des adaptations particulières, qui peuvent avoir un coût, pour fonctionner sur ce type d'architecture : c'est le cas de certains effets de transparences ou qui modifient la profondeur effective du pixel après le traitement géométrique (bump mapping avancé par exemple).
Chaque approche a donc des avantages et des désavantages. Comme pour tout ce qui concerne le rendu 3D temps réel en général, il s'agit toujours d'un compromis. En dehors de Nvidia, il semble cependant y avoir un consensus dans le monde mobile en faveur de l'utilisation de tiles, tout du moins optionnellement, pour économiser autant que possible la bande passante mémoire et l'énergie qui y est liée, quitte à complexifier l'architecture du GPU.
GDC: Démo Epic : Unreal Engine 4 Infiltrator
Epic était également de la partie au niveau des démos présentées à la GDC. Après Samaritan basé sur une version très évoluée de l'Unreal Engine 3, Epic présentait une nouvelle démo basée sur la dernière évolution en date de son moteur : l'Unreal Engine 4.
Cette démo est annoncée comme tournant en temps réel sur une seule GeForce GTX 680 et montre donc ce qu'il est possible de faire avec l'UE et le matériel actuel, à condition bien entendu de mettre les moyens au niveau artistique ! Concevoir des mondes, des objets, des personnages, des éclairages, etc., aussi travaillés représente un investissement énorme dont la croissance exponentielle pose problème pour les studios de développement.
Les 5 actualités précédentes