

Actualités cartes graphiques
 Les 5 actualités précédentes
NVIDIA renoue avec les bénéfices
Fraps 3 : 7, DX11 et 3D Vision
GTX 275 CO-OP PhysX chez EVGA
TSMC : 40% de yield pour le 40nm
DX11 sous Vista dispo

Dossier : AMD Radeon HD 5970


Après les Radeon HD 5800 et 5700, c’est au tour de la Radeon HD 5970 de faire son apparition. Déclinaison bi-GPU des Radeon HD 5800, celle-ci vient confirmer la domination d'AMD sur le haut de gamme.
[+] Lire la suite

Nvidia lance la GeForce GT 240
Après les GeForce G210 et GT220, NVIDIA lance ce jour une 3è puce gravée en 40nm et supportant DX10.1. La GeForce GT 240 est comme les GTS 260M et 250M basée sur le GT215. Elle intègre 96 unités de calculs cadencées à 1340 MHz et un bus mémoire 128 bits pouvant être associé à de la GDDR5 1.7 GHZ ou de la DDR3 1 GHz. Les spécifications sont les suivantes :

Par rapport au GTS 240, qui est une 9800 GT avec des fréquences un peu plus élevées, le GT 240 offre une puissance de calcul nettement inférieure. Cette dernière peut être toutefois être associée avec de la GDDR5 nettement plus rapide ce qui lui permet malgré un bus 128 bits d’afficher une bande passante proche du 9600 GT GDDR3. Malheureusement, des versions GDDR3 avec de la mémoire 1 GHz sont également annoncées par NVIDIA. Pire, certains constructeurs tels que Inno3D ont des modèles avec de la mémoire à 700 MHz ! Du coup, autant dans sa version GDDR5 le GT 240 sera supérieur au 9600 GT, autant les versions GDDR3 seront selon les fréquences mémoires plus ou moins en dessous.

Ces dérives sont clairement condamnables et on ne peut que regretter que NVIDIA laisse les intégrateurs utiliser des mémoires si lentes. Dans le même genre, alors qu’officiellement le GT 220 doit être associé à de la GDDR3 790 MHz ou à de la DDR2 500 MHz, Club3D a un modèle avec de la DDR2 333 MHz. Alors que le consommateur a déjà du mal à s’y retrouver au sein des dénominations des GPU, ces différentiations au niveau de la mémoire sont clairement trompeuses, et à défaut d’en être à l’initiateur, NVIDIA en est le complice.
Nvidia dévoile des Tesla 20 avec Fermi
A l’occasion du salon SuperComputing 2009 qui se tient à Portland, Nvidia a décidé de lever le voile sur les premières cartes à exploiter sa future architecture Fermi. Pour rappel il s’agit du nom de code de la déclinaison haut de gamme de la nouvelle architecture GPU de Nvidia que nous vous avions présentée il y a un peu plus d’un mois et qui apporte de nombreuses avancées importantes pour la transition du GPU vers une unité de calcul massivement parallèle flexible et efficace.
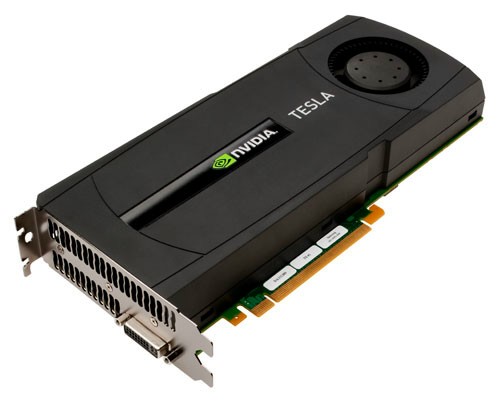
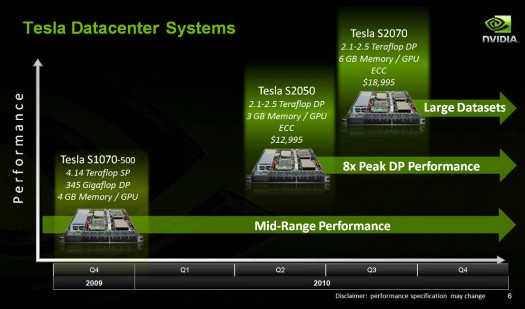
Salon SuperComputing oblige, ce sont les versions Tesla de Fermi qui sont dévoilées aujourd’hui avec pas moins de 4 produits : Tesla C2050, Tesla C2070, Tesla S2050 et Tesla S2070. Comme avec les gammes précédentes, les versions C représentent une carte seule alors que les versions S correspondent aux racks 1U équipés de pas moins de 4 cartes C.
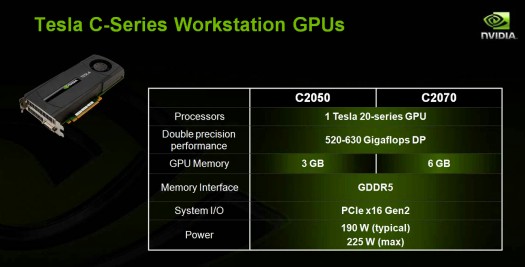
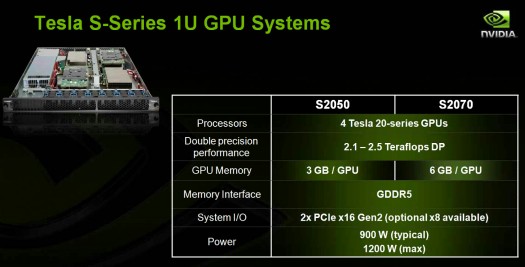
Bien que les produits et leur tarification soient annoncés, les spécifications exactes n’ont pas encore été dévoilées par Nvidia, les produits n’étant en réalité pas encore prêts. Si nous savons maintenant que les version 50 seront équipées de 3 Go contre 6 Go pour les versions 70, les fréquences tant du GPU que de la GDDR5 restent inconnues. Le fabricant attend probablement que les tests sur la dernière révision de la puce soient terminés pour fixer les fréquences finales. Nvidia donne cependant une fourchette de puissance de calcul en double précision avec 520 à 630 Gflops, ce qui correspond à une fréquence pour les unités de calcul de 1 à 1.2 GHz, ce qui nous a surpris puisque c’est relativement faible. Pour rappel, dans notre analyse de Fermi, nous avions pris pour exemple une fréquence pour les unités de calcul de 1.6 GHz en estimant être relativement conservateurs.
Cette fréquence faible, malgré la gravure en 40 nanomètres, permet cependant à Fermi de se démarquer considérablement des cartes Tesla actuelles en double précision, son architecture étant particulièrement bien fournie à ce niveau. Par contre, du coup, Nvidia ne parle pas de la puissance de calcul en simple précision qui sera comprise entre 1040 à 1260 Gflops contre 933 Gflops pour les cartes Tesla C1060 et 1036 Gflops pour les GPUs du système Tesla S1070. Des chiffres qui sont alors tout sauf impressionnants sur le papier, d’autant plus par rapport au GPU haut de gamme d’AMD, Cypress, qui affiche 544 Gflops en double précision et 2720 Gflops en simple précision.
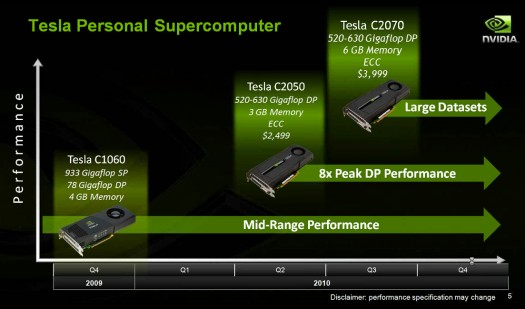
Mais il faut rappeler que Fermi dispose d’une architecture nettement plus évoluée, notamment au niveau du sous-système mémoire et que la puissance de calcul des cartes Tesla actuelles est quelque peu surévaluée, Nvidia ayant décidé, pour afficher des chiffres 50% plus élevés, d’inclure certaines unités de calcul qui ne sont que partiellement exploitables en pratique. L’un dans l’autre, les Tesla série 20 apporteront donc un gain conséquent en simple précision également, bien que cela ne saute pas aux yeux au niveau des chiffres officiels. Reste que par rapport à l’offre AMD, et en ignorant la couche logicielle plus avancée chez Nvidia, il est difficile de tirer des conclusions sur base de ces chiffres sans avoir pu voir ce dont est capable Fermi en pratique.
Faut-il s’inquièter de cette fréquence relativement faible ? Elle pourrait en effet témoigner d’un souci au niveau de la production de cette puce très complexe qui représente pas moins de 3 milliards de transistors. Il est également possible que Nvidia ait décidé de réserver les GPUs qui tiennent les plus hautes fréquences aux GeForce, ce serait cependant étonnant puisque la gamme Tesla exploite en général les meilleurs échantillons pour garantir une fiabilité optimale.
La raison pourrait donc plutôt provenir de la consommation de la carte et de son déploiement dans les plateformes existantes. Nvidia annonce une consommation maximale de 225W (consommation typique de 190W) pour une carte Tesla C2070 et une consommation maximale de 1200W (consommation typique de 900W) pour un système Tesla S2070. Pour info une carte Tesla C1060 est annoncée avec une consommation maximale de 190W et un système Tesla S1070 à 800W (consommation typique de 700W). Une gourmandise qui pourrait rendre la montée en fréquence difficile, d’autant plus que Nvidia doit vouloir réutiliser les plateformes actuelles pour éviter de devoir en redévelopper et revalider de nouvelles et ainsi perdre beaucoup de temps alors que la stratégie semble être de commercialiser les dérivés Tesla au plus vite, soit au second trimestre 2010.
Enfin, il est également possible que l’architecture Fermi soit tout simplement suffisamment efficace que pour pouvoir se contenter de fréquences réduites, d’autant plus que son exploitation plus aisée suffira à convaincre de nombreux développeurs, nous n’avons aucuns doutes à ce sujet. Reste bien entendu à voir ce que Nvidia nous réserve du côté des GeForce : quelles seront les fréquences et les spécificités graphiques de cette architecture ?
M9188 : 8 écrans par carte chez Matrox!
Matrox a annoncé la sortie de la M9188 qui dispose de pas moins de huit mini Display Ports ! Dotée de 2 Go de mémoire, la carte PCI-E x16 peut ainsi gérer par moins de 8 affichages dans une résolution maximale de 2560x1600 par sortie. Matrox fournit des adaptateurs miniDP vers DP ainsi que des adaptateurs miniDP vers DVI, mais on est dans ce dernier cas limité au 1920x1200 par sortie. Le GPU embarqué offre un niveau de fonctionnalité de type Direct3D 9 / OpenGL 2.0.
L'application PowerDesk permet de gérer les huit affichages selon différents modes : Desktop étendu, clone, desktop unique (avec différentes résolutions et taux de rafraichissement), ou en mode divisé superposé ou en ligne. Le tout sous tous les OS Microsoft de Windows XP à 7 ainsi que sous Linux. Notons que le mode étendu n'est pour l'instant pas supporté sous Windows 7.


Matrox a également annoncé la sortie d'une carte basée sur le même principe mais avec deux mini Display Port. La M9128 LP est donc une version économique de la M9188, les deux étant proposées aux prix respectifs de 259.00$ et 1995.00$ avec une disponibilité prévue pour Q4 2009.
Bench de l'HydraEngine
HotHardware nous propose les premiers benchmarks concernant l’Hydra Engine implémenté au sein de l’Hydra 200 de LucidLogix. Ces résultats n’ont toutefois pas été obtenus sur une MSI Big Bang Fuzion mais sur un système de test spécial simulant l’architecture sans carte mère spécifique, puisqu’il s’agissait d’une carte mère Gigabyte X58 accueillant une carte fille Hydra 200, elle-même connecté à une autre carte d’évaluation accueillant les cartes graphiques.

Les résultats sont plutôt convaincants, puisque sous les trois jeux testés qui sont Operation Flash Point : Dragon Rising, Call Of Juarez et Stormrise la hausse de performances est de 72% en passant de 1 à 2 Radeon HD 4890 et de 81% en passant de 1 à 2 GeForce GTX 260.
Mieux encore, le mix & match permettant de coupler la Radeon HD 4890 et la GeForce GTX 260 offre lui aussi des gains de performances! Reste que par exemple, la configuration était instable sous 3DMark Vantage et que l’on peut supposer que ce test ayant été effectué sous l’égide de LucidLogix, ce dernier avait installé sur sa configuration les jeux qui fonctionnaient le mieux. La technologie Hydra Engine est donc prometteuse, reste à voir si LucidLogix arrivera à des drivers offrant la qualité nécessaire à un produit commercialisé.
Les 5 actualités précédentes

