

Actualités cartes graphiques
 Les 5 actualités précédentes
AMD Catalyst 11.6
AFDS: AMD dévoile la FSA pour OpenCL
AFDS: L'architecture des futurs GPUs AMD!
AFDS: OpenCL gagne du terrain ?
AFDS: AMD Fusion 11 Developer Summit

GeForce 550 Ti tri-écran chez Zotac


Après la 560 Ti, Zotac annonce un second modèle de carte graphique Nvidia capable de piloter trois écrans en simultanée. Il s'agit cette fois de la 550 Ti. Côté caractéristiques on retrouve encore les fréquences des cartes de références (900 MHz pour le GPU, 2050 pour les 1 Go de mémoire GDDR5 embarqués).

A l'image du modèle précédent, si la carte dispose de cinq sorties (2 DVI, 2 HDMI et un DP), pour utiliser le mode tri écran il faut impérativement utiliser les deux ports HDMI conjointement à un DP ou un DVI. Zotac ne communique pas encore de date de disponibilité ou de prix pour cette carte, la 560 Ti multiview n'est pour l'instant toujours pas disponible.
2.5 Go de mémoire pour une GTX 570
Après les GTX 580 équipées de 3 Go de mémoire au lieu de 1.5, c'est au tour des GeForce GTX 570 d'avoir droit au traitement du doublage mémoire. C'est EVGA qui est le premier à proposer une telle carte. Pas de surprise du côté des fréquences puisque l'on à droit à celles de références (732 MHz pour le GPU, 1.9 GHz pour la mémoire), on notera par contre la présence d'un connecteur Display port en plus des deux DVI et du HDMI.

Selon la photo disponible sur le site du constructeur , cette carte utilisera un radiateur de 560 Ti en lieu et place du radiateur plus performant (et couteux) de la GTX 570, quelque chose que l'on avait déjà par exemple chez Point Of View . Le prix public est annoncé à 400 dollars, soit 50 de plus que pour la version classique (1280 Mo) de la carte chez le même constructeur.
Pilotes GeForce 275.50 beta
 Nvidia vient de rendre disponible une nouvelle version beta de ses pilotes GeForce. La plus grosse nouveauté concerne le support du SLI, qui fonctionnera désormais avec les cartes mères AM3+ certifiées. A l'image de ce qu'avait fait la marque pour les chipsets Intel, les constructeurs de carte mère peuvent prendre une licence SLI pour leurs modèles de cartes utilisant les chipsets dédiés aux futurs AMD FX (les chipsets séries 900 d'AMD).
Les pilotes mettent également à jour les profils 3D Vision de Duke Nukem Forever et d'Alice Madness Returns. De nouveaux profils 3D Vision ont été ajoutés pour Rise of the Immortals, Rusty Hearts, le benchmark Mars et la version démo de Duke Nukem Forever. Les pilotes 275.50 beta sont disponibles sur le site de Nvidia .
AFDS: Microsoft annonce C++ AMP
Microsoft a choisi l'AFDS pour présenter une nouvelle version de C++ optimisée pour l'exploitation des GPUs, et potentiellement de tout autre accélérateur. Baptisée AMP pour Accelerated Massive Parallelism, cette extension vient compléter C++0x et la Parrallel Patterns Library (PPL) pour faciliter l'écriture du code qui va inclure des fonctions destinées à être accélérées par le GPU.
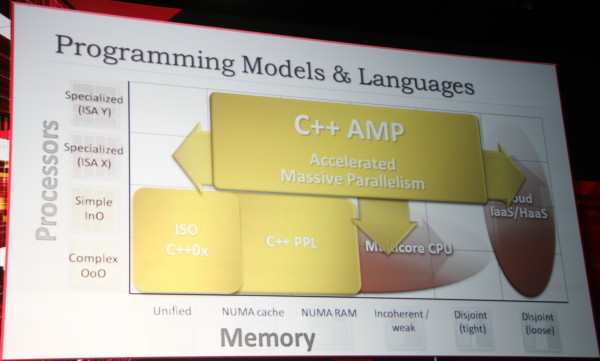
Herb Sutter, Software Architect chez Microsoft et guru du C++, a insisté sur l'importance de ne pas complexifier le langage et de se contenter d'ajouts aussi simples que possibles en profitant de la signification implicite qu'ils peuvent amener pour laisser le compilateur se charger de toute la lourdeur qui est liée à l'utilisation de tels accélérateurs.
Seules deux nouveautés font ainsi leur apparition au niveau du langage. La première, array_view, permet de représenter une mémoire non uniforme, incohérente et/ou disjointe sans avoir à spécifier explicitement des .copy()/.sync(). Un niveau d'abstraction qui simplifiera nettement le code.
La seconde se nomme restrict(). Comme son nom l'indique, elle permet de spécifier des restrictions liées à une certaines architecture pour certaines fonctions. Celles-ci concernent les limitations inhérentes aux accélérateurs actuels et indiquent implicitement qu'il s'agit d'un morceau de code au parallélisme important qui pourra être exécuté sur le GPU. Dans la première version de C++ AMP préparée par Microsoft, il est question de viser l'API maison DirectCompute 11 en utilisant simplement restrict(direct3d), restrict(cpu) étant le mode par défaut implicite. Dans le futur Microsoft envisage un restrict(pure) qui n'aurait aucune restriction mais permettrait de déclarer le parallélisme au compilateur.
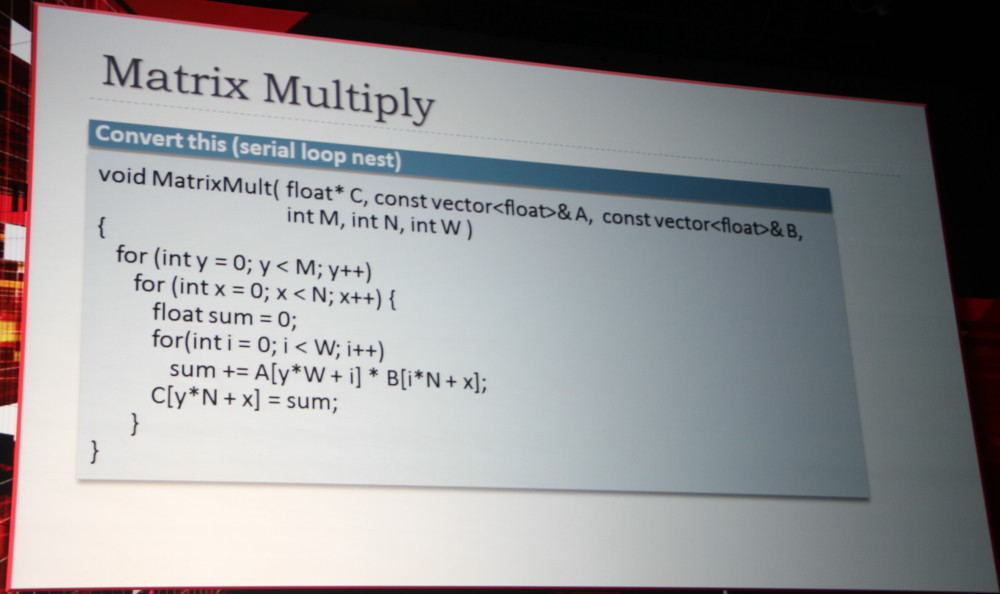

A gauche du code classique, à droite en version C++ AMP.
Aucun autre élément de langage ne sera introduit, tout le reste étant implicite. Par exemple attacher une variable à "const" sera interprété comme du "read only". Microsoft précise cependant à ce sujet qu'il n'y a actuellement aucun moyen similaire pour spécifier que des éléments sont "write only", ce qui pourrait être utile dans le futur.
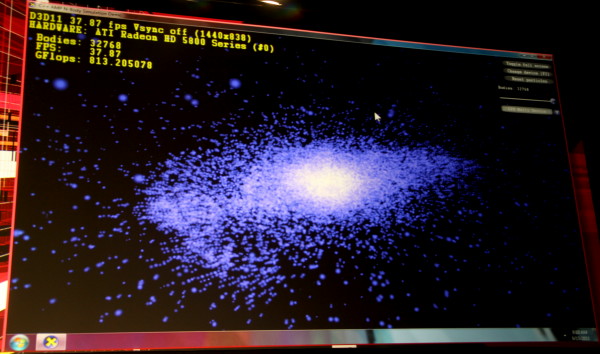
Une démonstration réalisée par Microsoft a mis en avant la possibilité, avec un seul exécutable, de profiter de tout type de matériel : CPU, GPU, APU, APU + GPU, double GPU…
Tout ceci devrait faire son apparition dans la prochaine version de Visual Studio. Par ailleurs Microsoft entend faire de C++ AMP un standard ouvert de manière à ce qu'il puisse être exploité sur différentes plateformes, que ce soit au niveau de l'interface compute ou du système d'exploitation. Herb Sutter a ainsi directement annoncé travailler avec AMD de manière à ce que ce dernier puisse en proposer une version FSA. ARM semble également intéressé par cette évolution. De son côté, Nvidia semble avoir été surpris par cette annonce et s'est empressé de publier sur son blog accueillir toute évolution qui facilite l'exploitation de la puissance de calcul des GPUs en précisant que la version d'AMP initiale visant DirectCompute11, ses GPUs en profiteraient également. Pas un mot sur une version CUDA d'AMP par contre…
AFDS: Retour sur le futur GPU d'AMD
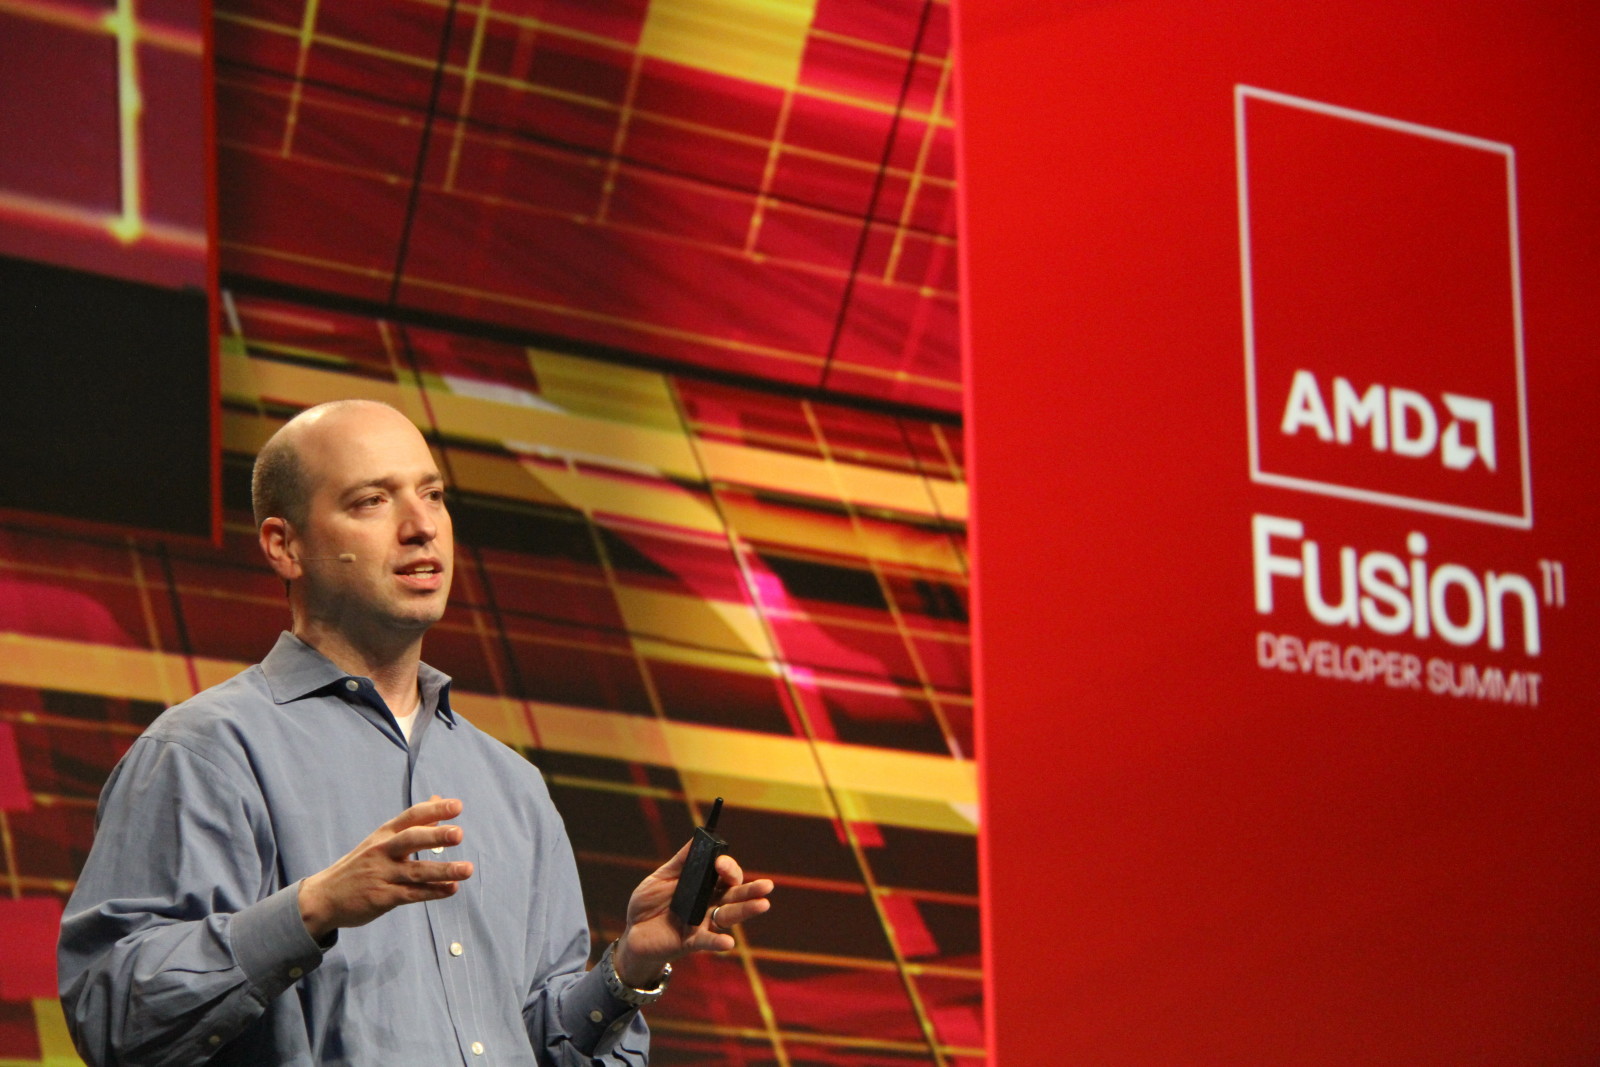
Lors du dernier keynote de l'AFDS, Eric Demers, Chief Technology Officer pour la partie GPU chez AMD, est revenu sur la future architecture GPU qui a été présentée avec de très nombreux détails cette semaine, de manière à en mettre en avant les grandes lignes d'une manière simplifiée. Il a également été confirmé qu'AMD espérait lancer cette architecture à la fin de l'année, si le procédé de fabrication 28nm n'entrave pas ces plans.
Eric a rappelé que l'évolution des GPUs ATI/AMD nous a fait passer d'une architecture au comportement vec4 + 1 vers une architecture vec5 à partir des Radeon HD 2900 puis enfin vers une architecture vec4 avec les Radeon HD 6900 qui sera déclinée dans de futurs GPUs milieu et bas de gamme ainsi que dans Trinity. Ces choix architecturaux s'expliquent par la présence de nombreuses opérations vec4 mais aussi scalaires dans le rendu graphique qui reste la tâche principale des GPUs. La flexibilité des unités de calcul de type MIMD/VLIW des derniers GPUs a permis de se passer du canal scalaire et de laisser le compilateur se charger de mixer toutes les opérations dans les 5 ou 4 canaux disponibles.
Avec sa future architecture, AMD a voulu conserver une organisation similaire. Si le modèle VLIW est abandonné, les blocs fondamentaux de ces GPUs vont garder ces 4 canaux, non pas pour exécuter des opérations vec4 mais pour conserver un ratio similaire et vu comme le plus adapté pour le graphique. Les tâches de type "compute" devenant de plus en plus importantes et affichant souvent une utilisation moindre des unités vec5 ou vec4, il fallait revenir à un modèle scalaire du point de vue du programmeur.
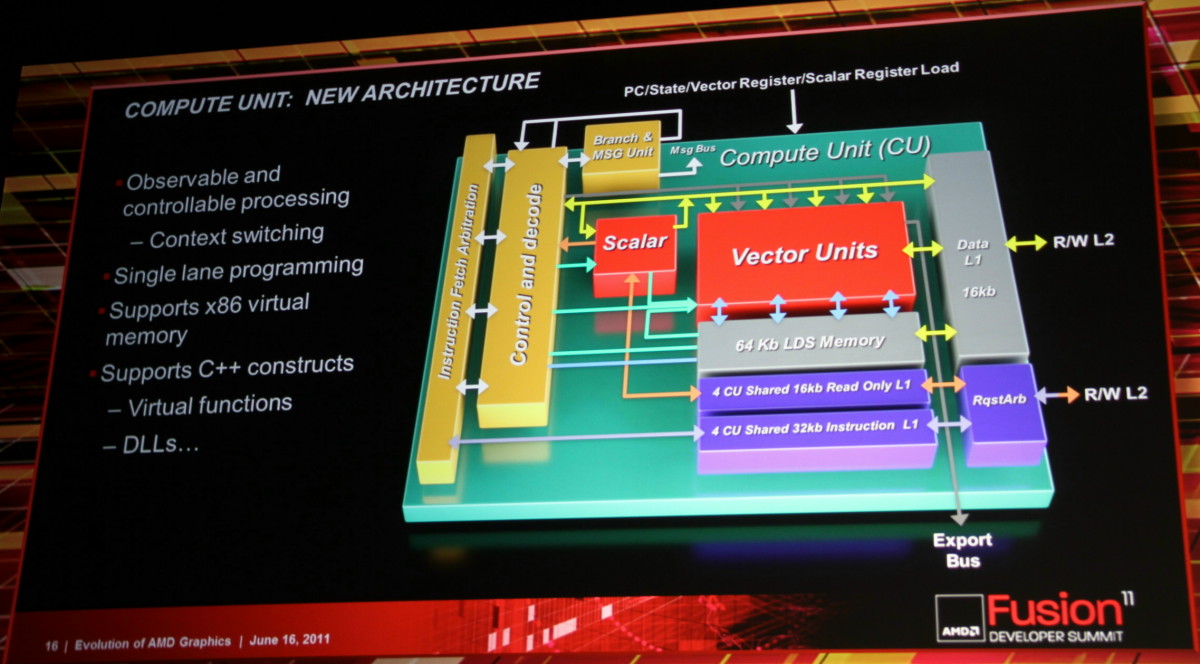
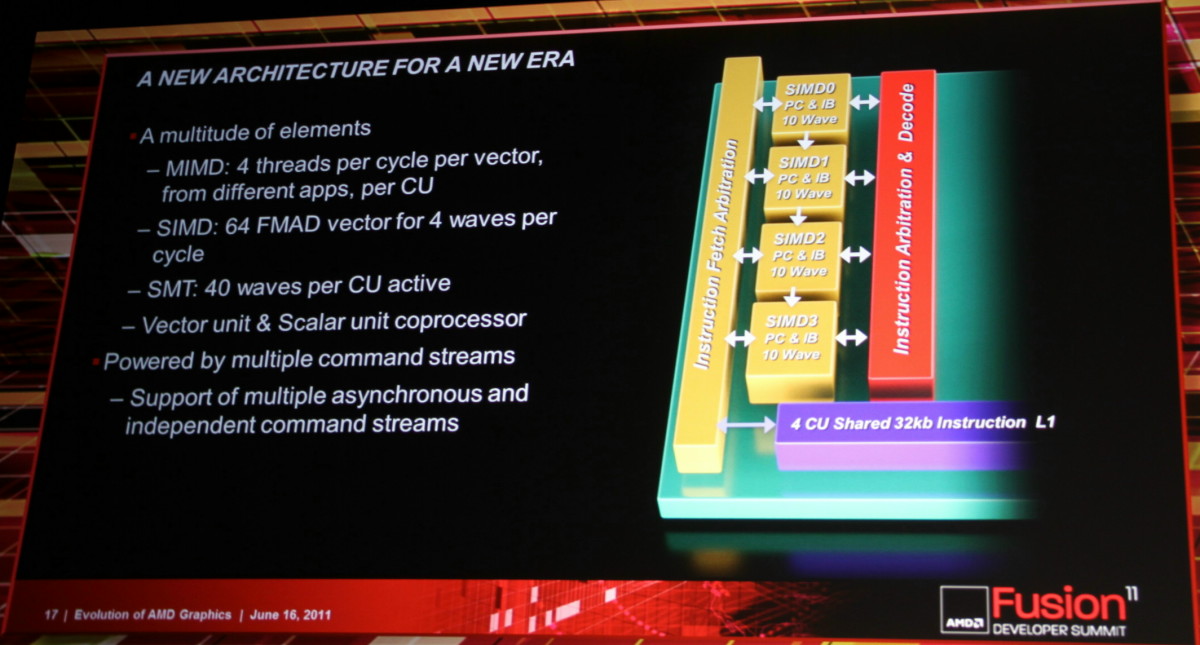
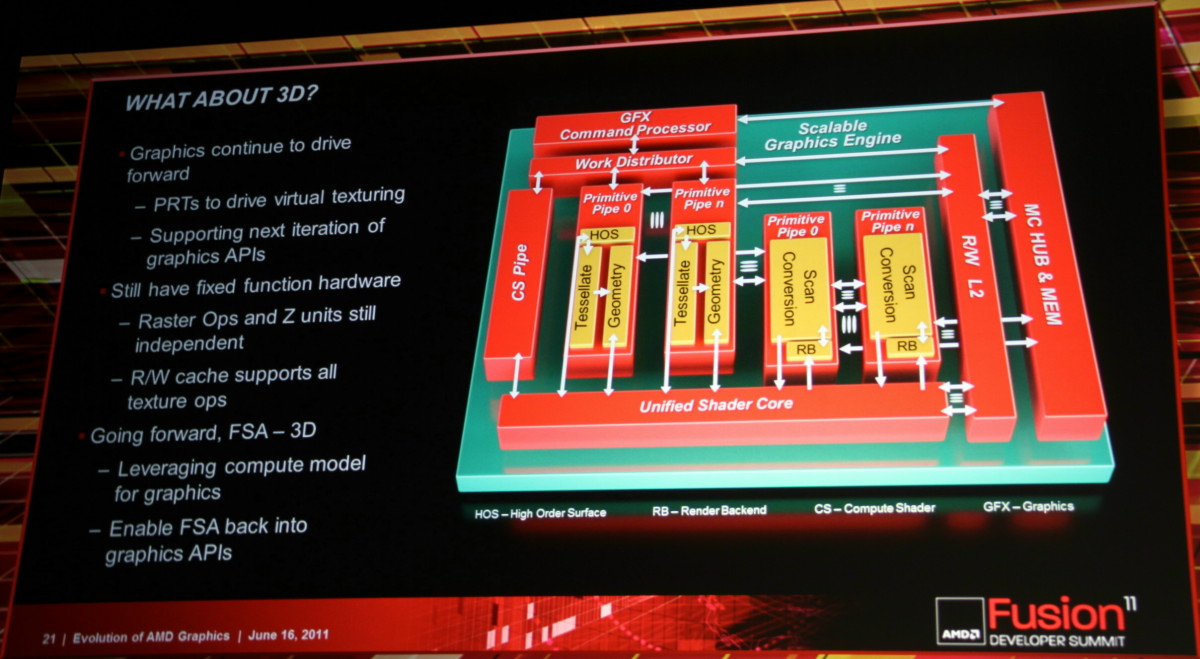
L'architecture proposée par AMD permet de combiner ces deux aspects en plaçant dans chaque Compute Unit non pas une grosse unité MIMD mais 4 plus petites unités SIMD indépendantes. Par ailleurs, AMD leur adjoint une unité scalaire qui sera destinée à éviter de monopoliser la puissance de calcul vectorielle par des opérations simples. Comme pour les blocs fondamentaux des GPUs actuels, chaque CU recevra 4 unités de texturing. Une CU est donc, sur le plan des unités d'exécution, très proche de ce qu'AMD appelle actuellement les SIMDs. C'est au niveau de l'exploitation de ces unités d'exécution que le changement est radical. Le GPU Cayman des Radeon HD 6900 peut d'ailleurs être vu comme une étape intermédiaire vers cette nouvelle architecture. Un côté hybride/prototype qui explique probablement son efficacité discutable.
Un autre aspect important de la nouvelle architecture est le multitâche puisque ces nouveaux GPUs seront capables de gérer différentes commandes simultanément ainsi que la priorité à donner à chacune d'elles. Tout ceci se passera au niveau du GPU et non au niveau du système d'exploitation.
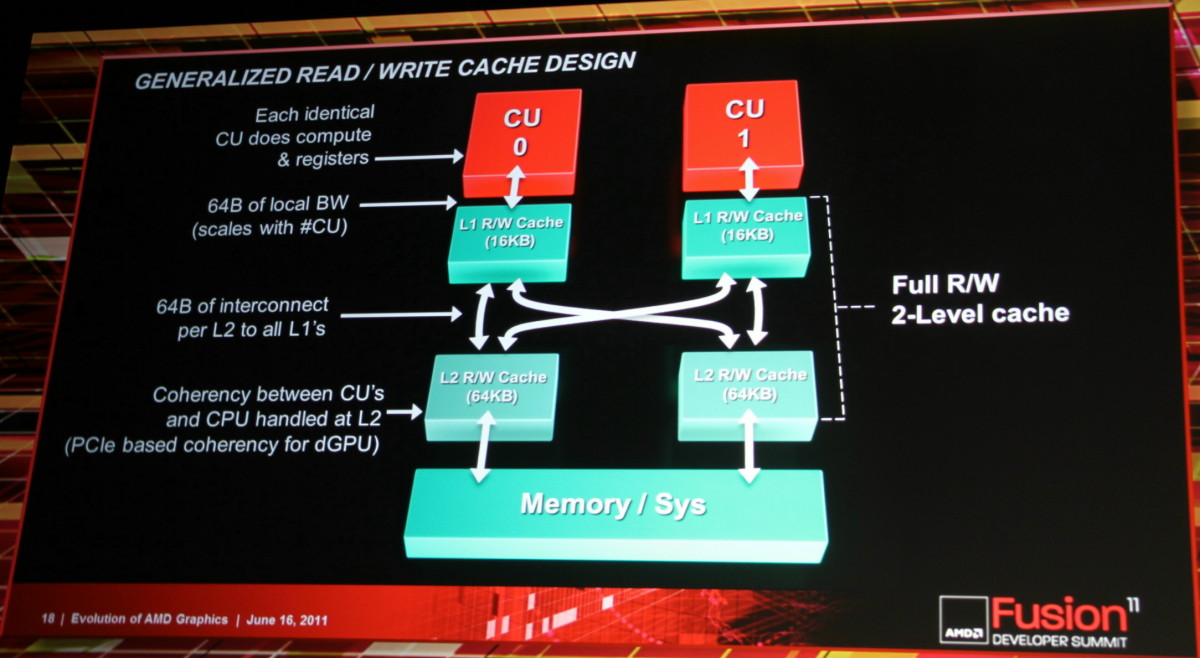
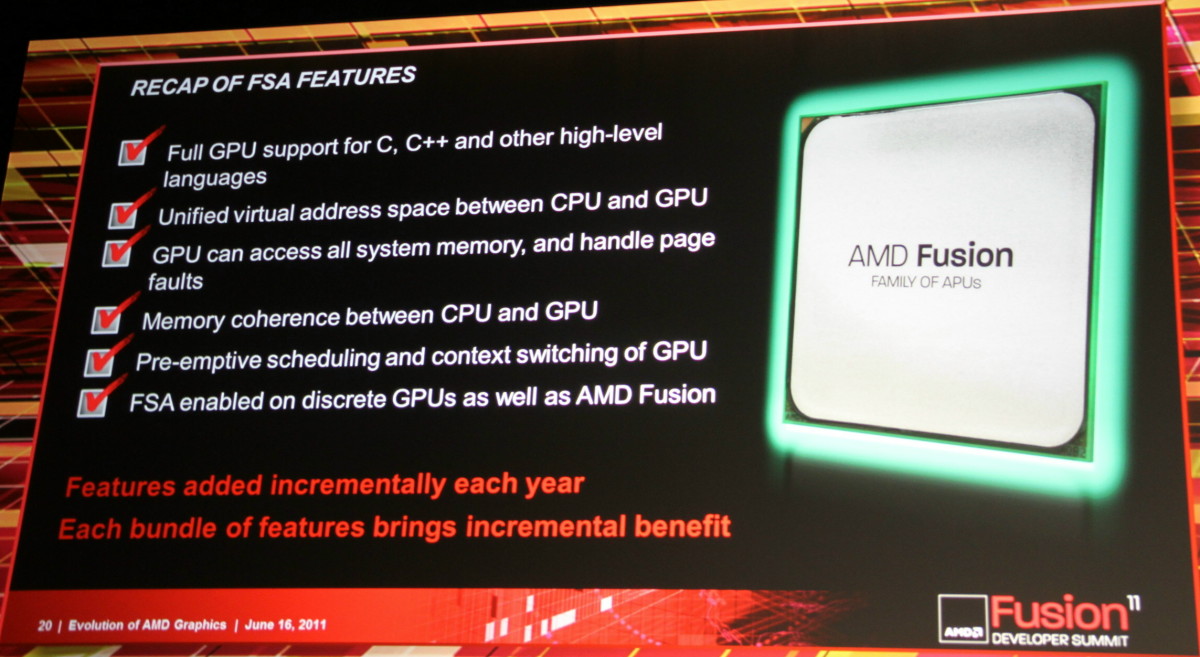
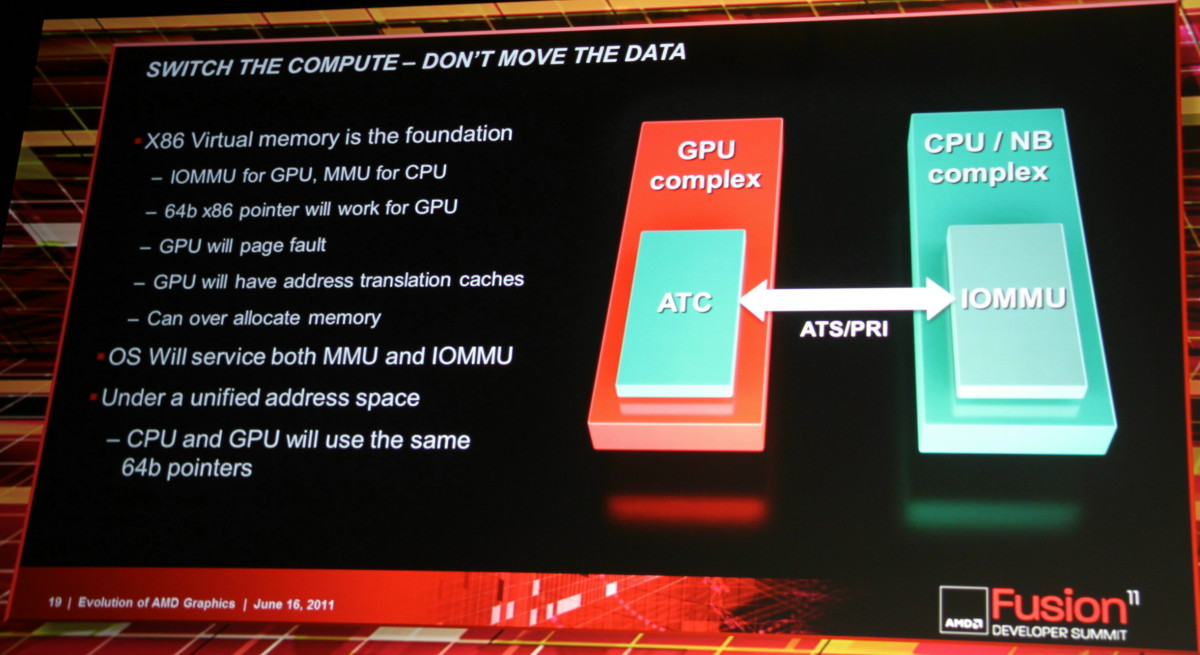
Le cache L2 utilisable en lecture et en écriture est la troisième grosse évolution. Il permet également l'existence d'un espace cohérent entre toutes les CUs ainsi qu'avec le CPU, que ce soit à l'intérieur d'un APU ou avec une carte graphique dédiée.
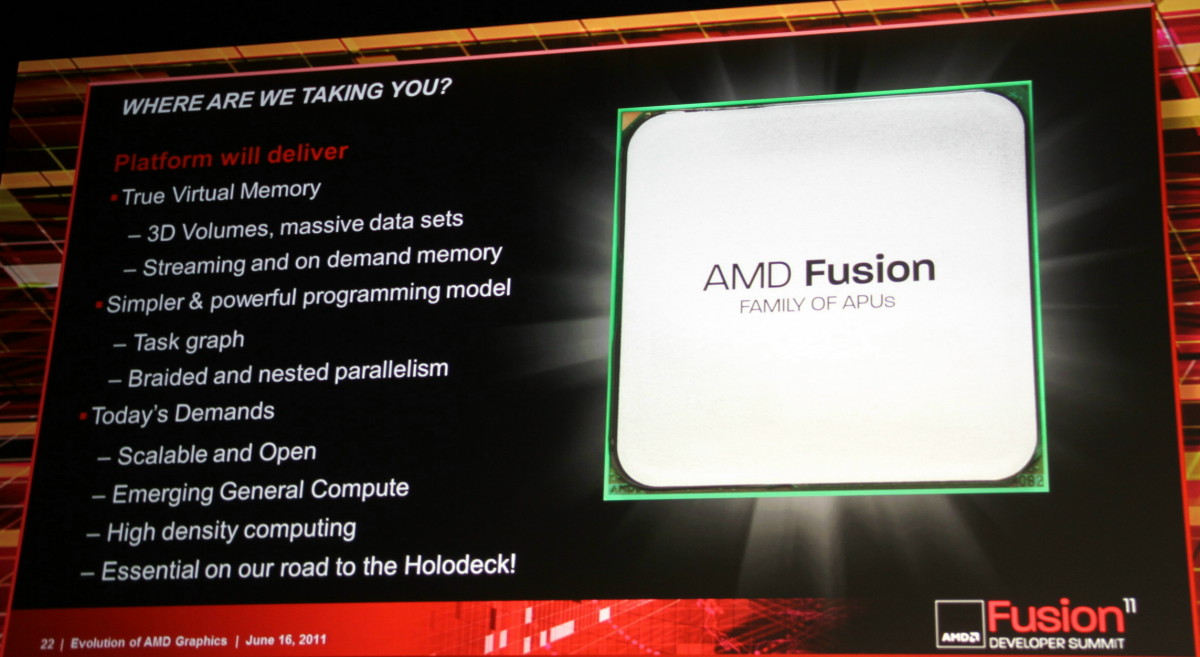
Ce cache L2 généralisé, le fonctionnement scalaire des unités de calcul, le support de l'espace mémoire virtuel x86 et du C++ vont faire exploser l'intérêt du GPU computing. Notez cependant que sur certains de ces points, AMD ne fait que rattraper le retard pris sur Nvidia.
Une interrogation importante que nous avons par rapport à cette nouvelle architecture est son efficacité énergétique. Comme nous avons pu le voir avec les Radeon HD 6970, elle était quelque peu en baisse. Augmenter le rendement d'une Compute Unit va donc faire progresser sa consommation relative. Si le procédé de fabrication 28nm permettra d'en faire baisser la consommation absolue, la question reste importante.
Nous avons pu nous entretenir avec Eric Demers à ce sujet et selon lui il s'agit d'un faux problème. Dans l'architecture actuelle, quand certaines lignes des unités vec4 ou vec5 ne sont pas utilisées, elles restent alimentées. Leur consommation est moindre que quand elles sont exploitées, mais elles gaspillent malgré tout beaucoup d'énergie. Ce gaspillage va disparaître avec la future architecture. En d'autres termes, nous nous approcherons probablement plus souvent de la consommation maximale des Compute Units, mais leur rendement énergétique serait dans tous les cas supérieur.
Enfin, nous avons demandé au CTO d'AMD s'il envisageait d'inclure à l'avenir dans les GPUs plus de CUs que ne le permet le TDP, tout en sachant qu'ils ne pourraient pas tous être exploités en rendu 3D (limités par PowerTune par exemple), mais en supposant qu'ils pourraient l'être dans le mode compute qui n'exploite pas certaines parties du GPU très gourmandes telles que les unités de texturing. Eric Demers nous a répondu qu'AMD envisageait effectivement cela et qu'une telle possibilité pourrait éventuellement être retenue à l'avenir, si les simulations le justifiaient, notamment pour un GPU qui viserait le HPC.
Les 5 actualités précédentes

