

Actualités cartes graphiques
 Les 5 actualités précédentes
GTC: Nvidia GPU Technology Conference 2013
Une GeForce GTX 650 Ti Boost en préparation ?
La HD 7790 montre son nez
Pilotes GeForce 314.21 beta
AMD Catalyst 13.3 beta 2

GTC: CUDA on ARM: Tegra 3 + Tesla K20


En plus des plateformes CUDA on ARM destinées à simuler de futurs SoC que ce soit pour une utilisation de type périphérique mobile grand public ou de type micro-serveur, des développements se font également autour d'accélérateurs très puissants tels que les Tesla K20.
C'est le cas chez l'européen PRACE qui développe des systèmes dédiés au supercomputing et s'intéresse à CUDA on ARM depuis quelques temps. En collaboration avec le Barcelona Supercomputing Center, PRACE est en train de mettre au point une plateforme ARM équipée en GK110 : Pedraforca v2. Celle-ci est composée d'une carte mini-ITX sur laquelle prend place un module Q7 Tegra 3 dont 4 des lignes PCI Express 2.0 sont connectées à un switch PLX PCI Express 3.0 sur lequel vont venir se greffer un accélérateur Tesla K20 et une carte contrôleur InfiniBand 40 Gbps.
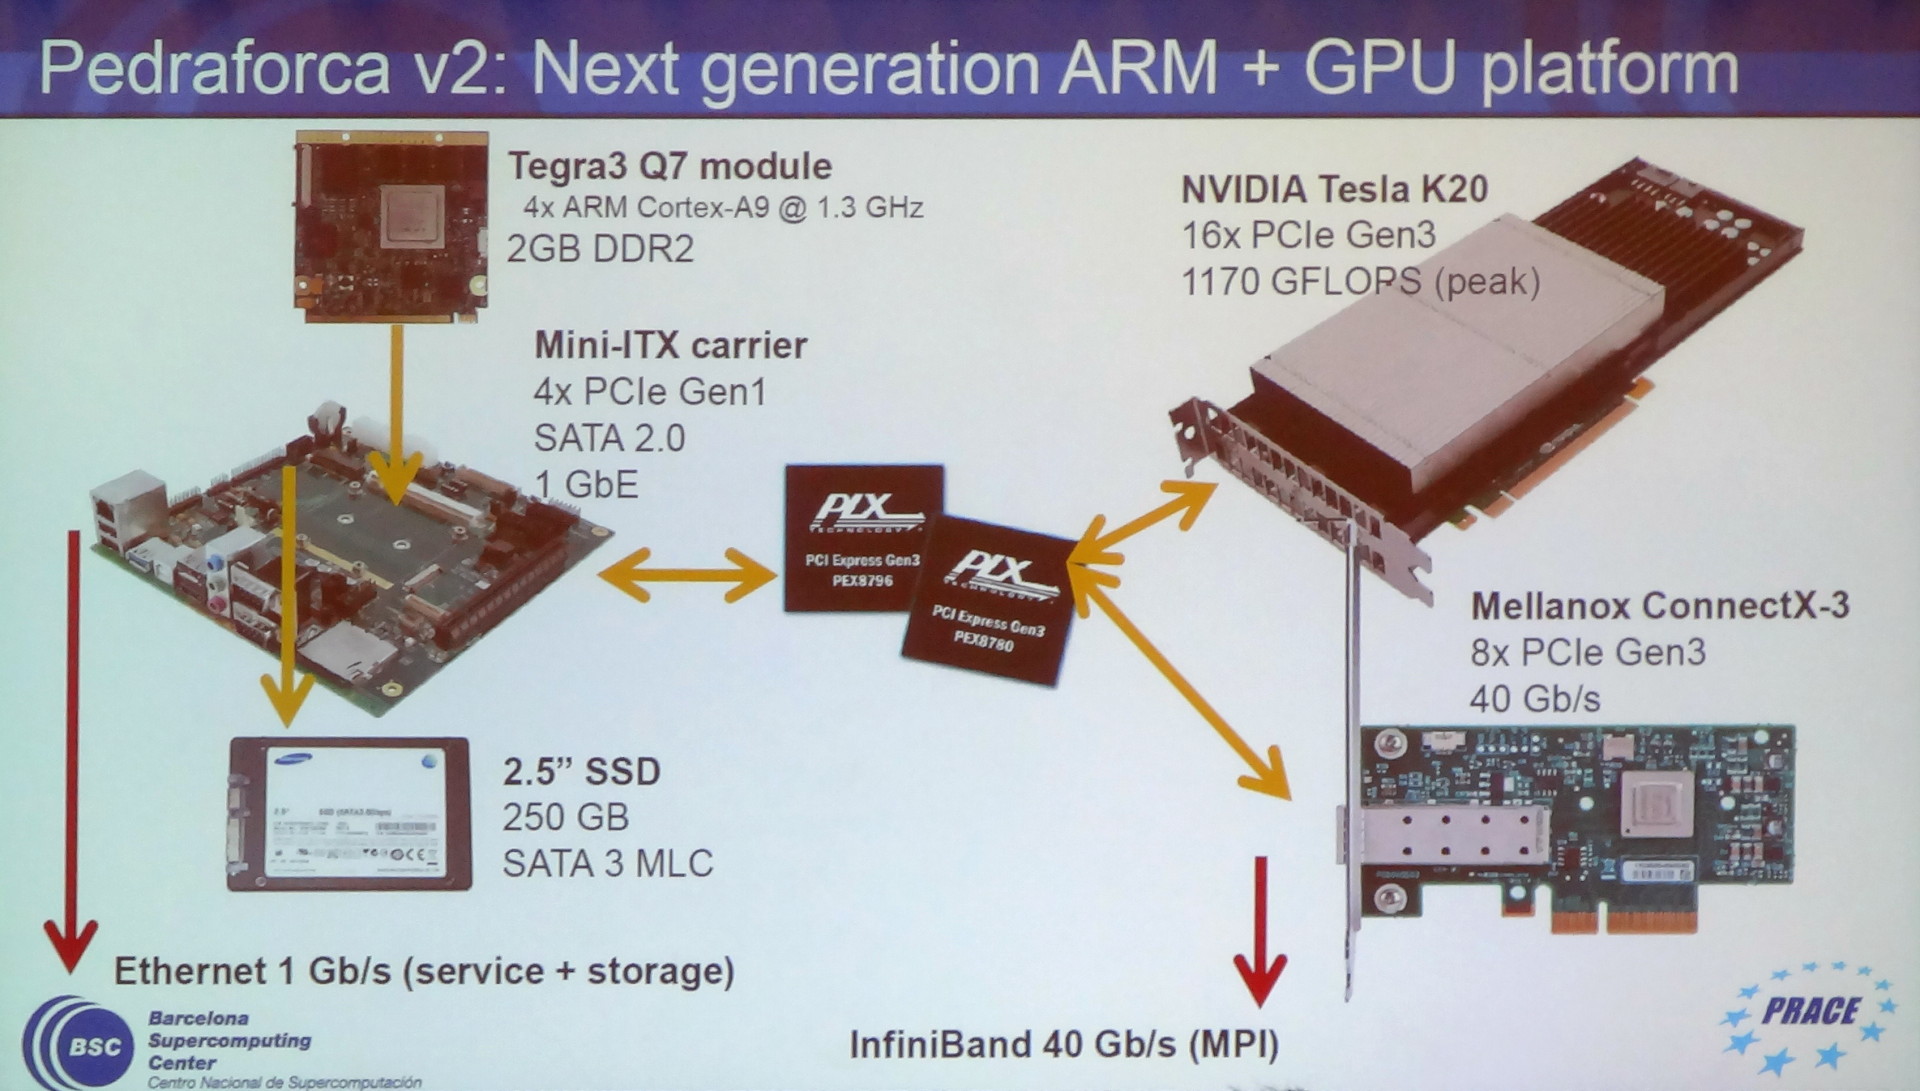
Cette plateforme a la particularité de ne pas rechercher la complémentarité entre les cores CPU et GPU. Grossièrement, le but est d'utiliser le SoC ARM uniquement pour activer un système CUDA plus ou moins indépendant. C'est la raison pour laquelle le Tesla K20 est associé à un contrôleur InfiniBand sur un même switch PCI Express 3.0 : ils peuvent ainsi communiquer très rapidement avec les accélérateurs d'autres nœuds en ignorant autant que possible la communication avec les SoC et leurs mémoires.
Les développeurs de Pedraforca v2 sont bien conscients qu'une telle approche n'est pas une solution de remplacement générale à un système CUDA classique et se contentera de répondre avantageusement à un sous-ensemble de problématiques : si un problème massivement parallèle peut être résolu sans CPU, autant réduire l'encombrement et la consommation de celui-ci.
Une telle solution permet par ailleurs de simuler le comportement de futurs GPU haut de gamme qui pourraient intégrer un ou plusieurs cores ARMv8 Denver pour gagner en indépendance. De quoi commencer à préparer des algorithmes qui leur seront adaptés ?
GTC: CUDA on ARM: Kayla, Tegra 3 et GK208
Nvidia l'a enfin confirmé, CUDA arrivera enfin dans les SoC Tegra avec Logan. Cela ne veut pas dire pour autant que CUDA sur plateforme ARM doit attendre. Il s'agit d'un point important de la stratégie de Nvidia pour son futur autant dans le monde professionnel que grand public. C'est la raison pour laquelle, depuis quelques temps déjà, Nvidia s'est associé à SECO pour proposer un kit de développement dénommé CARMA. Pour 529€, la plateforme propose un connecteur Q7 qui reçoit un SoC Tegra 3 (T30 à 1.3 GHz) et un connecteur MXM sur lequel prend place une Quadro 1000M de génération Fermi (GF108 avec 96 cores).
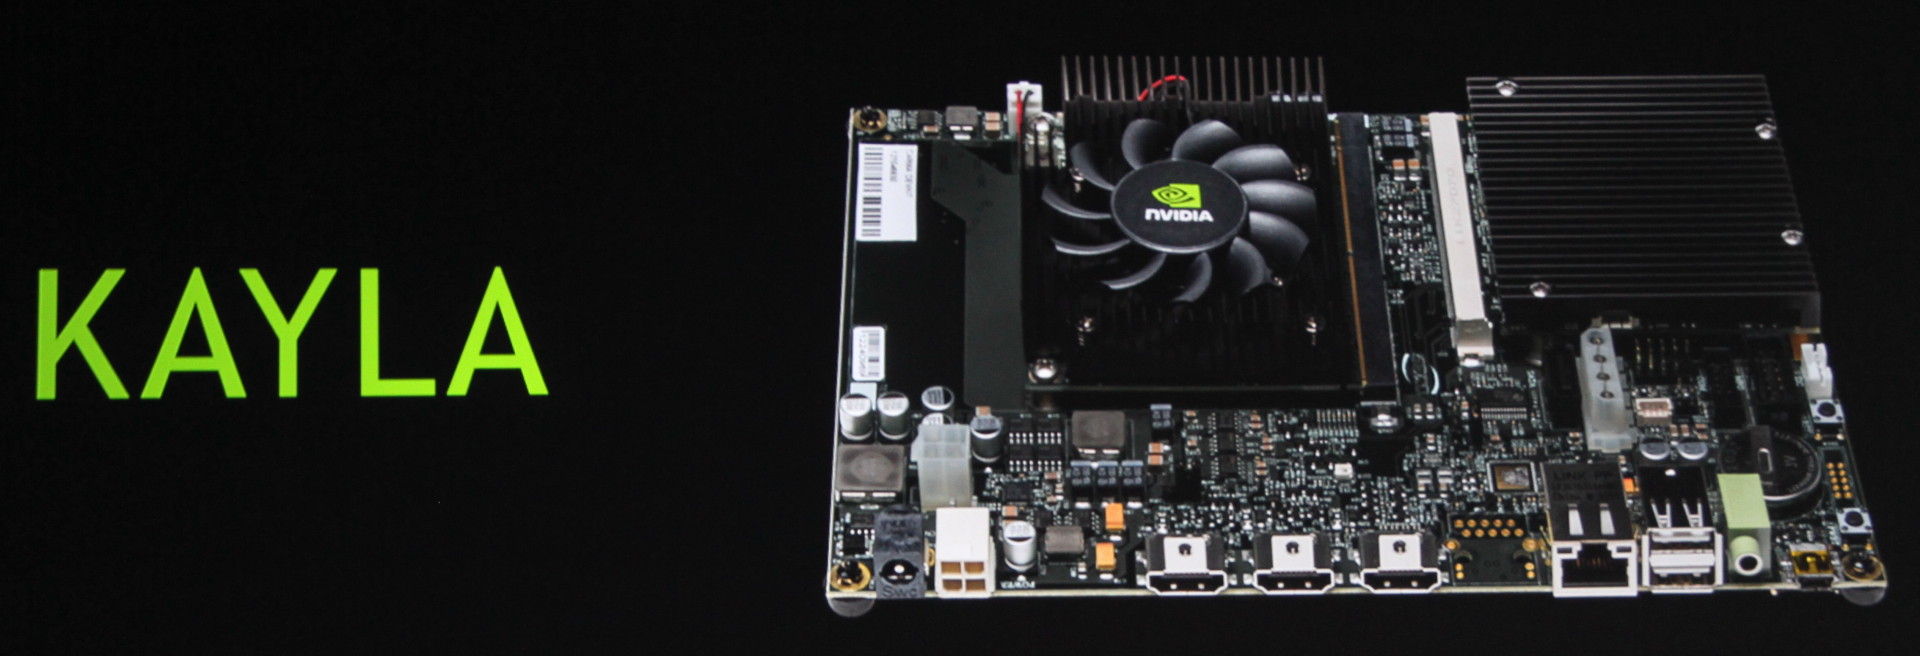
Tout cela va évoluer à partir du mois de mai, d'une part avec une couche logicielle qui supportera Ubuntu 12.04 et CUDA 5.0, et d'autre part avec la plateforme KAYLA, toujours développée en partenariat avec SECO, et qui existera en 2 versions : connecteur MXM ou PCI Express (câblés en 4x dans les 2 cas). Si nous aurions pu supposer que le SoC passerait en version Tegra 4, c'est bel et bien le Tegra 3 T30 qui reste exploité pour la simple et bonne raison que ses successeurs ne disposent plus de liens PCI Express. La différence (unique ?) entre les 2 cartes concerne les GPU supportés. La version PCI Express en supporte un large choix et la version MXM est annoncée être équipée d'un GPU Kepler de next generation.
Nvidia indique à ce sujet que ce GPU dispose de 2 SMX (384 cores), supporte les compute capabilities 3.5 (Dynamic Parallelism etc.) et est très proche du niveau de fonctionnalité du futur SoC Logan. Nous apprenons ainsi que le GPU de cette plateforme et celui de Logan disposent d'un processeur de commande plus évolué que sur les premiers GPU de la génération Kepler, dérivé de celui du GK110 (Tesla K20 et GTX Titan).
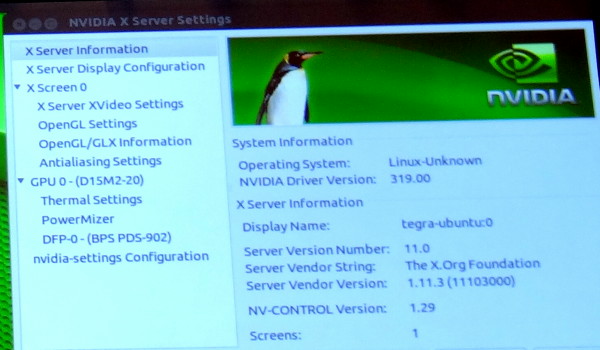
De toute évidence ce GPU est ainsi le GK208 qui prendra place dans les GeForce 700 d'entrée de gamme. Une supposition renforcée par un panneau de contrôle des pilotes Linux que Nvidia a malencontreusement oublié de masquer pendant quelques secondes et qui fait référence à un nom de code produit : D15M2-20. Cela correspond à la famille GeForce 700 desktop (D12 = GeForce 400, D13 = GeForce 500, D14 = GeForce 600…).
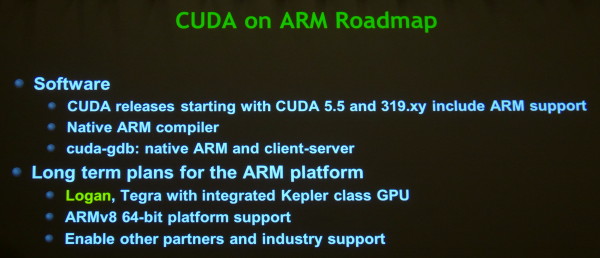
Cette plateforme CUDA on ARM continuera bien entendu à évoluer, tout d'abord avec CUDA 5.5 qui intégrera un compilateur CUDA pour l'architecture ARM, et plus tard avec l'arrivée de Logan et de Parker.
Correction du 01/07/2013: le nom du GPU que nous pensions être GK117 est en réalité GK208.
GTC: GPU: Maxwell puis Volta et DRAM stacking
Jen-Hsun Huang a profité de la keynote d'ouverture de la GTC pour mettre à jour la roadmap GPU globale de Nvidia. Pour rappel, après la génération Kepler actuelle, c'est la génération Maxwell attendue pour 2014 et fabriquée en 20nm qui représentera la prochaine évolution majeure avec le support d'une mémoire virtuelle unifiée, attendue depuis longtemps dans le monde du GPU computing.
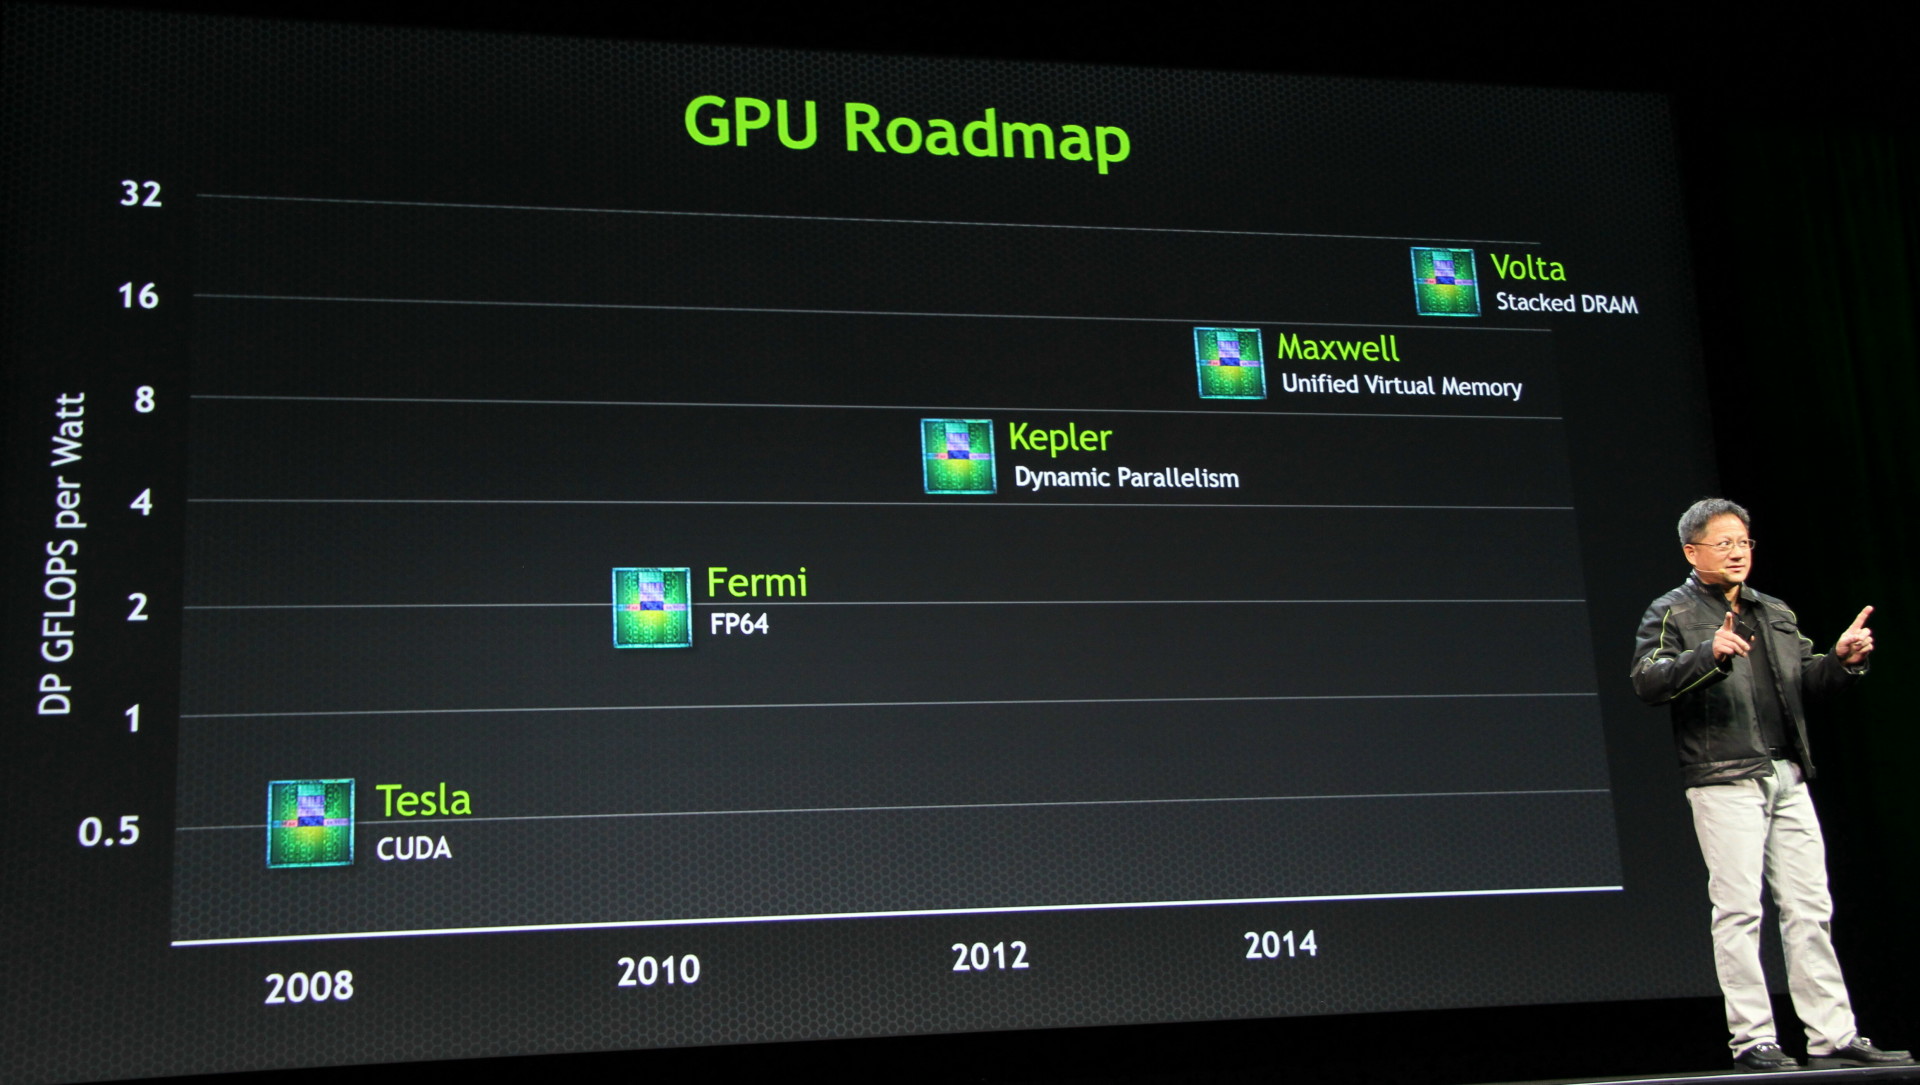
Nvidia dévoile aujourd'hui la prochaine étape, nom de code Volta, en évitant de s'avancer trop précisément sur le timing, il dépend de nombreux facteurs dont certains extérieurs tels que le process 14nm, mais en la situant plus ou moins vers 2016. Quelle sera l'évolution la plus importante introduite sur cette future génération ? La mémoire empilée, ou DRAM stacking, qui consistera à placer plusieurs dies de DRAM au-dessus du die du GPU avec une connexion directe vers ce dernier à travers des vias.
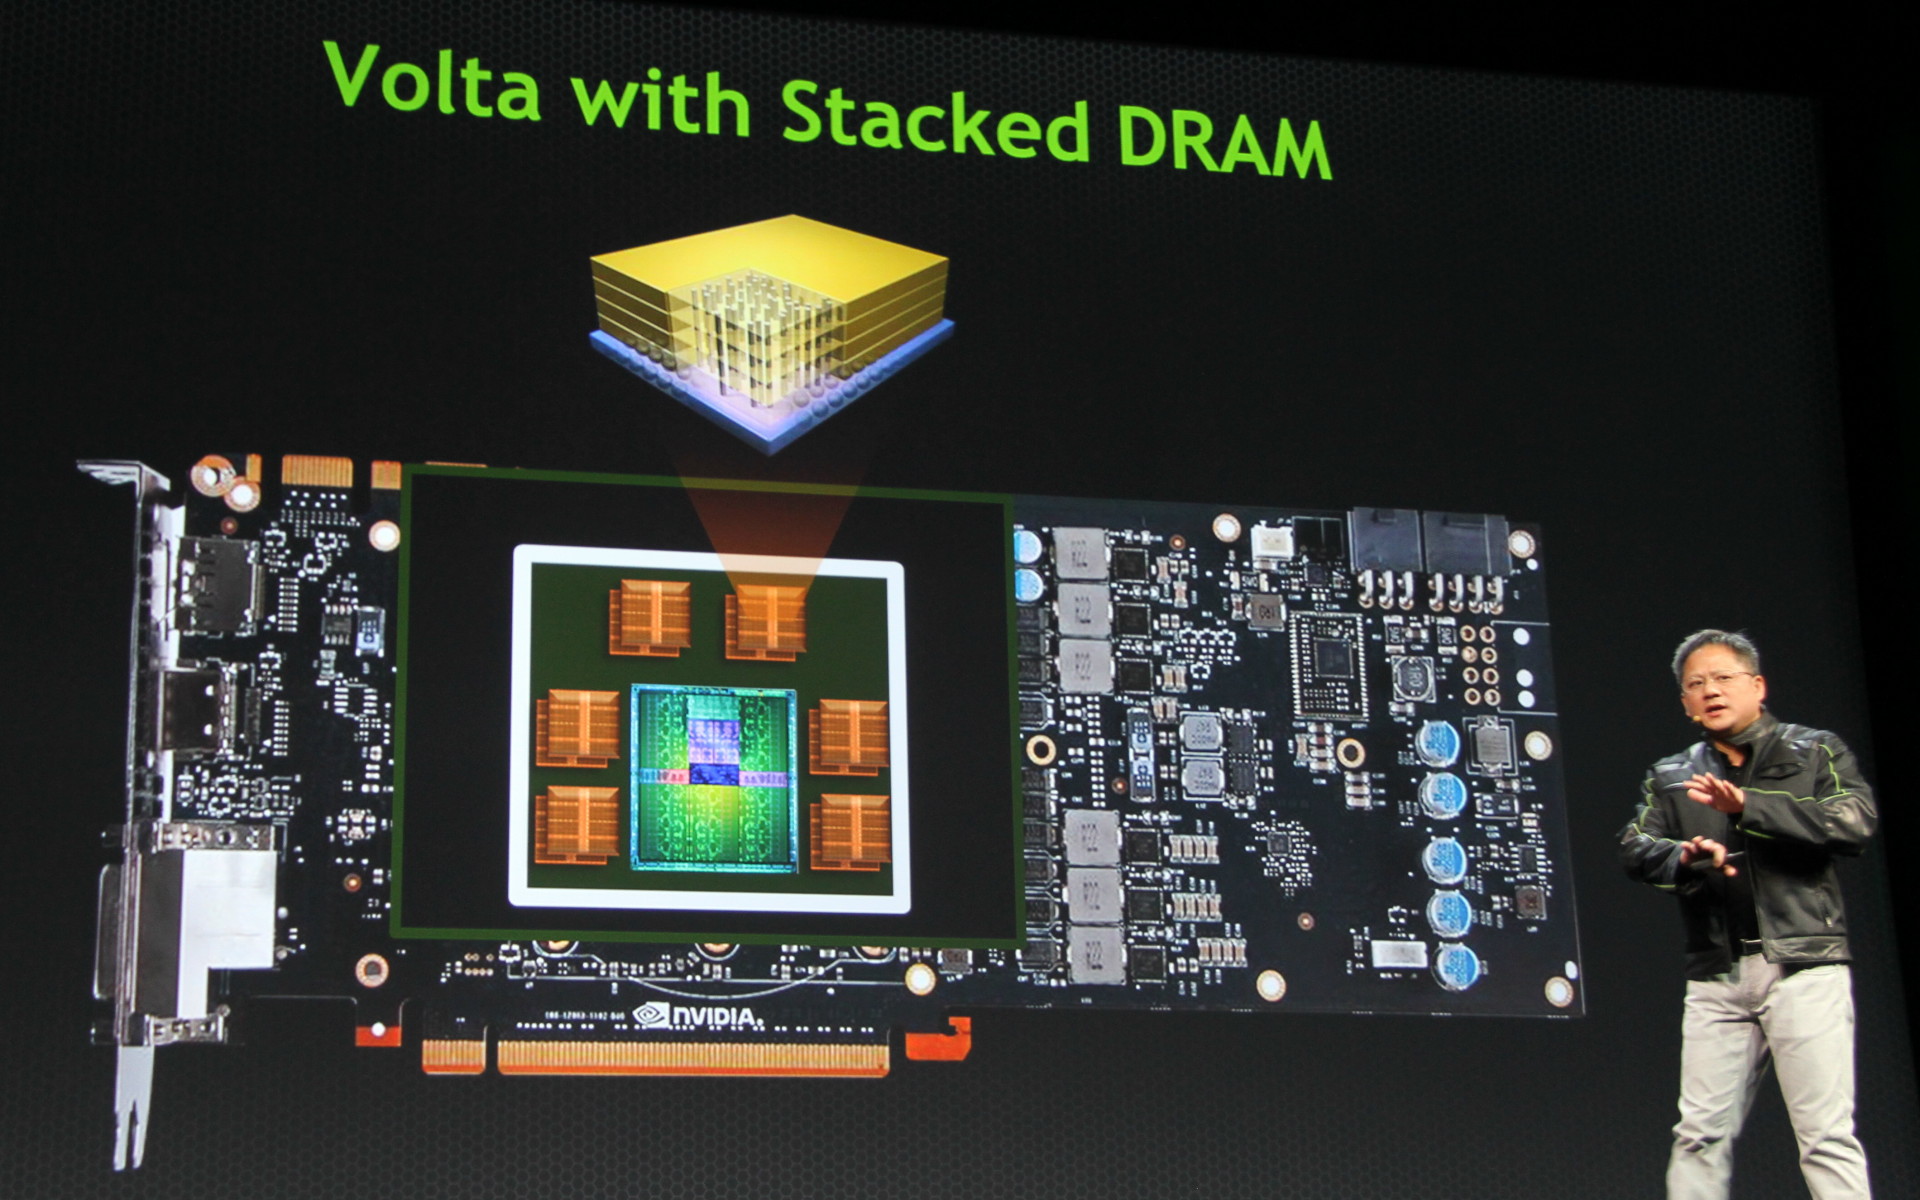
Au prix d'une complexification de la production du GPU et de son packaging, éviter ainsi de passer par le PCB permettra de conserver plus facilement un signal de qualité en montant en fréquence voir en élargissant le bus mémoire. Nvidia vise alors une bande passante mémoire de l'ordre du téraoctet par seconde, soit un quadruplement par rapport à ce dont dispose une carte graphique haut de gamme actuelle telle que la GeForce GTX Titan.
Comme à son habitude, Nvidia communique sur une estimation de l'efficacité énergétique de ses futures architectures en double précision : +/- 12 Gflops/W pour Maxwell et +/- 24 Gflops/W pour Volta contre 6 Gflops/W pour Kepler et 2 Gflops/W pour Fermi. 200W de Volta permettra ainsi une puissance de calcul quadruplée en DP par rapport à 200W de Kepler, ce qui est en accord avec l'évolution de la bande passante mémoire. Ces chiffres ne se transposent bien entendu pas directement en performances graphiques, mais laissent néanmoins penser que l'évolution à ce niveau restera substantielle.
UEFI GOP chez Asus pour les GTX 680
Asus vient de rendre disponible sur son forum un nouveau BIOS pour ses cartes graphiques GeForce GTX 680. La mise à jour n'est disponible que sur leur forum pour l'instant, Asus souhaitant valider auprès d'utilisateurs volontaires et avancés son outil de mise à jour.
Qu'apporte cette mise à jour, donc, aux GeForce GTX 680 (tous les modèles du constructeur sont concernés par une update unique) ? Il s'agit d'un nouveau firmware hybride pour les cartes graphiques gérant en simultanée une procédure de boot classique (VGA) et une procédure GOP. L'avantage d'un boot GOP est multiple, mais on notera qu'il permet de booter dans la résolution native de l'écran et d'offrir au firmware et à l'OS, dès son chargement, un accès graphique avancé. Pour rappel, les BIOS traditionnels pré UEFI bootent en 640 par 480.
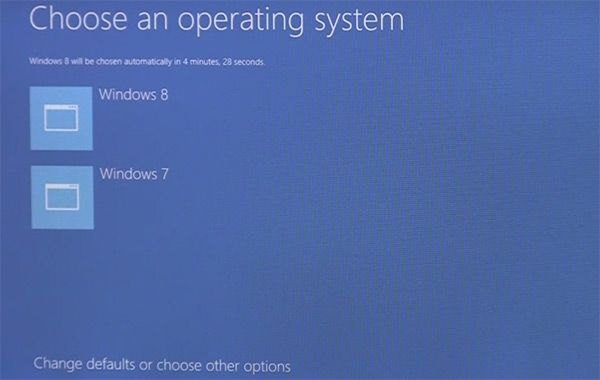
Cela permet par exemple à l'OS de proposer des écrans de dual boot graphiques qui peuvent proposer via des menus d'autres fonctionnalités avancées. On pourra également imaginer, pour l'UEFI, des bios graphiques qui s'adaptent à la résolution de l'écran (actuellement, les BIOS graphiques UEFI des différents constructeurs, par exemple ceux d'Asrock et d'Asus ici, sont tous rendus en 1024x768 via un pilote universel chargé au démarrage).
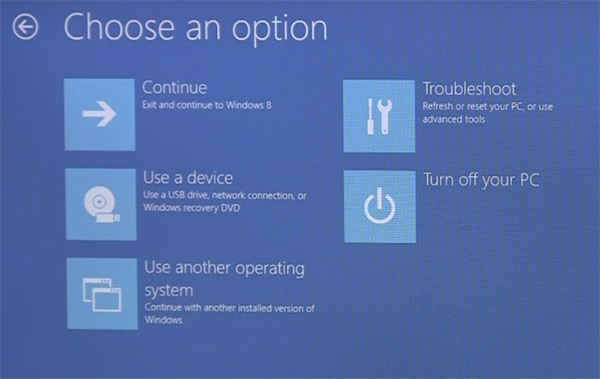
Les menus graphiques tels que ceux-ci sont ceux qui apparaissent au chargement de Windows 8. Les utilisateurs du nouvel OS peuvent ainsi profiter de ce que le marketing de Microsoft appelle "Fast Boot" et qui avait été explicité dans le blog Windows 8 .
Si le constructeur annonce que toutes ses GeForce GTX 680 sont compatibles avec l'outil, la mise à jour n'est pas forcément conseillée à tous. D'abord, cette mise à jour est définitive, il ne sera pas possible de flasher sa carte dans une version précédente. Ensuite, outre le fait qu'il faille disposer de Windows 8 pour profiter du Fast Boot, toutes les cartes mères ne sont pas forcément compatibles UEFI. Et toutes les cartes UEFI ne sont pas forcément compatibles Fast Boot (les P67/Z68 sont, selon Asus, incompatibles).
Enfin, Asus ne s'engage pas à ce que la carte fonctionne sur tous les modèles UEFI de tous les constructeurs, mais annonce avoir validé la mise à jour sur ses cartes mères (nous vous conseillons de mettre à jour le BIOS de la carte mère au préalable). Nous vous conseillons donc vivement, si vous êtes intéressés par cette mise à jour, de lire très attentivement les recommandations indiquées dans le forum du constructeur !
GTC: CUDA s'ouvre officiellement à Python
Après le C, Fortran et le C++, c'est Python qui devient le quatrième langage officiel pour CUDA. Contrairement aux trois premiers langages, ce support ne provient pas directement de Nvidia mais profite de LLVM, une infrastructure de compilateur open source qui a été adoptée pour les compilateurs CUDA il y a un peu plus d'un an. Grossièrement, LLVM expose une représentation interne qui fait office d'intermédiaire entre l'architecture CUDA et les compilateurs, ce qui facilite l'ajout du support de l'accélération via GPU à la plupart des langages.
Si plusieurs variantes plus ou moins complètes de compilateurs Python pour CUDA existent depuis quelques temps, c'est le nouveau compilateur NumbaPro développé par Continuum Analytics qui a atteint le premier un niveau suffisamment avancé pour que Nvidia puisse annoncer Python en tant que quatrième langage officiel pour CUDA
Bien que la suite Anaconda Accelerate qui intègre NumbaPro ne soit pas disponible librement, elle coûte 129$ (mais devrait passer en open source à terme), le fait que Nvidia puisse valider de la sorte un compilateur Python mis au point par un développeur externe témoigne de l'intérêt de la stratégie qui a dicté le passage à LLVM.
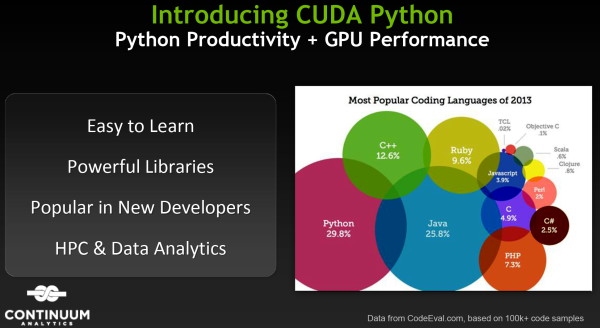
Ce support de Python, très répandu dans l'industrie et le monde scientifique, devrait permettre à Nvidia de convaincre quelques développeurs réticents de plus de passer au GPU computing ou tout du moins de jeter un coup d'œil aux possibilités qu'il pourrait offrir.
Les 5 actualités précédentes

