

Actualités cartes graphiques
 Les 5 actualités précédentes
GTC: Volta & Parker retardés, le 16nm TSMC responsable?
GTC: Tegra: Kit Jetson TK1, SoC Erista en 2015
GTC: GeForce GTX Titan Z, 3000$, bi-GK110 en avril
GTC: Nvidia annonce Pascal: NVLink, stacked DRAM, 2016
GDC: Nvidia met en avant son pilote Direct3D 11

AMD lance la Radeon R5 230, ex-HD 6450


Nos confères de TechPowerUp nous apprennent qu'AMD se prépare à lancer, probablement discrètement, une nouvelle déclinaison ultra bas de gamme dans sa gamme Radeon R200. Prénommée Radeon R5 230, elle est bâtie autour d'un ancien GPU d'AMD, Caicos (32 unités de calcul vec5), qui date de la génération HD 6000 fabriquée en 40 nanomètres. Il s'agit en fait d'un renommage de plus puisque ses spécifications sont identiques à celles de la Radeon HD 6450, introduite en avril 2011 et dont le tarif actuel est de 30-35€.
Cette carte graphique n'a selon nous aucun intérêt, si ce n'est d'alimenter un marché qui, contre toute logique, reste friand de cartes graphiques à très bas prix, moins de 50€. S'il y a de la demande, il est logique pour AMD d'y répondre… et le faire via un renommage lui permettra probablement d'augmenter quelque peu les marges.

La Radeon R5 230 de Gigabyte, équipée de 1 Go de mémoire DDR3 533 MHz
A noter que depuis quelques temps, dans le monde OEM, AMD propose d'autres dérivés du GPU Caicos dans la famille des Radeon R200. Tous ces dérivés embarquent 1 Go de mémoire DDR3 interfacés en 64-bit et avec une fréquence qui peut varier selon le bon plaisir du fabricant entre 800, 666 et 533 MHz. Ils se différencient par leur fréquence GPU :
Radeon R5 230 : 625 MHz
Radeon R5 235 OEM : 775 MHz
Radeon R5 235X OEM : 875 MHz
Enfin, tant que nous y sommes, AMD propose également une Radeon R5 220 OEM qui n'est autre qu'une Radeon HD 5450 renommée (25€). Ces 2 cartes exploitent le vieillissant GPU Cedar (16 unités de calcul vec5) dont l'intérêt à l'heure actuelle atteint le zéro absolu.
AMD 'FreeSync': proposition adoptée par VESA
Il y a un peu plus de 2 mois, nous vous dévoilions que l'initiative 'FreeSync' d'AMD, réponse standardisée au G-Sync de Nvidia, était en bonne voie de se transformer en option pour le standard DisplayPort 1.2a actuel.
Pour rappel, alors que le silence semble être la règle du côté de VESA, un lecteur bien informé nous avait alors indiqué qu'une demande de type SCR (Specification Change Request) avait été déposée de manière à intégrer le support optionnel de la fréquence de rafraîchissement variable au standard DisplayPort 1.2a. Cette proposition, représentée par un document daté du 25 novembre et intitulé DP1.2a Extend MSA Tmg Para AMD SCR, avait de toute évidence été soumise par AMD. Fin janvier, elle était au stade GMR (General Member Review) et donc en bonne voie d'être finalisée et ratifiée.
Selon notre source, que nous remercions à nouveau, différentes discussions concernant cette proposition ont eu lieu dans le courant du mois de février entre les différents membres concernés de VESA et, bonne nouvelle, elle a bien été adoptée comme prévu. Depuis le 1er avril, et ce n'est pas un poisson, la liste des demandes SCR adoptées en mentionne une nouvelle : DP1.2a Extend MSA Tmg Param Ignore Option AMD.
VESA et/ou AMD ne devraient donc plus tarder à annoncer officiellement l'arrivée de la fréquence de rafraîchissement variable pour le standard DisplayPort 1.2a.
Reste bien entendu de nombreuses questions quant à son support en pratique puisqu'il sera optionnel. AMD a indiqué à plusieurs reprises que des écrans déjà sur le marché pourraient potentiellement supporter ce mode d'affichage, mais nous ne savons toujours pas si ce sera réellement le cas. Quand de nouveaux écrans pourront-ils être proposés ? Nvidia et Intel feront-ils en sorte de supporter rapidement et activement ce mode d'affichage standardisé ? Compte tenu de l'intérêt de la chose, nous ne pouvons qu'espérer que ces questions trouvent rapidement des réponses !
La Radeon R9 295 X2 se montre
En parallèle de la Titan Z de Nvidia qui exploitera deux GPU GK110 totalement fonctionnels (voir cette actualité), AMD devrait également proposer sous peu une carte graphique exploitant deux GPU Hawaii, une carte annoncée via un tweet pas vraiment cryptique du constructeur.

Attendue sous le nom de Radeon R9 295 X2, la carte semble s'être montrée sur le forum chiphell .
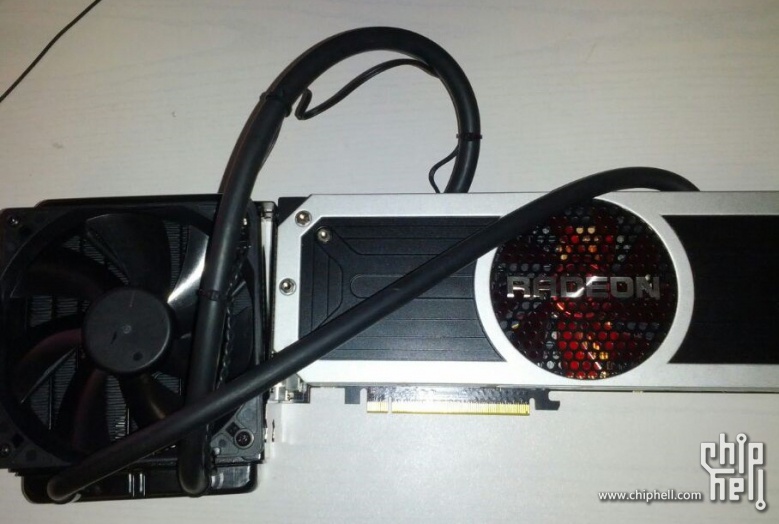
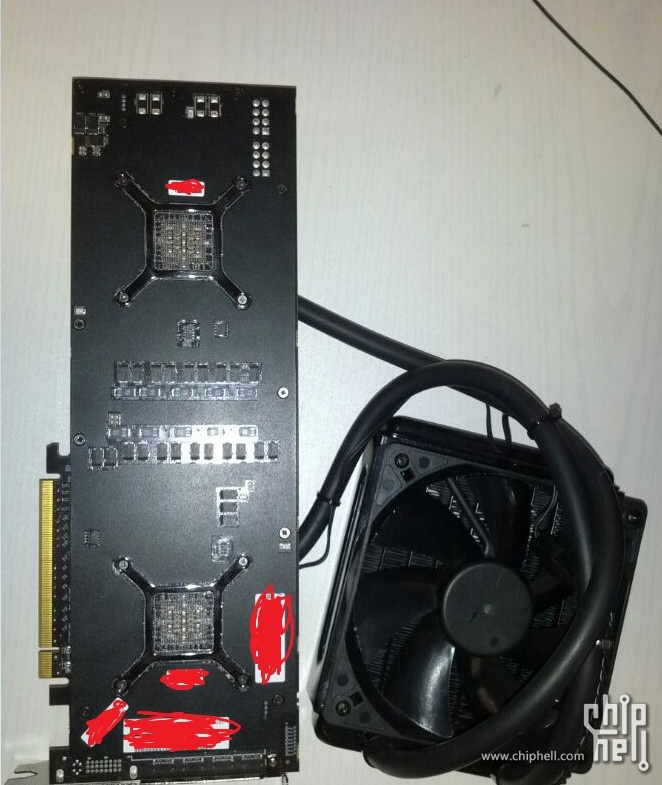
Pas vraiment de détails sur les caractéristiques au-delà de spéculations, mais l'on notera sur les deux photos ci-dessus que le constructeur aurait opté pour un système de refroidissement hybride liquide/air. On notera également la présence de deux connecteurs 8 broches sur la photo, permettant théoriquement de fournir chacun 150 watts (le port PCI Express permet également de récupérer 75 watts d'alimentation supplémentaires, pour un total supposé de 375 watts). Selon les rumeurs, le lancement pourrait s'effectuer durant la première moitié du mois d'avril.
GTC: Quelques détails de plus sur le GPU Pascal
Durant la GTC, nous avons pu poser quelques questions à Nvidia et en apprendre un peu plus sur le GPU Pascal qui a été introduit entre les générations Maxwell et Volta.
Si Nvidia se refuse à parler de process de fabrication, nous supposons que la raison du retard de Volta est à chercher de ce côté. Pascal devra donc se contenter du 20 nanomètres de TSMC, ce qui limitera quelque peu les possibilités de Nvidia par rapport à ses plans originaux pour la même période. Pour aller plus loin que les GPU Maxwell qui seront fabriqués en 20nm, Nvidia devra poursuivre la progression de l'efficacité énergétique, mais ce n'est pas tout.
Nvidia explique que certains développements entrepris pour Volta étaient prêts et pourront être proposés comme prévus à travers les GPU Pascal. C'est le cas des technologies NVLink et du DRAM stacking. NVLink, qui a été développé en partenariat avec IBM, devrait dans un premier temps rester spécifique au marché professionnel, mais le DRAM stacking fera son apparition du côté des dérivés grand public. Probablement uniquement dans le très haut de gamme au départ, mais Nvidia insiste sur le fait que la technique est utile pour tous les segments de marché. En dehors du coût et d'un travail important nécessaire pour assurer un assemblage fiable, ce recours au DRAM stacking ne présente que des avantages, aucun inconvénient selon Nvidia. Son implémentation généralisée n'est donc qu'une question de temps et de réduction progressive des coûts.
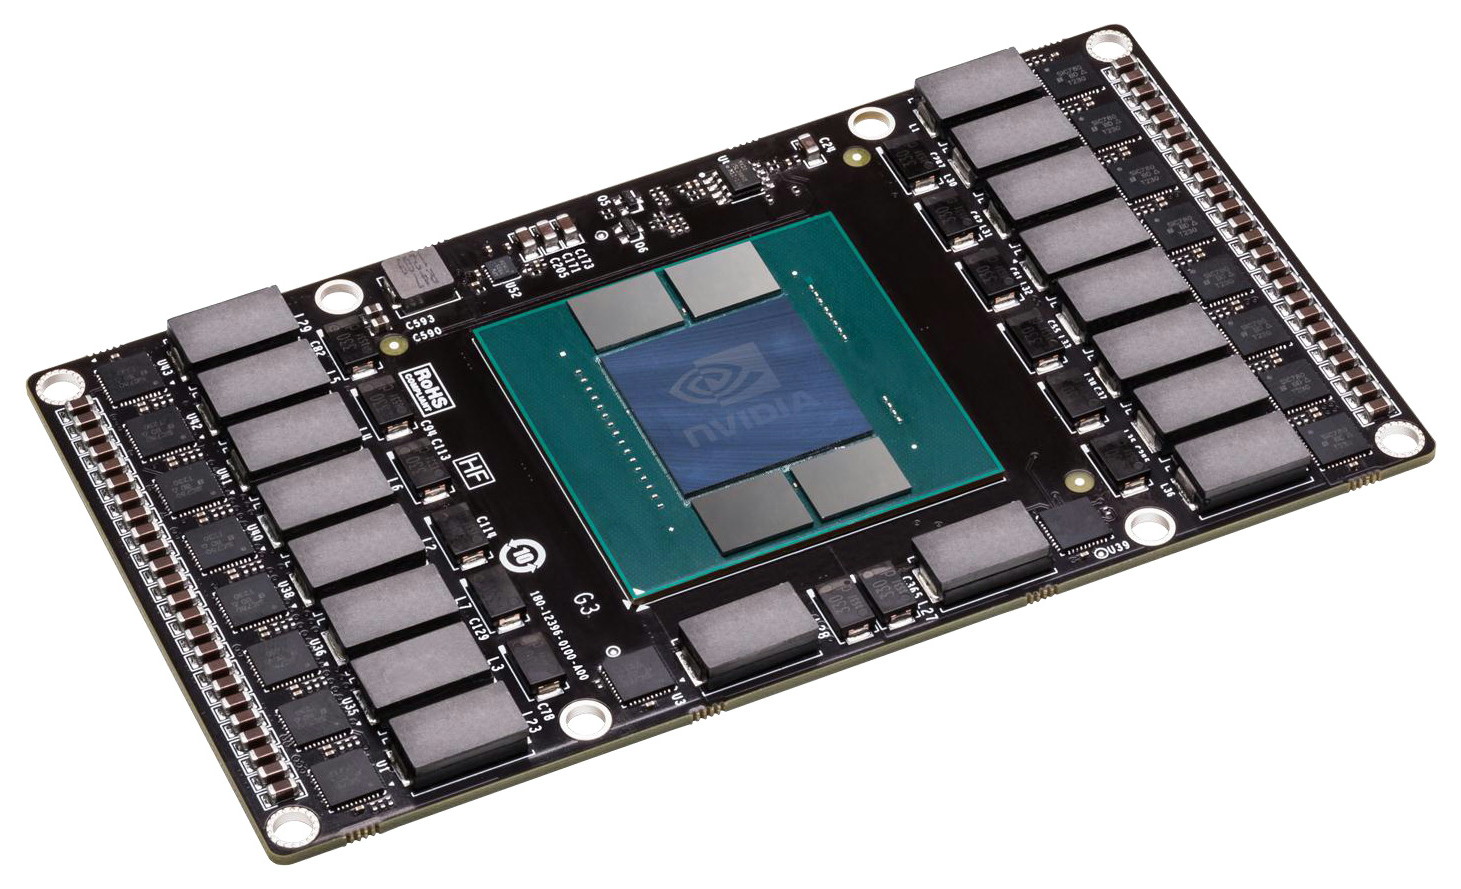
Concernant le prototype de Pascal qui a été présenté, il s'agit d'un "mechanical sample" qui n'est pas encore fonctionnel mais qui est utilisé par Nvidia pour développer un nouveau format de module "carte graphique". Sur ce module Pascal, nous pouvons observer le GPU avec ses 4 assemblages de puces mémoire qui prennent place sur le même packaging et sont connectés via un "interposer". Sur les côtés du module sont visibles les VRM nécessaires pour alimenter un GPU haut de gamme tel que devrait l'être Pascal. Nvidia précise que ce module n'aura pas de problème à délivrer au moins 300W.
Si aucun connecteur n'est visible au premier abord c'est parce qu'ils se situent en fait au dos, Nvidia ayant opté pour un format de type mezzanine qui consiste à superposer 2 PCB, avec un ou plusieurs connecteurs entre ceux-ci. Sur le module actuel, Nvidia précise que 2 connecteurs sont exploités.
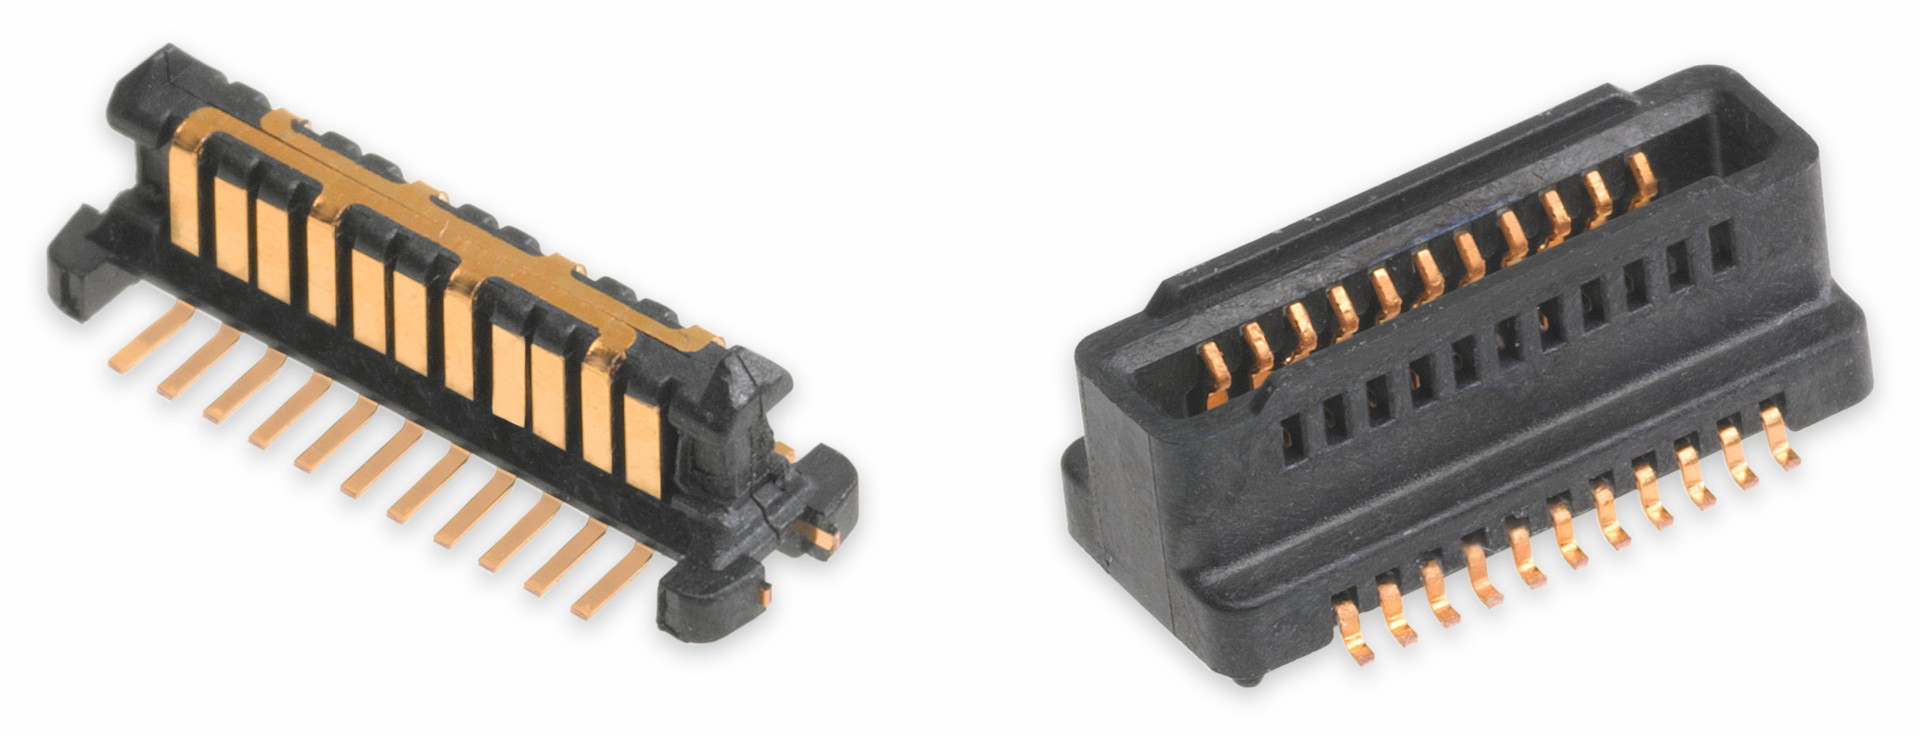
Un exemple de connecteur mezzanine, SpeedStack de Molex, capable de supporter des débits de 40 Gbps par paire.
Pourquoi ce changement de format ? Pour faciliter l'implémentation de NVLink, qui pourrait être exclusive au format mezzanine, mais également parce que ce dernier est plus fiable, notamment lorsqu'il est question de laisser les assembleurs de serveurs monter leur propre radiateur. Nvidia n'abandonne cependant pas le format "carte PCI Express" pour Pascal, il restera également disponible, même sur le marché professionnel.
Nvidia a également publié des schémas un peu plus détaillés de systèmes NVLink :
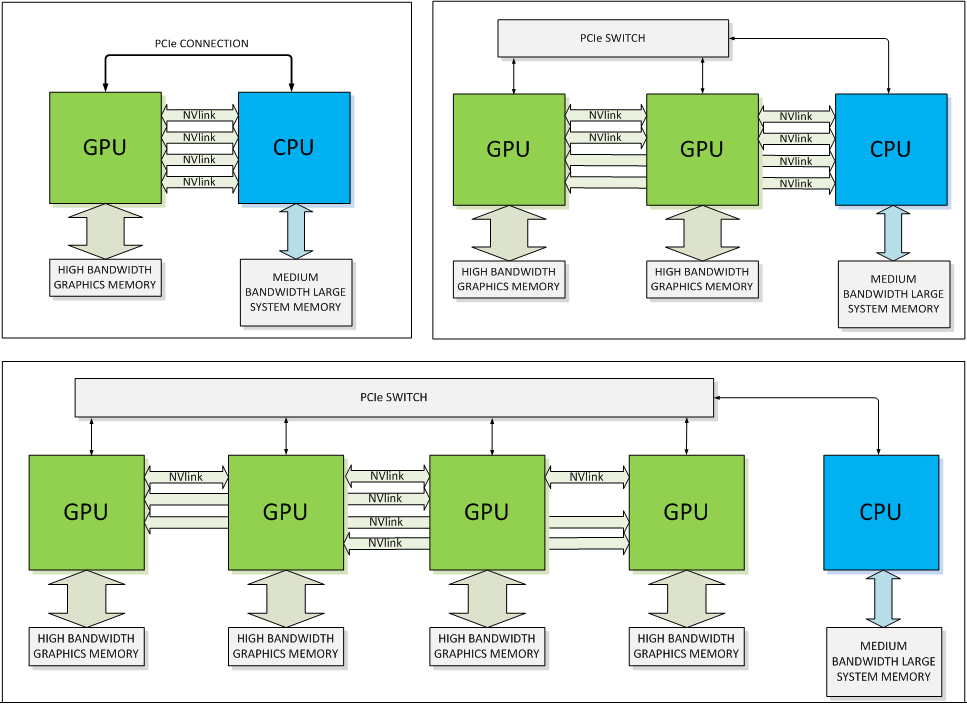
Sur ces schémas nous pouvons clairement observer 4 liens NVLink. Nvidia nous a précisé qu'il s'agissait d'un minimum et que certains modules Pascal, ou ses successeurs, pourraient en offrir plus, 8, 16… Il n'est d'ailleurs pas impossible que Nvidia en profite à l'avenir pour segmenter sa gamme professionnelle comme le fait aujourd'hui Intel avec les Xeon 2P/4P/8P. A noter que tous les liens peuvent être combinés pour former un très large bus de communication vers le CPU et/ou exploités pour connecter plusieurs GPU entre eux.
Chaque lien NVLink correspond à un bloc de 8 paires de lignes bidirectionnelles de type point-à-point. Une approche similaire à celle de l'HyperTransport et du QPI. Là où le bus PCI Express 3.0 16x apporte 16 Go/s dans chaque direction, l'ensemble NVLink pourra atteindre entre 80 et 200 Go/s. Nvidia indique par ailleurs que les déplacements de données à travers NVLink seront plus efficaces sur le plan énergétique que le PCI Express. Les premiers composants autres que Pascal qui supporteront NVLink seront de futurs CPU Power d'IBM. Nvidia précise par contre être en discussion avec d'autres fabricants de CPU, autres qu'Intel, mais sans en dire plus.
Enfin, nous avons interrogé Nvidia par rapport au recul du support complet de la mémoire unifiée qui était initialement prévu pour Maxwell mais est dorénavant annoncé pour Pascal. Ses responsables nous ont répondu que ce support avait bien été repoussé mais qu'il était présent partiellement depuis Kepler, reposant en partie sur une implémentation logicielle. Ils nous promettent que cette fois ce sera la bonne et que le dernier bloc nécessaire à la prise en charge matérielle complète de la mémoire unifiée fera enfin son apparition avec Pascal et NVLink.
GDC: Mantle, Direct3D 12, l'œuf et la poule
S'il y a bien un mot qui était tabou lors de toutes les sessions de la GDC consacrées à Direct3D 12, c'était Mantle. Microsoft, Nvidia et même AMD ont tout fait pour éviter de devoir mentionner cette autre API de bas niveau. Direct3D 12 est-il le résultat de la sortie de Mantle ? Voici ce qui nous semble être la meilleure actuelle théorie sur le sujet…
Durant la GDC, seul Oxide a osé un timide acte de rébellion en déclarant que "porter leur moteur depuis d'autres API modernes était plus simple que de porter de Direct3D 11 vers Direct3D 12". A chacune de ces sessions pourtant, la première question qui était posée était systématiquement la suivante : "comment se compare Direct3D 12 à Mantle ?". Eclats de rire assurés dans la salle mais aucune réponse en retour.

Nvidia, de son côté, explique travailler avec Microsoft sur DirectX 12 depuis plus de 4 ans et en collaboration rapprochée depuis un an. C'est sans aucun doute autant la réalité qu'un baratin énorme pour éviter d'admettre avoir été poussé dans cette direction par l'API Mantle d'AMD.
Microsoft travaille constamment avec ses partenaires au sujet de possibles évolutions de ses API. La machine ne s'arrête pas quand DirectX 11 sort, les discussions et autres phases de recherche continuent. Quand Nvidia indique travailler depuis plus de 4 ans avec Microsoft sur DirectX 12, cela veut simplement dire que Nvidia a poursuivi sa collaboration avec Microsoft au-delà de DirectX 11, comme tous les autres fabricants de GPU. Cela ne veut pas dire que Nvidia travaille depuis 4 ans sur le Direct3D 12 qui est présenté aujourd'hui.
Nous ne pensons pas que le fait que la démonstration de Microsoft d'un prototype de portage vers Direct3D 12 de Forza Motorsport ait été réalisée sur un GPU Nvidia, la GeForce GTX Titan Black, soit un élément significatif. Il est logique que Microsoft opte pour un GPU Nvidia pour mettre en avant l'aspect universel de sa solution. Une démonstration sur un GPU AMD aurait entraîné plus de liens vers Mantle et l'architecture d'AMD puisque le code de base de Forza Motorsport provient de la Xbox One équipée en GPU AMD.
Après de très nombreuses discussions avec tous les acteurs impliqués, à la GDC mais également auparavant, nous sommes convaincus que Mantle a été le déclencheur et l'accélérateur de la direction retenue pour Direct3D 12, quoi qu'en dise Nvidia. Cela ne veut pas dire que Direct3D 12 est un clone de Mantle, mais qu'il semble bel et bien avoir été bâti sur les mêmes bases ou tout du moins fortement tiré dans la même direction. Des bases qui impliquent de transférer une partie significative de la responsabilité des performances et des optimisations du pilote vers le moteur du jeu. Bien sûr, ce n'est pas un monde en noir et blanc, tout le pouvoir ne passe du pilote au moteur de jeu, les deux restent importants mais l'équilibre est modifié en faveur du second.
C'est selon nous la clé pour comprendre la position de chacun et la chronologie des évènements. Il ne faut pas être naïfs, AMD et Nvidia n'opèrent pas de virage important par pure conviction technologique, tous ces choix se font également avec une bonne dose de politique et de stratégie.
Pourquoi AMD a-t-il sorti Mantle ? Parce que Nvidia dispose de la meilleure équipe de développement des pilotes. Pourquoi Nvidia aurait-il été réticent jusqu'alors à faire évoluer Direct3D vers un niveau d'abstraction plus bas ? Parce que Nvidia dispose de la meilleure équipe de développement des pilotes.
Plus une API graphique est complexe, prend des chemins torturés et accuse un surcoût ou overhead élevé, plus les fabricants de GPU ont d'opportunités de se démarquer de la concurrence via leurs pilotes. Cela ne veut pas spécialement dire qu'AMD et Nvidia font ou ont fait volontairement en sorte de complexifier les API, mais que les simplifier et transférer une plus grosse part de la responsabilité de l'optimisation vers les développeurs pose des questions stratégiques importantes qui peuvent les inciter à trainer des pieds face à certaines évolutions.
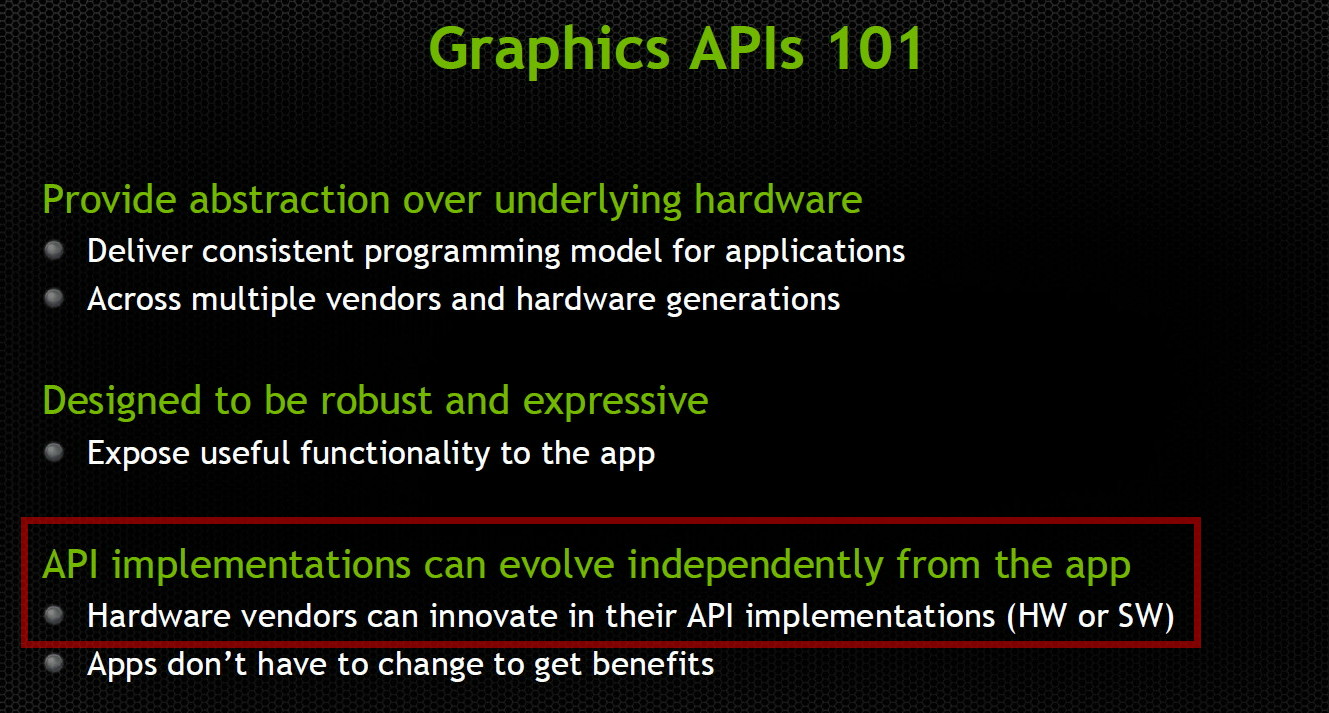
Les avantages d'une API de plus haut niveau, selon Nvidia.
Le travail important nécessaire pour obtenir des performances de premier plan, que ce soit globalement au niveau des pilotes ou spécifiquement au cas par cas pour chaque application, a permis à AMD et Nvidia de bénéficier de la sécurité d'un marché difficilement accessible à d'autres acteurs. Des sociétés telles que S3, Matrox, XGI etc. s'y sont cassé les dents, en partie pour cette raison. C'est également ce qui a permis à AMD et Nvidia de tenir Intel à l'écart.
Au cours de ses années les plus difficiles, AMD a dû se séparer de nombreux ingénieurs qui travaillaient sur ses pilotes alors même que Nvidia renforçait ses rangs. Même si AMD a récemment revu à la hausse ses investissements auprès du support des développeurs, il est évident que Nvidia dispose d'une force de frappe nettement plus importante sur le plan du développement des pilotes. AMD a probablement fini par prendre conscience du danger que cela pouvait représenter et revu sa stratégie en conséquence. Le réflexe qui pouvait être de trainer des pieds par rapport à un transfert de pouvoir des pilotes vers l'application n'avait plus lieu d'être. Au contraire, il a fini par devenir évident que pousser le marché dans cette direction serait utile pour la compétitivité de la société.
Pas facile cependant de convaincre tout le monde de bouger dans ce sens... Il nous semble évident que stratégiquement Nvidia n'avait au premier abord aucune raison d'abonder dans le sens d'AMD, et préférait opter pour d'autres approches de réduction du surcoût CPU, peut-être moins ambitieuses, qui lui auraient évité d'abandonner autant de contrôle sur les optimisations. Du côté de Microsoft il y avait probablement du pour et du contre, pas mal d'hésitation et d'avis contradictoires.
En développant et en concrétisant Mantle, avec le support de développeurs très enthousiastes, nous pouvons supposer qu'AMD a décidé de donner un coup de pied dans cette fourmilière. Le risque était limité. Dans le pire des cas, AMD pourrait bénéficier d'un mode spécifique dans quelques jeux, et dans le meilleur des cas, en profiter pour forcer la main des acteurs réticents de manière à pousser l'industrie dans une direction plus intéressante pour la société d'un point de vue compétitif.
De premiers résultats encourageants, l'engouement instantané de plusieurs développeurs pour les principes de Mantle (pas spécialement pour l'utilisation d'une API propriétaire !), la position délicate de la Xbox One, la menace de Steam OS, …, tout cela a mis en place une atmosphère qui a permis à tout le monde d'accepter d'aller vers un changement plus radical que certains ne le voulaient au départ pour Direct3D 12. Au final, avec Mantle, AMD a pu influencer significativement Direct3D 12, en plus d'apporter un bonus dans quelques jeux pour les utilisateurs de Radeon, ce qui est toujours bienvenu sur le plan commercial.
Sur la base de la même réflexion, nous pouvons supposer qu'OpenGL ES va évoluer rapidement vers une version à overhead réduit, alors qu'il sera beaucoup plus lent et difficile de faire évoluer OpenGL dont l'importance dans le monde professionnel en fait un élément stratégique crucial. Un responsable du développement d'un des moteurs de jeux majeurs nous a d'ailleurs confirmé qu'un tel OpenGL ES était déjà sur la table.
Nous pouvons par contre supposer que Nvidia sera extrêmement prudent par rapport à une évolution d'OpenGL qui pourrait impacter son très rentable marché professionnel. Même si la tendance va de plus en plus vers une exploitation de toute la puissance des GPU, de nombreuses applications professionnelles liées à la 3D restent fortement limitées par le CPU et les performances du pilote. Une caractéristique qui, comme vous pourrez l'imaginer, fait bien les affaires de Nvidia.
Les 5 actualités précédentes

