

Actualités cartes graphiques
 Les 5 actualités précédentes
Samsung en sus de GloFo pour le 14nm AMD ?
AMD repousse Fiji Gemini, la bi-Radeon Fury
Pilotes AMD Crimson 15.12 WHQL
GPUOpen, la réponse d'AMD à GameWorks
Les R9 390 enfin en version 4 Go

Rise of the Tomb Raider offert par Nvidia


Nvidia lance une nouvelle offre jeu avec le titre Rise of the Tomb Raider qui est offert avec les GTX 970, 980 et 980 Ti ainsi que les GTX 970M et 980M. Cet accord commercial semble aller de pair avec une association côté technique puisque le jeu intégrera une technologie dénommée VXAO développée en partenariat avec Nvidia, a priori une nouvelle méthode pour calculer l'occlusion ambiante (cf. page 49 ).

Pour rappel le précédent opus avait en 2013 fait l'objet d'un bundle chez AMD et intégrait la technologie TressFX du constructeur. Comme d'habitude cette offre n'est valable que chez les revendeurs partenaires affichant l'offre. Ils vous fourniront généralement après le délai de rétractation un premier code qui permettra d'obtenir auprès de Nvidia un second code pour télécharger le jeu sur Steam. Le jeu doit sortir le 28 janvier.
CES: Une GTX 980 Ti VR Edition chez EVGA
EVGA a décidé de surfer sur la vague VR et ce, en faisant plus que se contenter d'ajouter un logo sur ses fiches produits. Une GeForce GTX 980 Ti de plus sera ainsi ajoutée à son catalogue dans le courant de ce trimestre : la GTX 980 Ti VR Edition.


Equipée d'un ventirad de type ACX 2.0+ classique, et sans overclocking particulier, cette carte aura la particularité de proposer une sortie HDMI interne et d'être accompagnée d'un rack 5.25" / 3.5" qui permet de déporter cette sortie HDMI ainsi que 2 connecteurs USB 3.0 à l'avant du boîtier. De quoi proposer un accès simplifié à la connectique nécessaire aux casques de réalité virtuelle et gagner jusqu'à un mètre de longueur de câble utile suivant la taille du boîtier.
Aucun tarif n'est communiqué mais EVGA précise envisager de décliner par la suite cette solution sur d'autres modèles, par exemple une GTX 980 ou une GTX 970.
CES: Drive PX 2: Tegra et Pascal au pilotage
Comme l'an passé, Nvidia a consacré sa traditionnelle conférence du CES au marché automobile pour lequel la société nourrit d'importantes ambitions, notamment en ce qui concerne la conduite autonome. Traditionnellement tournée autour du SoC Tegra, cette conférence du CES a progressivement évolué des smartphones et tablettes vers l'automobile au fur et à mesure que Nvidia repositionnait ses SoC.
Probablement arrivé sur ce marché un petit peu par hasard, Nvidia en a rapidement déduit le potentiel énorme, d'autant plus face à l'échec des SoC Tegra dans le monde des smartphones. Au départ, Nvidia s'est attaqué aux systèmes multimédia et d'affichage embarqués qui peuvent profiter de son expertise au niveau graphique et vidéo. Avec à la clé quelques succès pour les SoC Tegra, mais insuffisants pour justifier tous les efforts nécessaires à la conception de telles puces. Toujours à la recherche de marchés à plus forte valeur ajoutée, se battre sur les prix avec d'autres acteurs tels que TI et depuis peu Qualcomm ne fait pas partie de sa stratégie, Nvidia se concentre dorénavant en priorité à la conduite autonome.
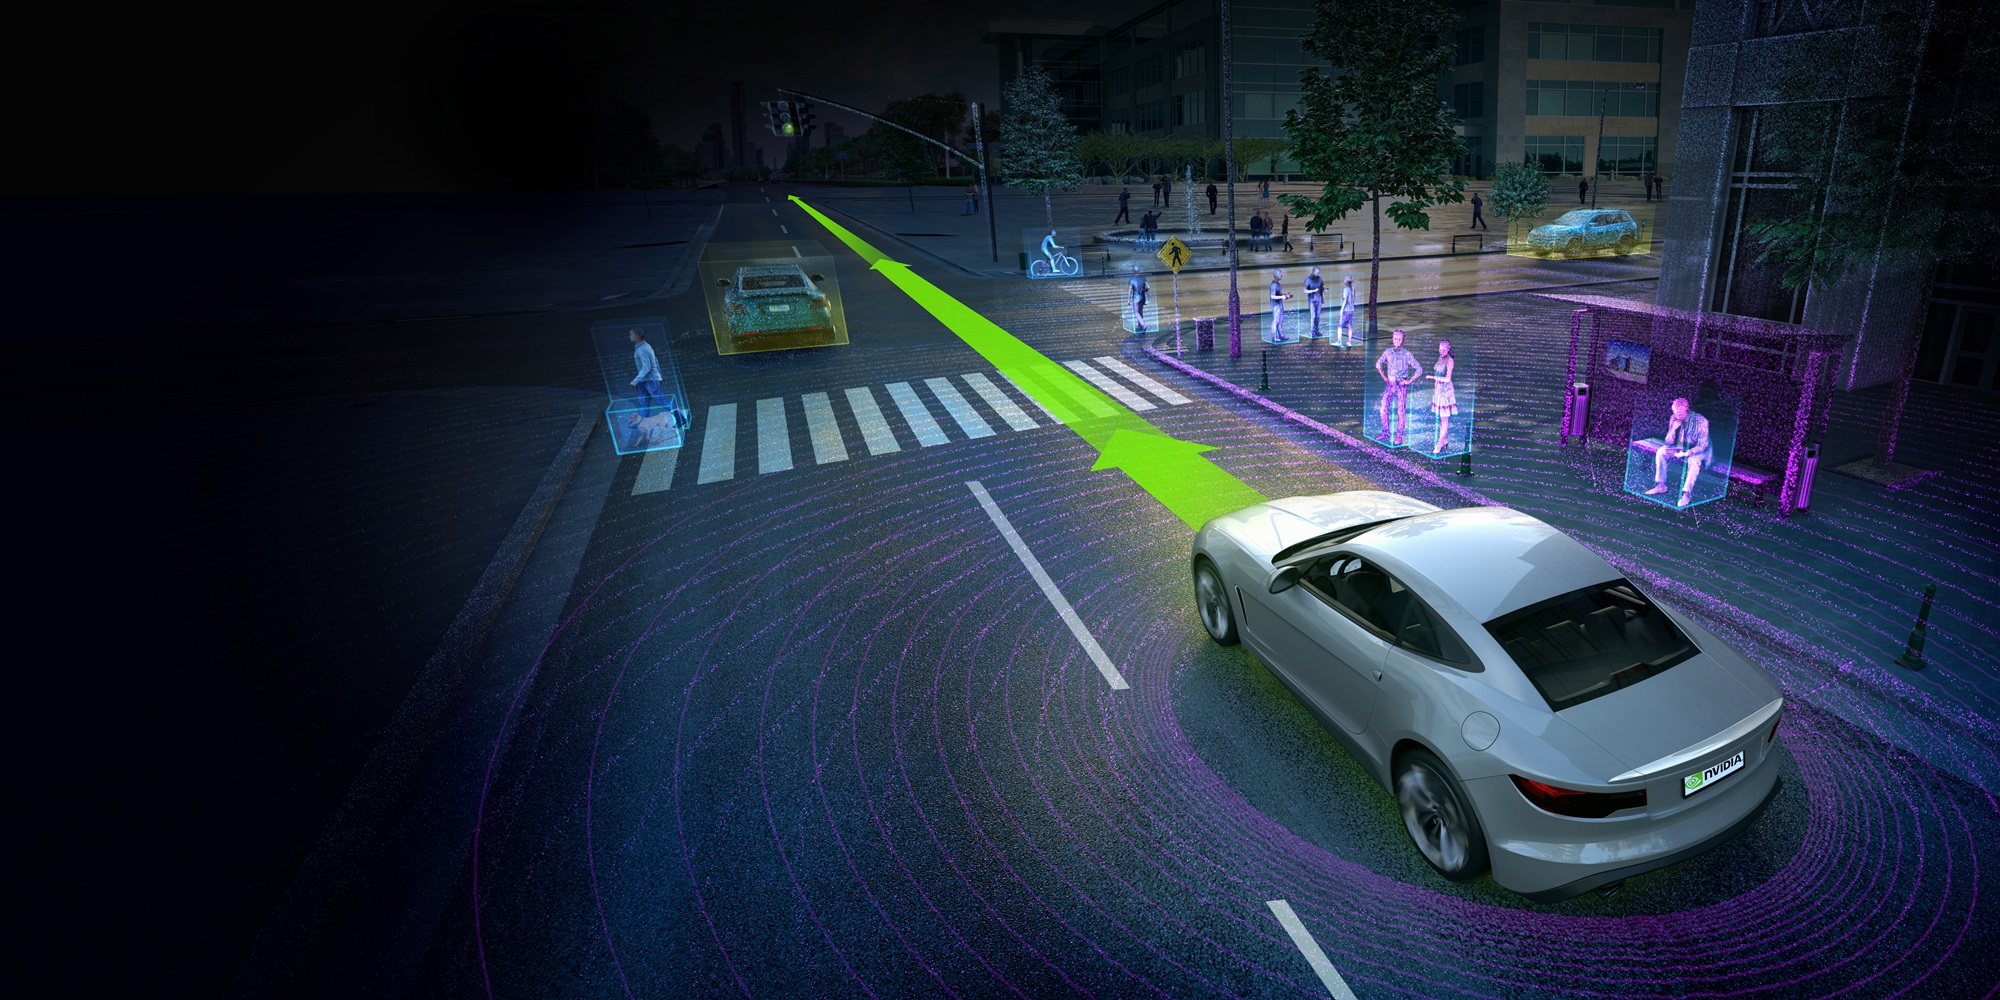
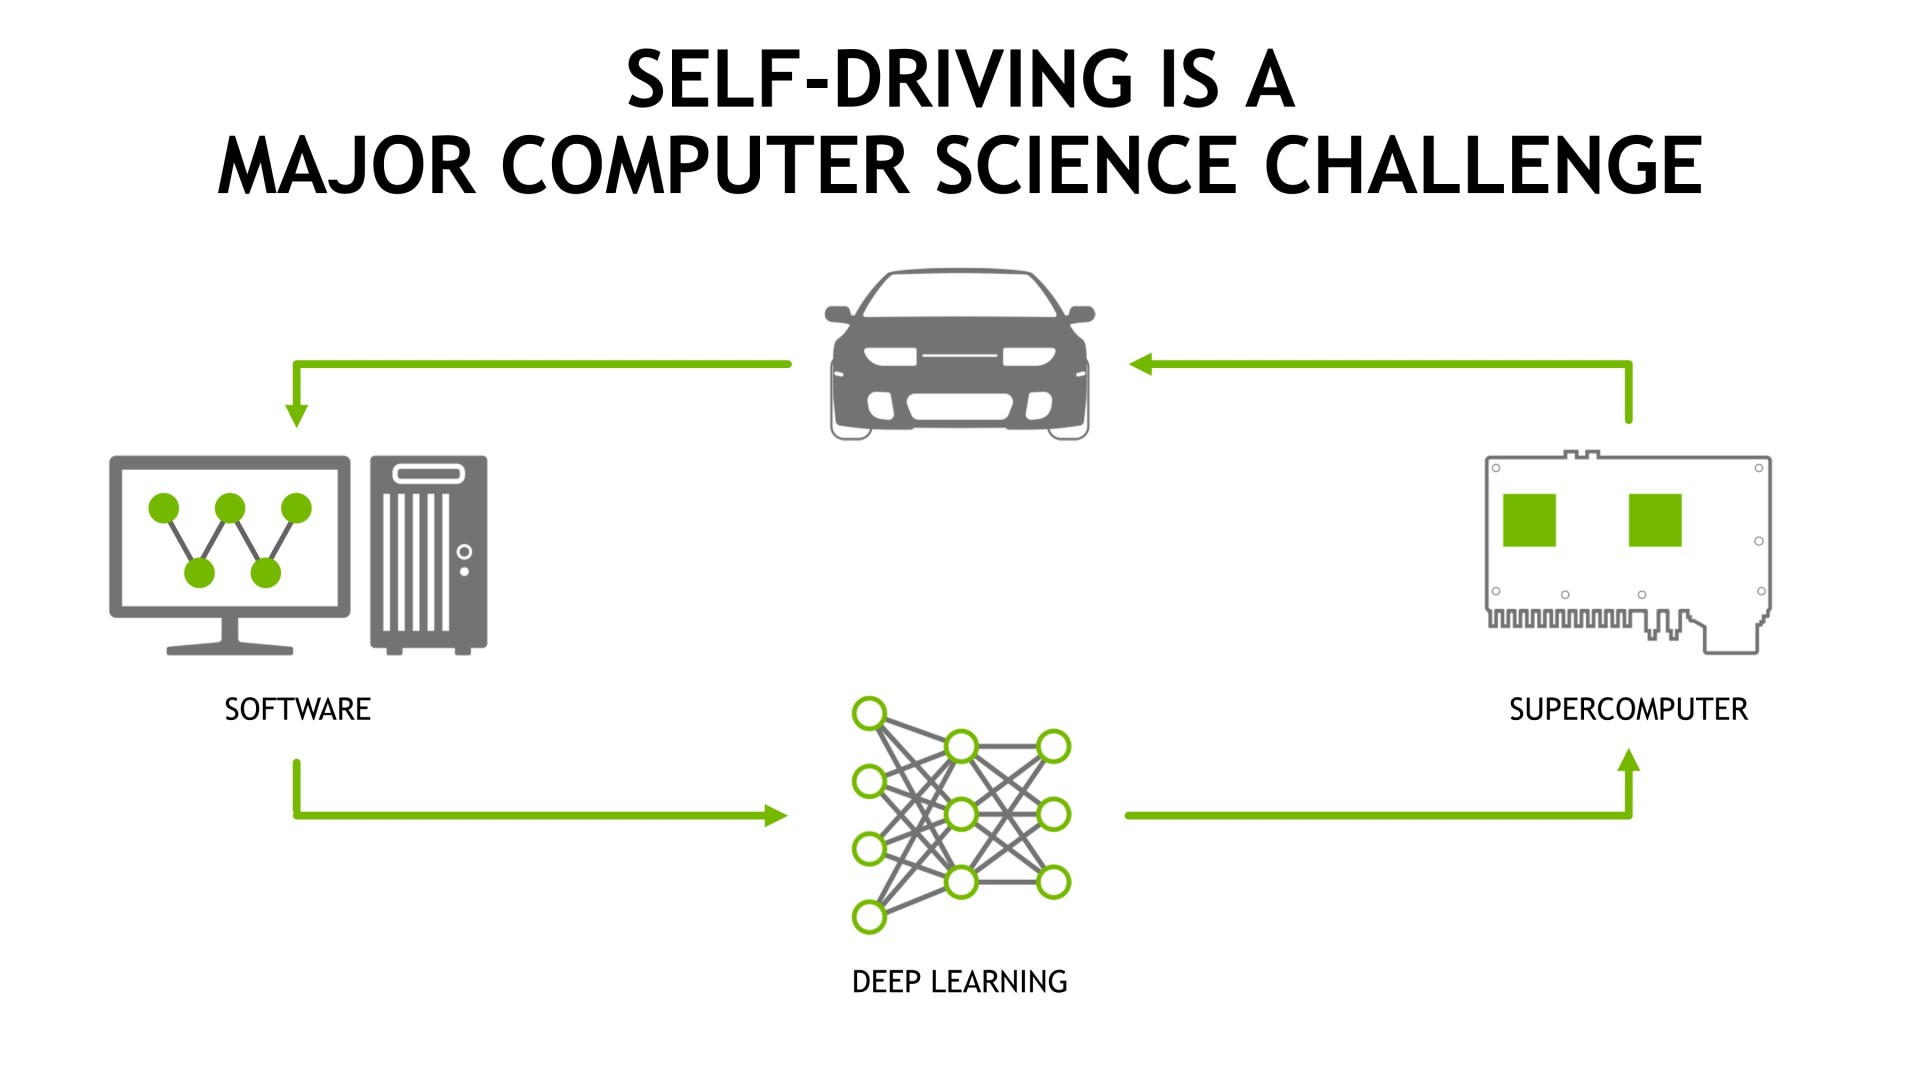
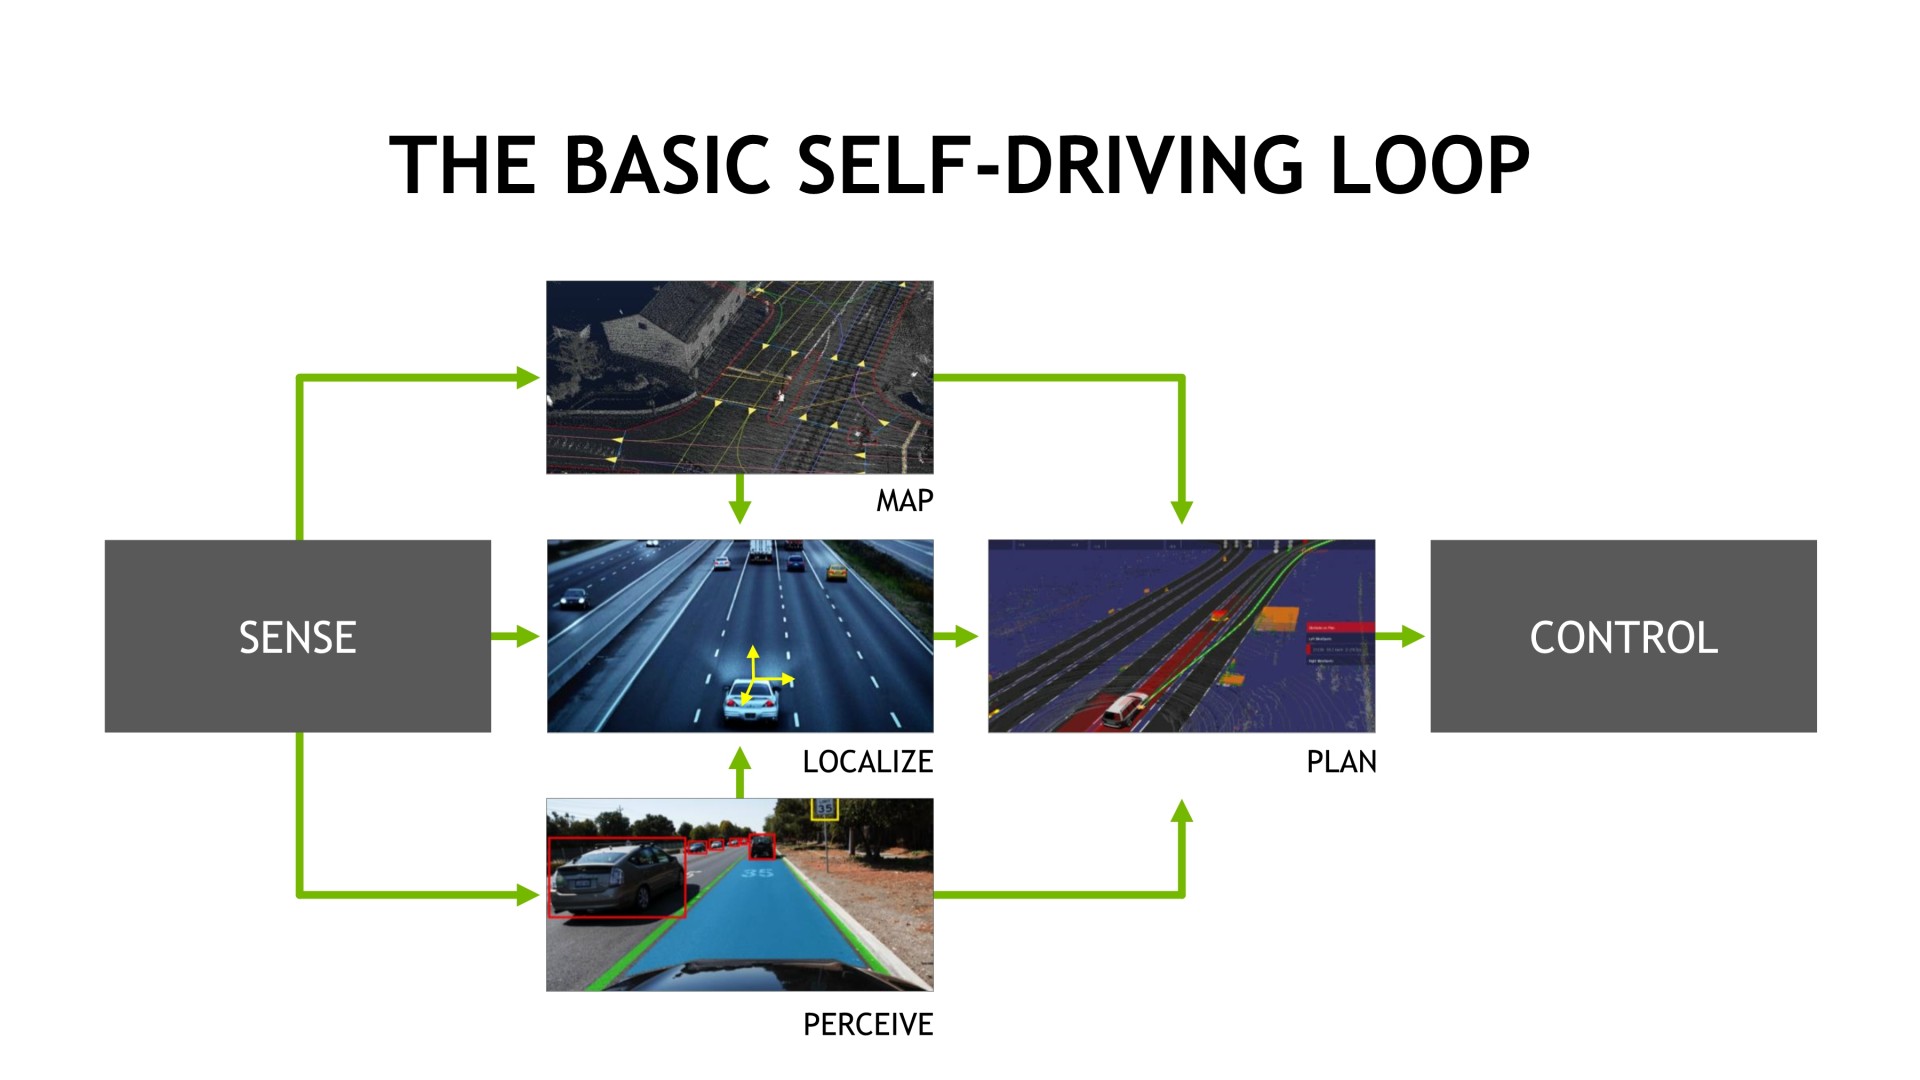
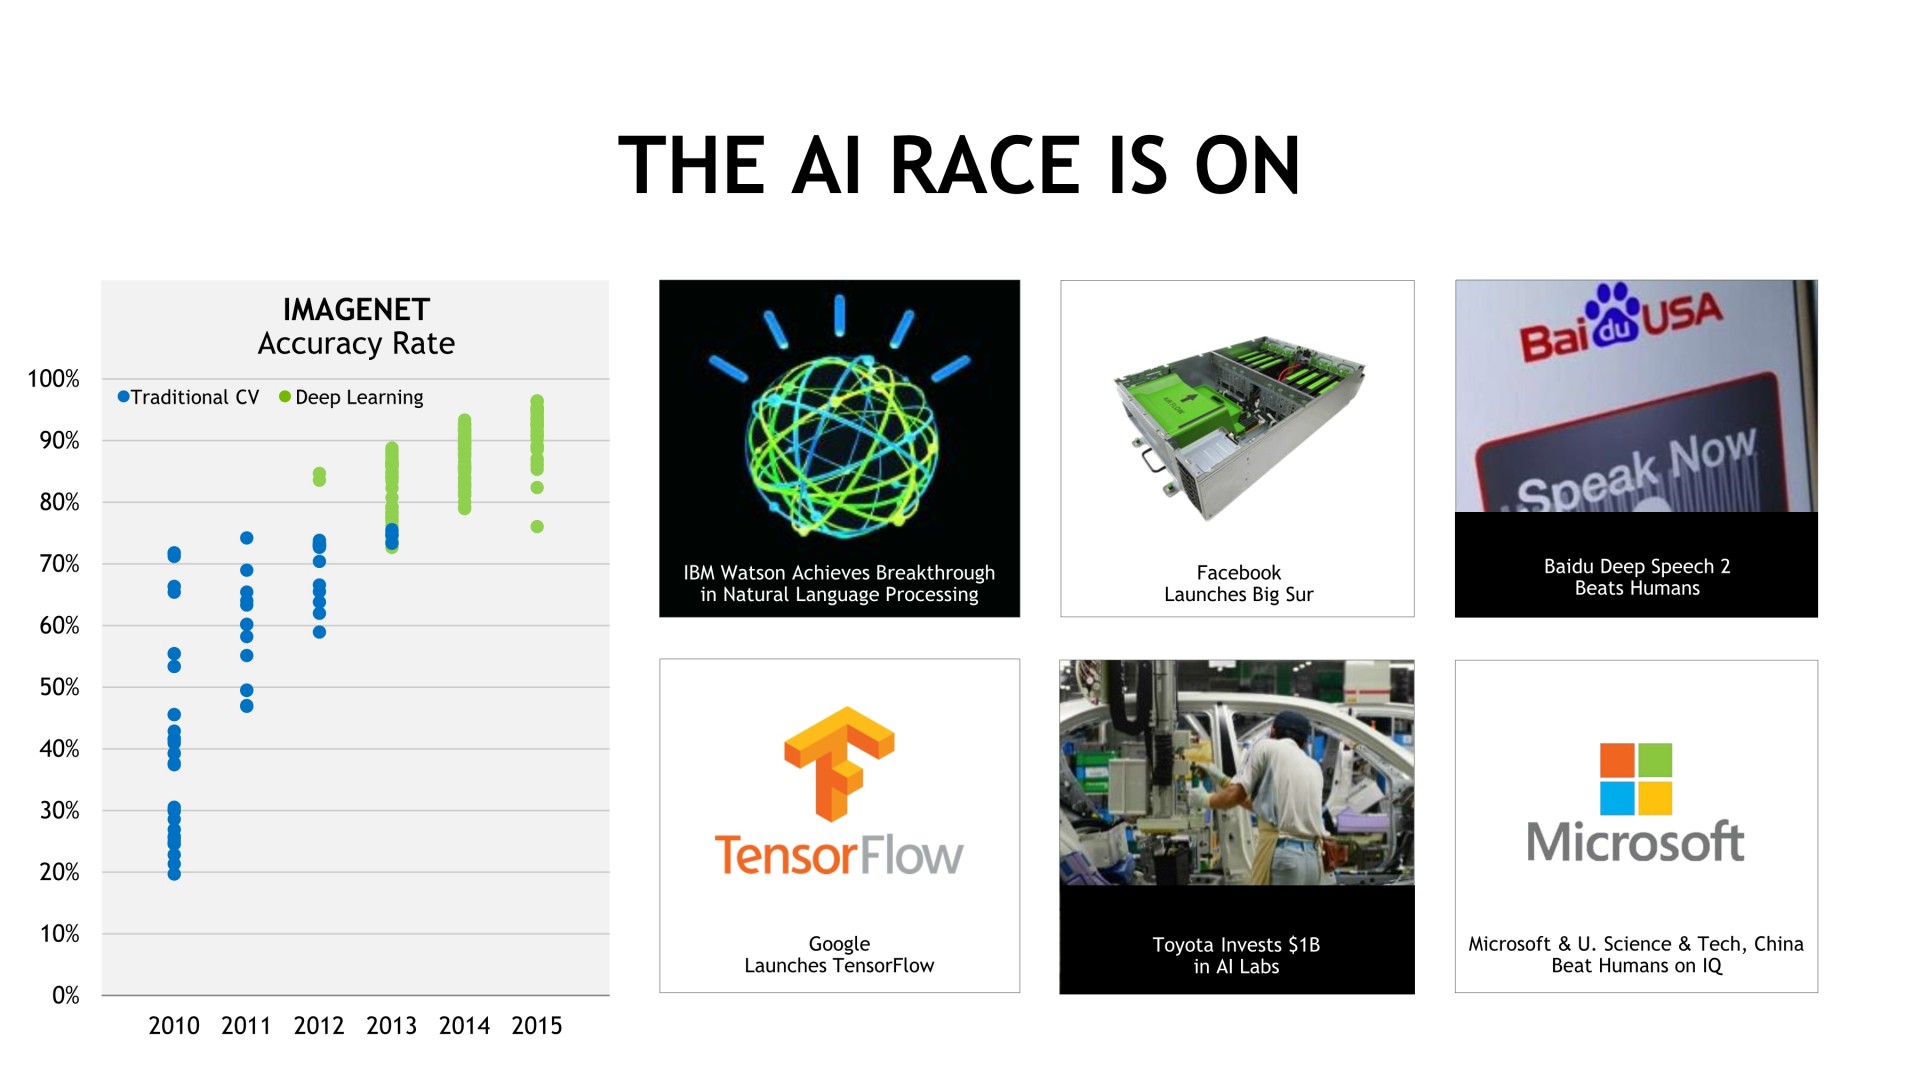
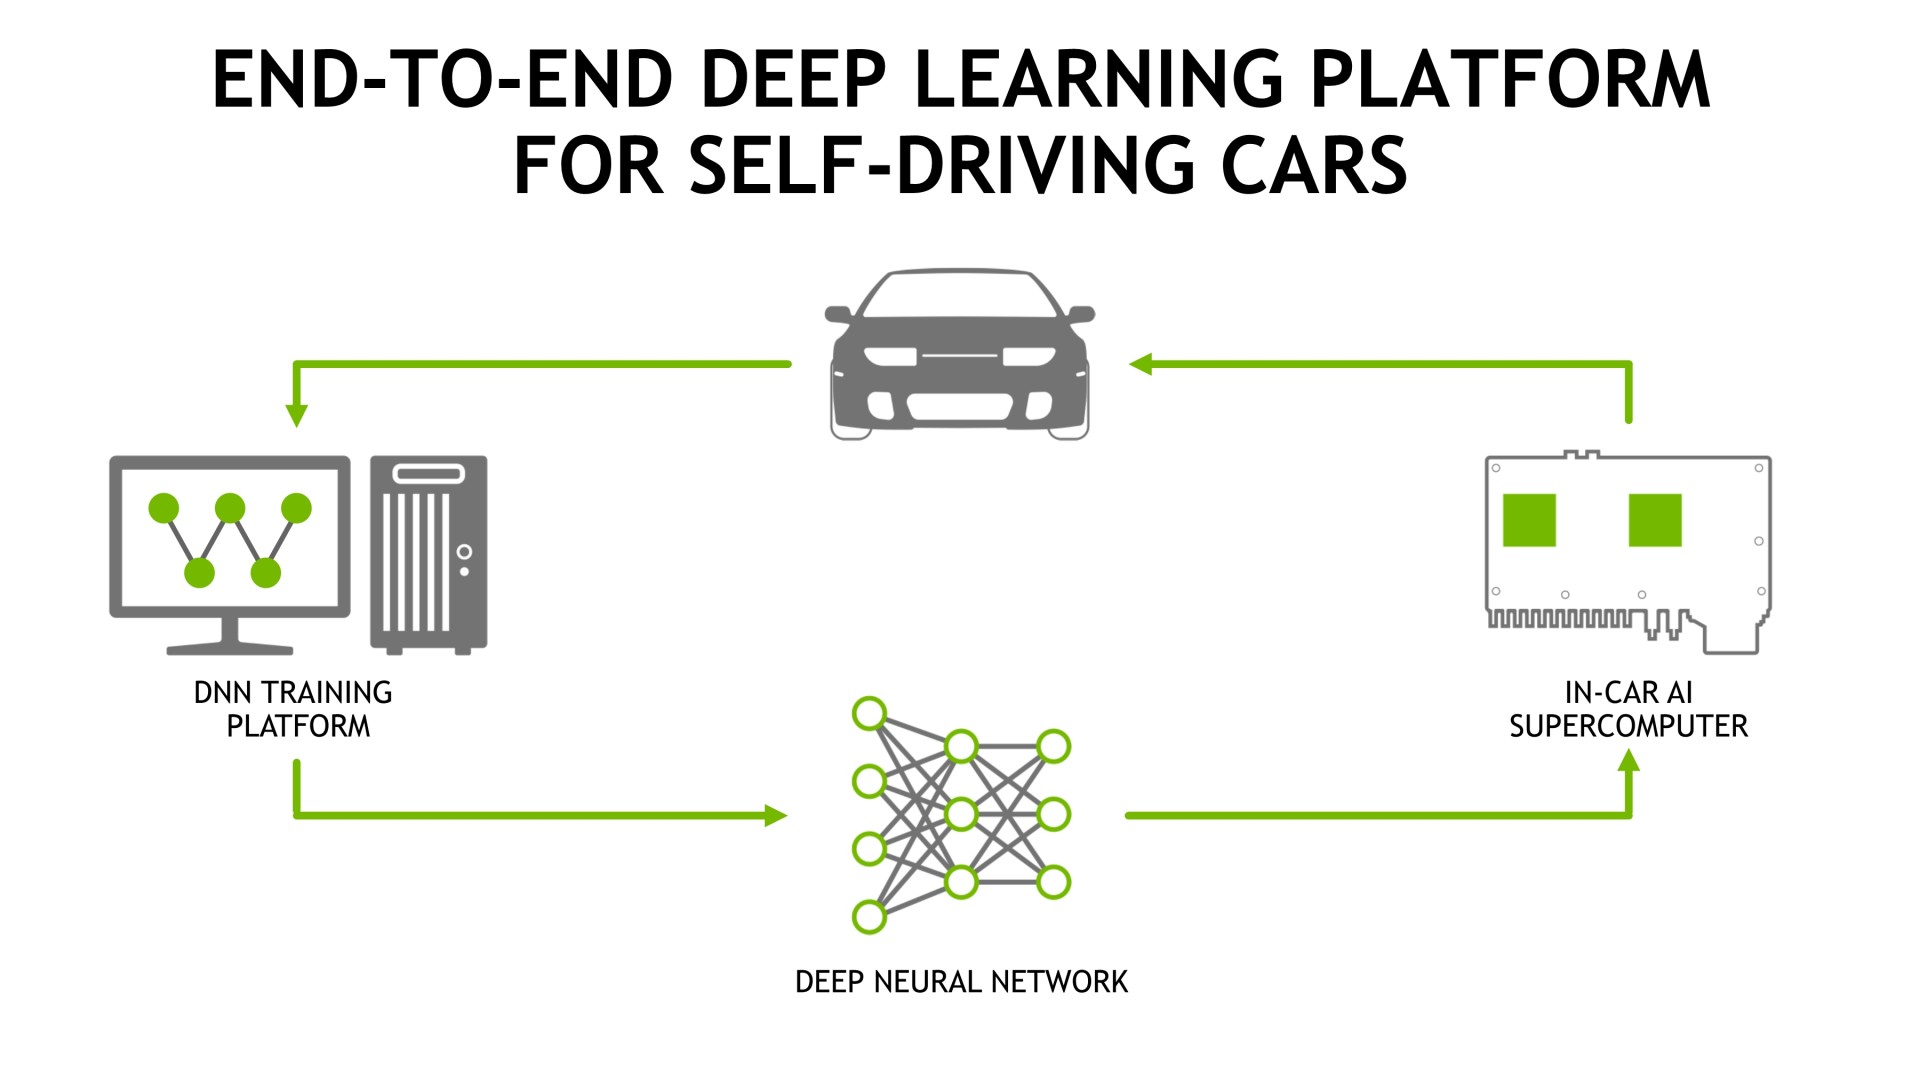
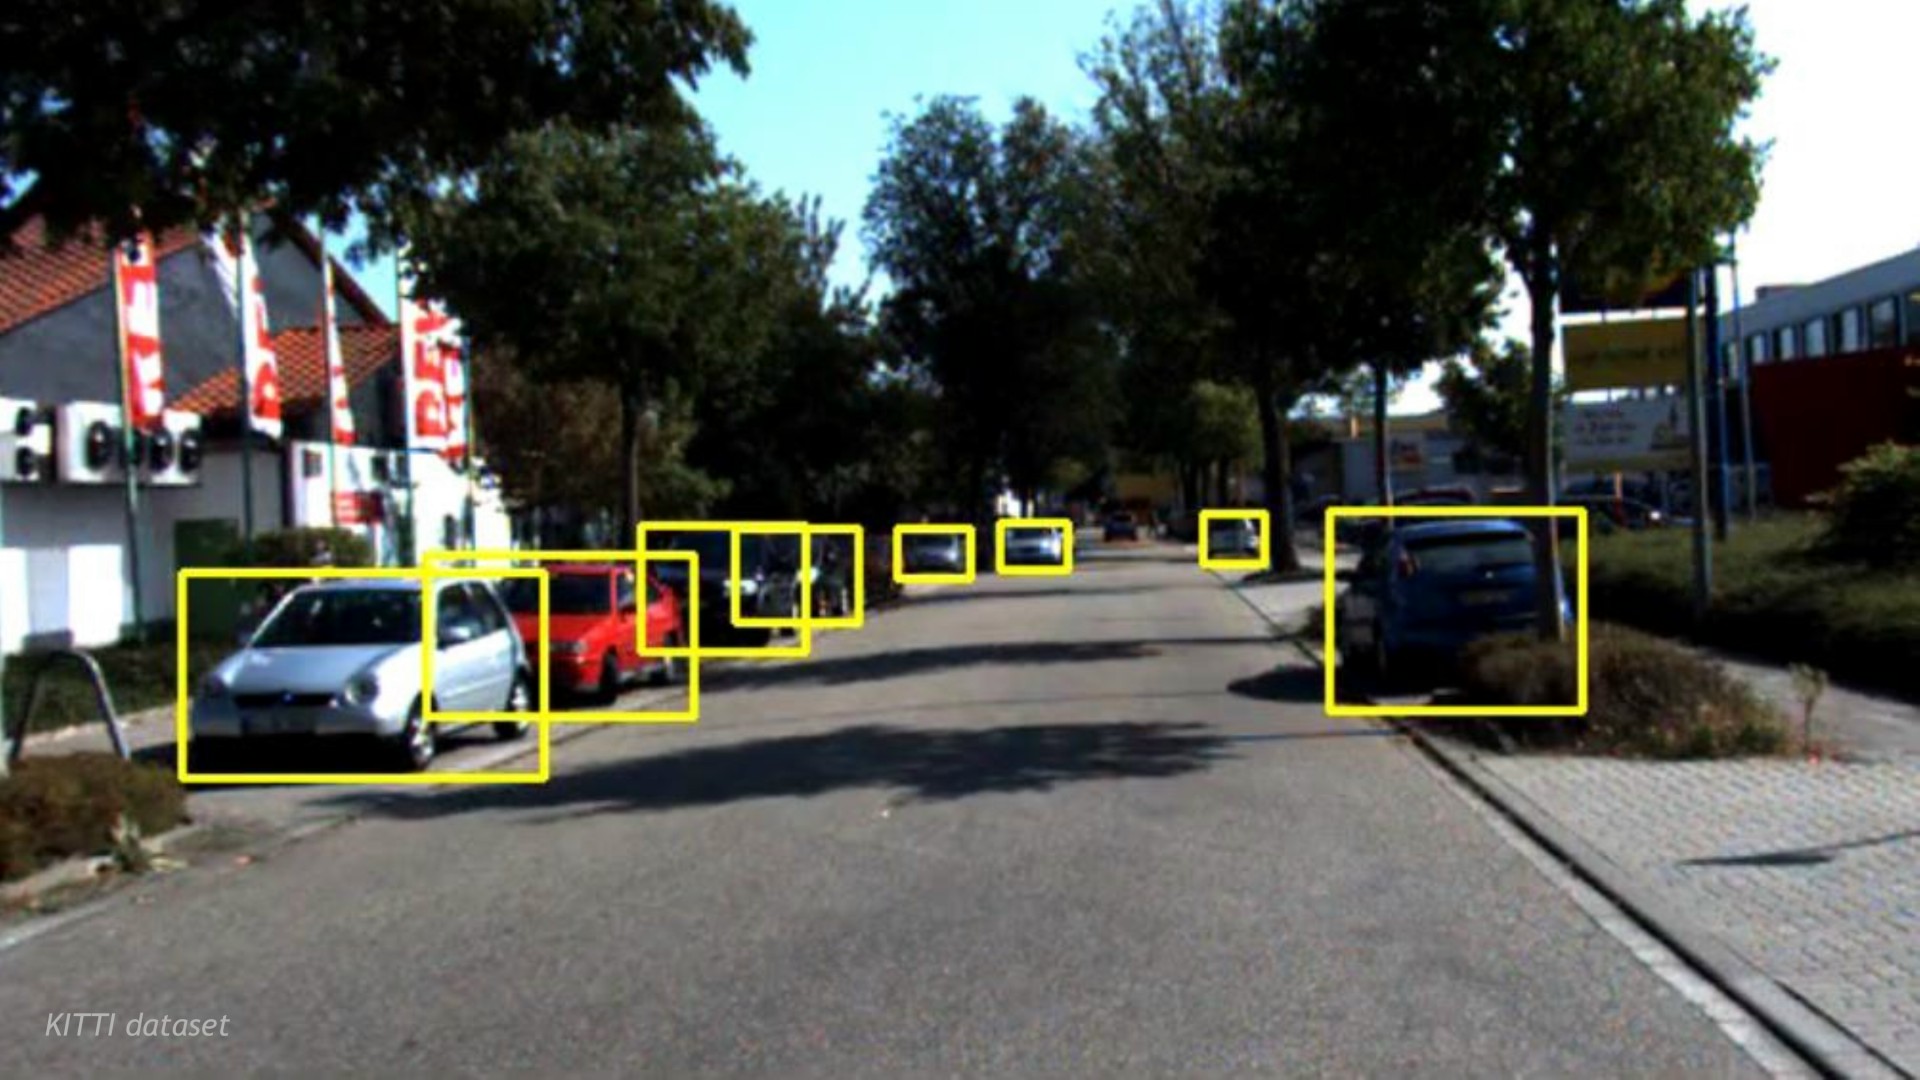
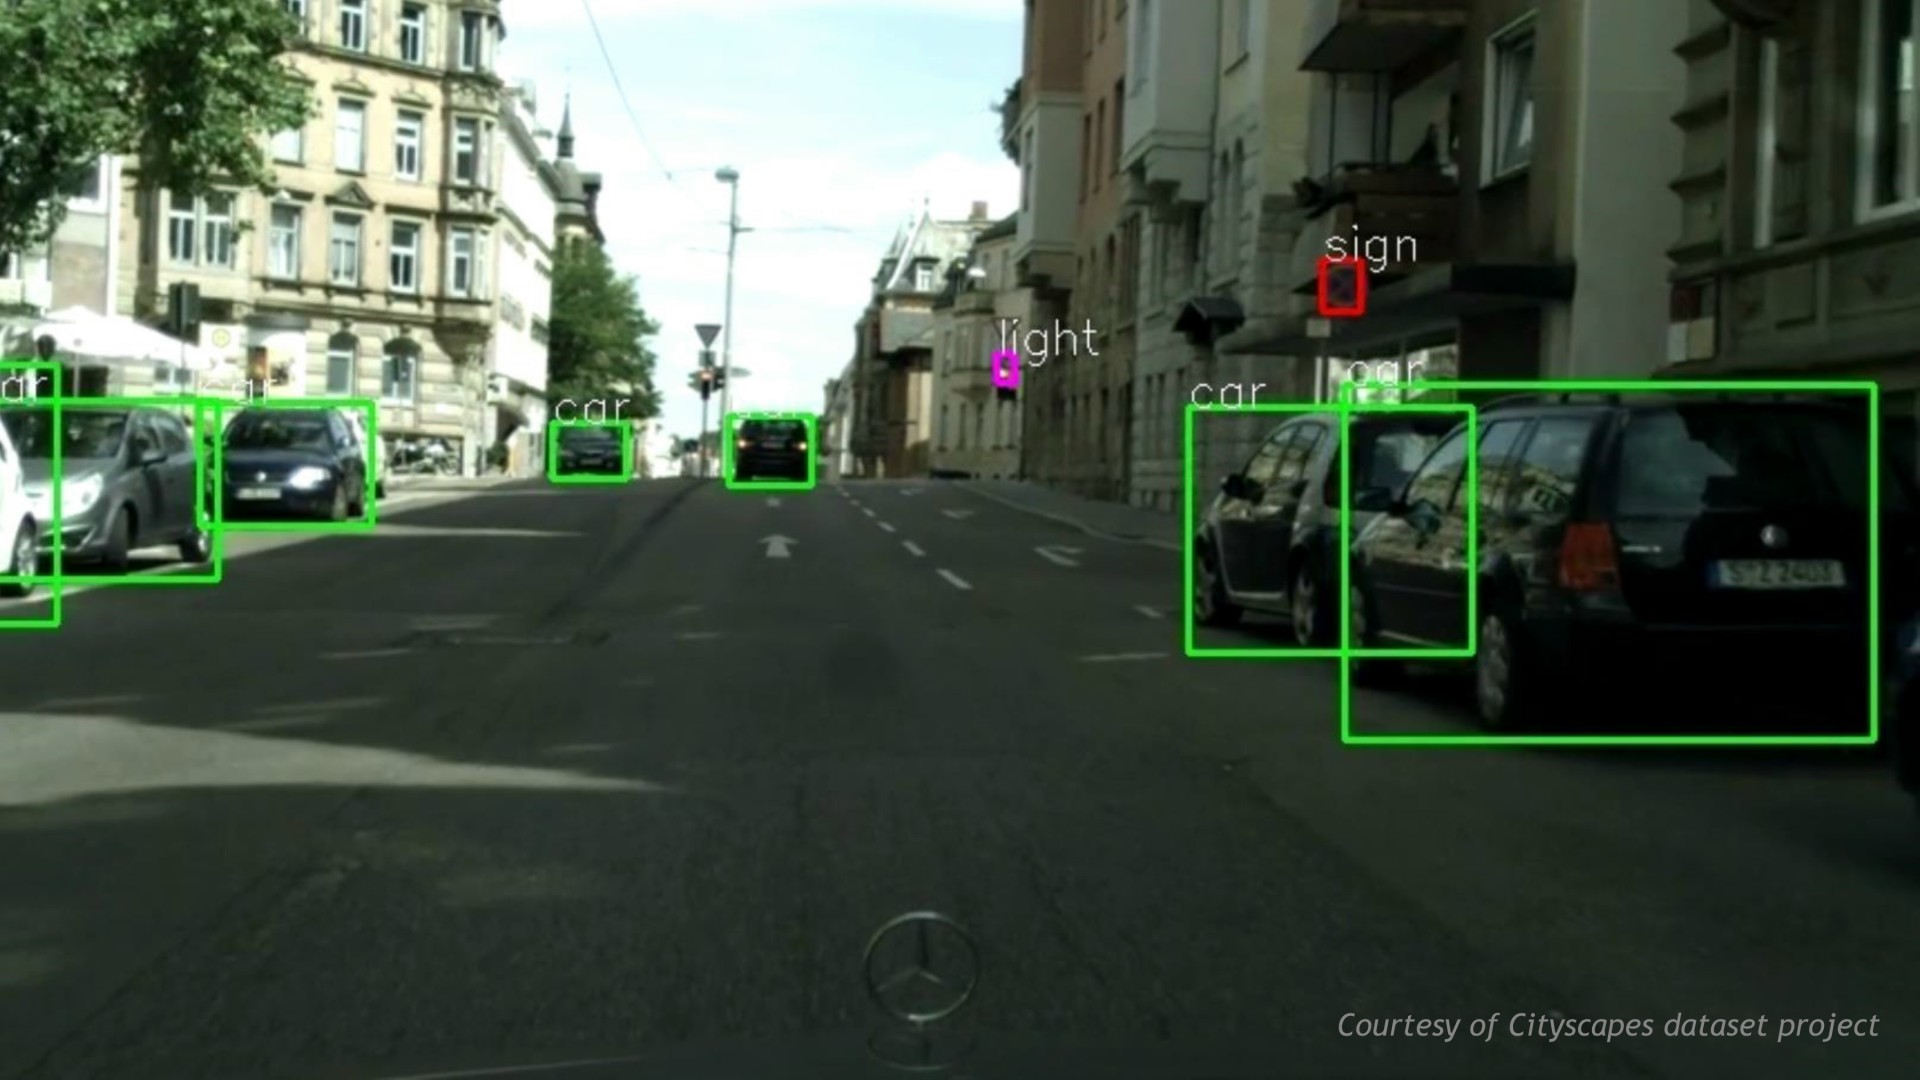
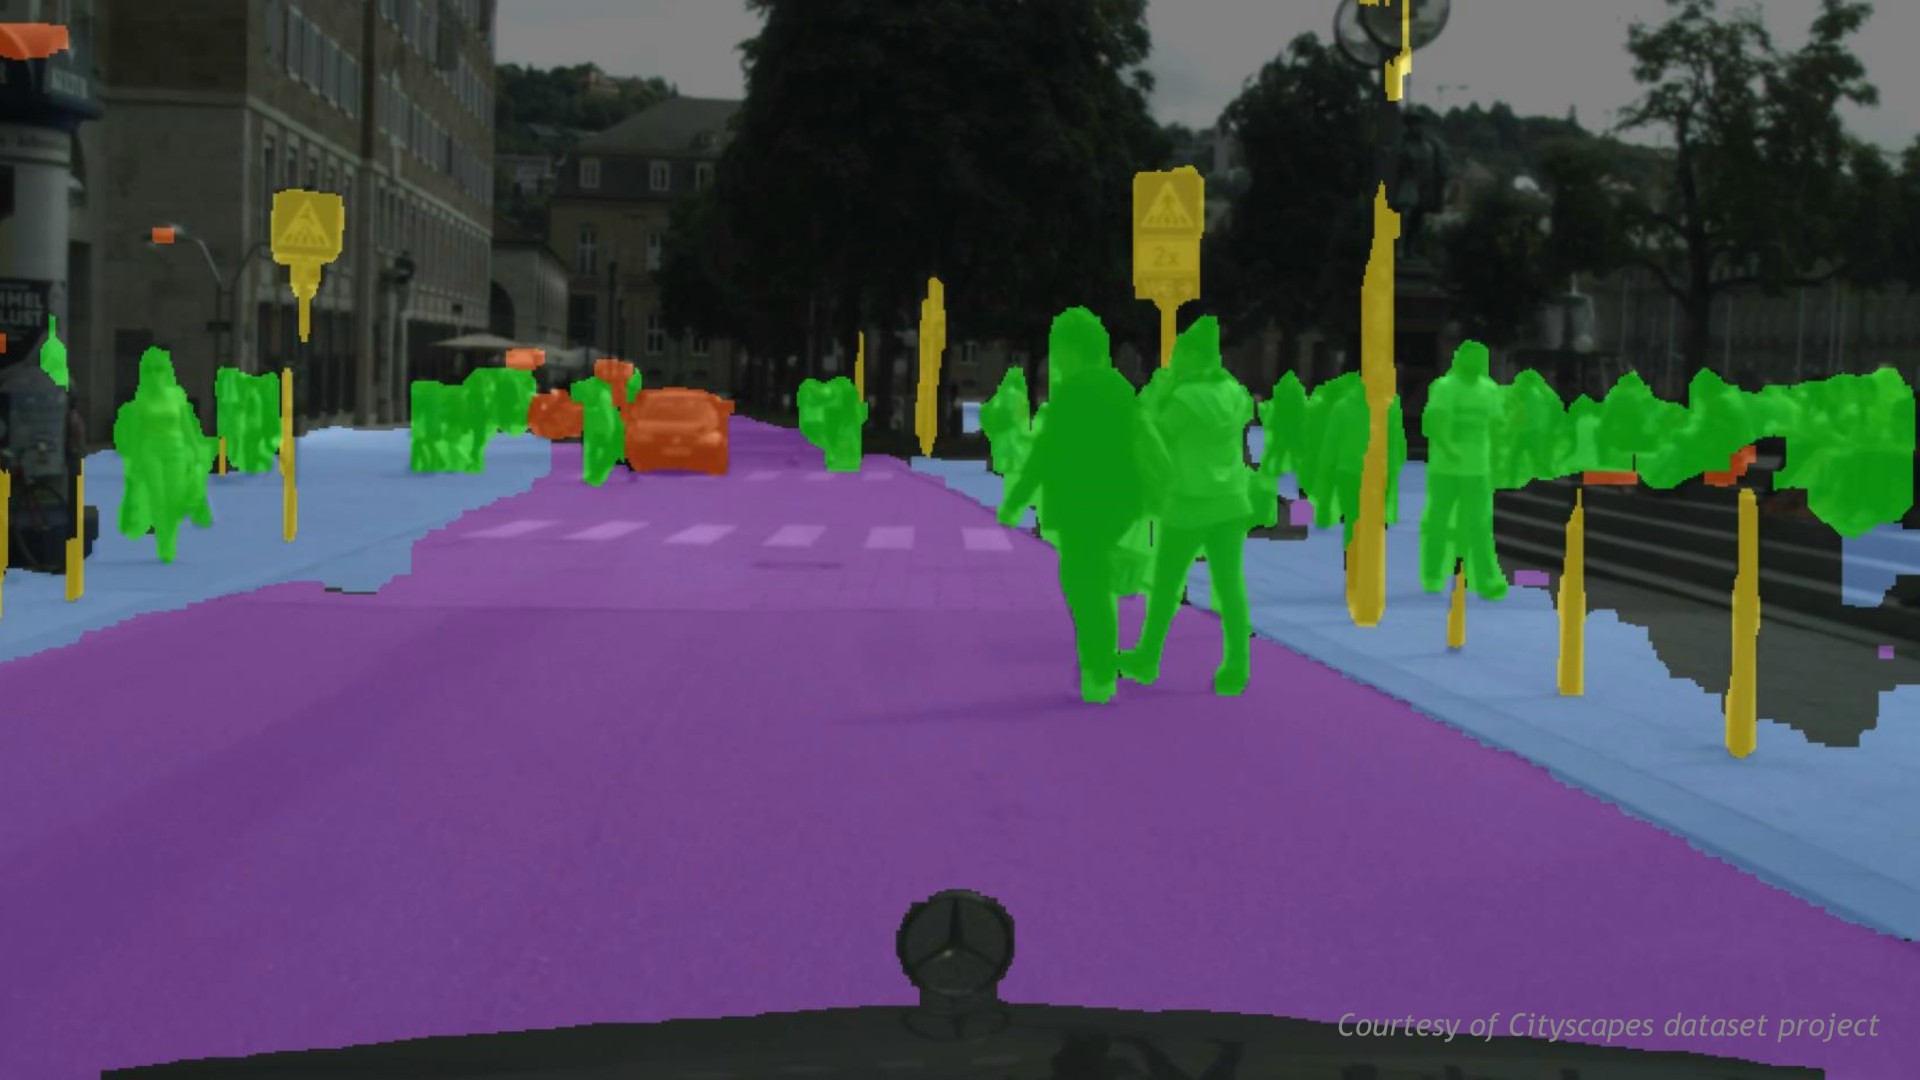
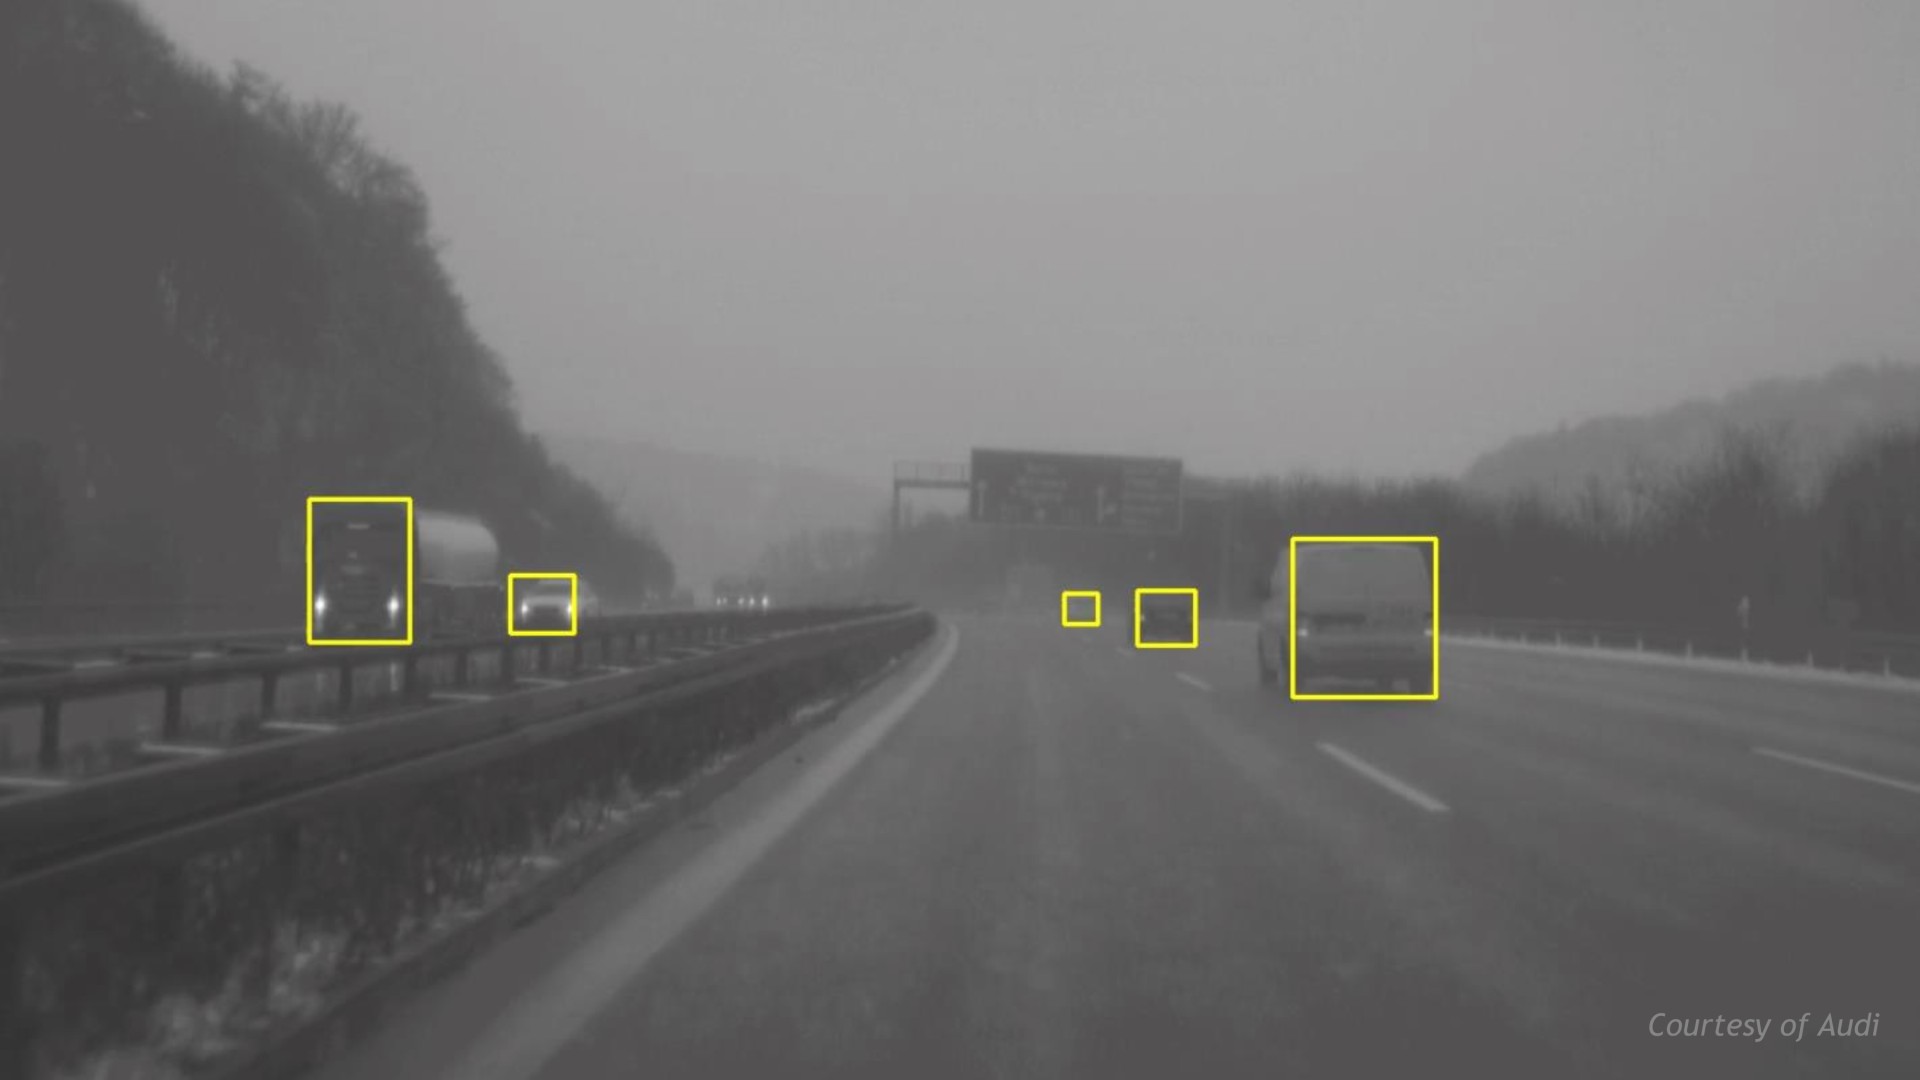
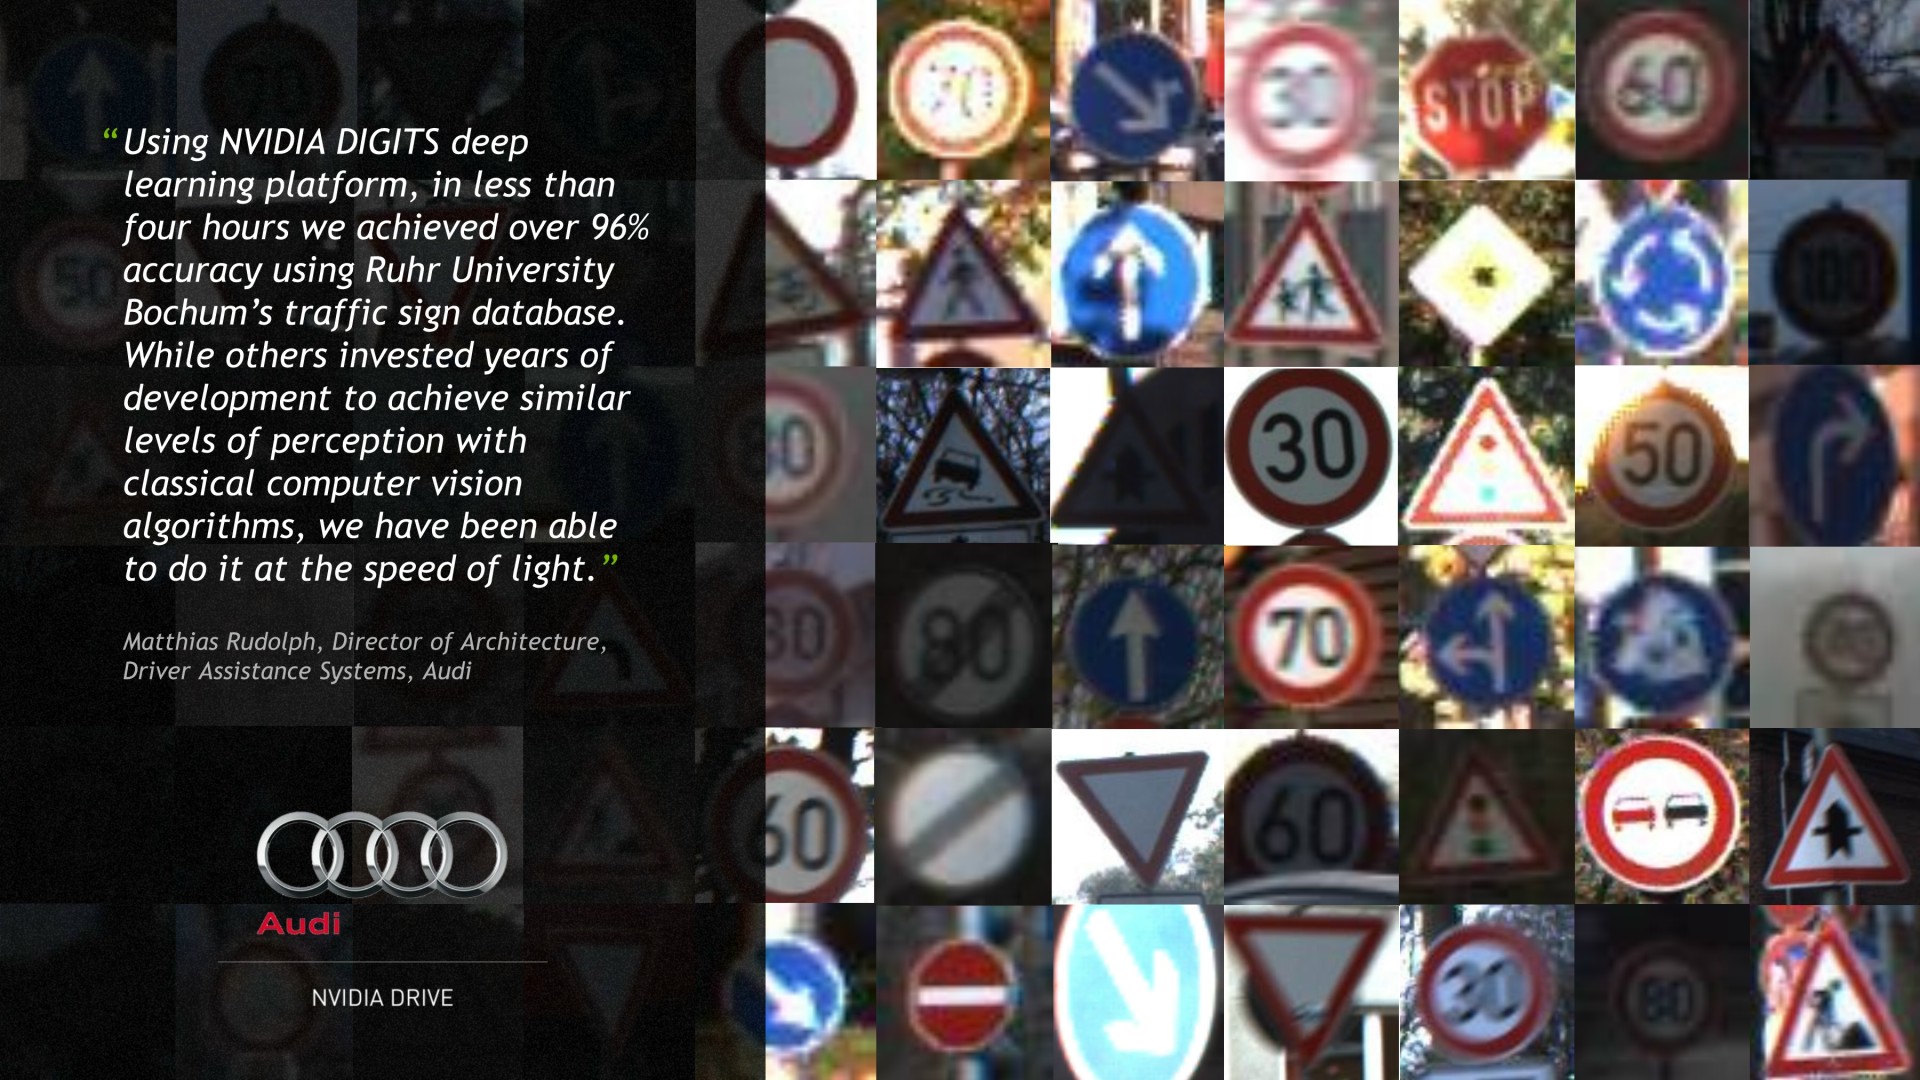
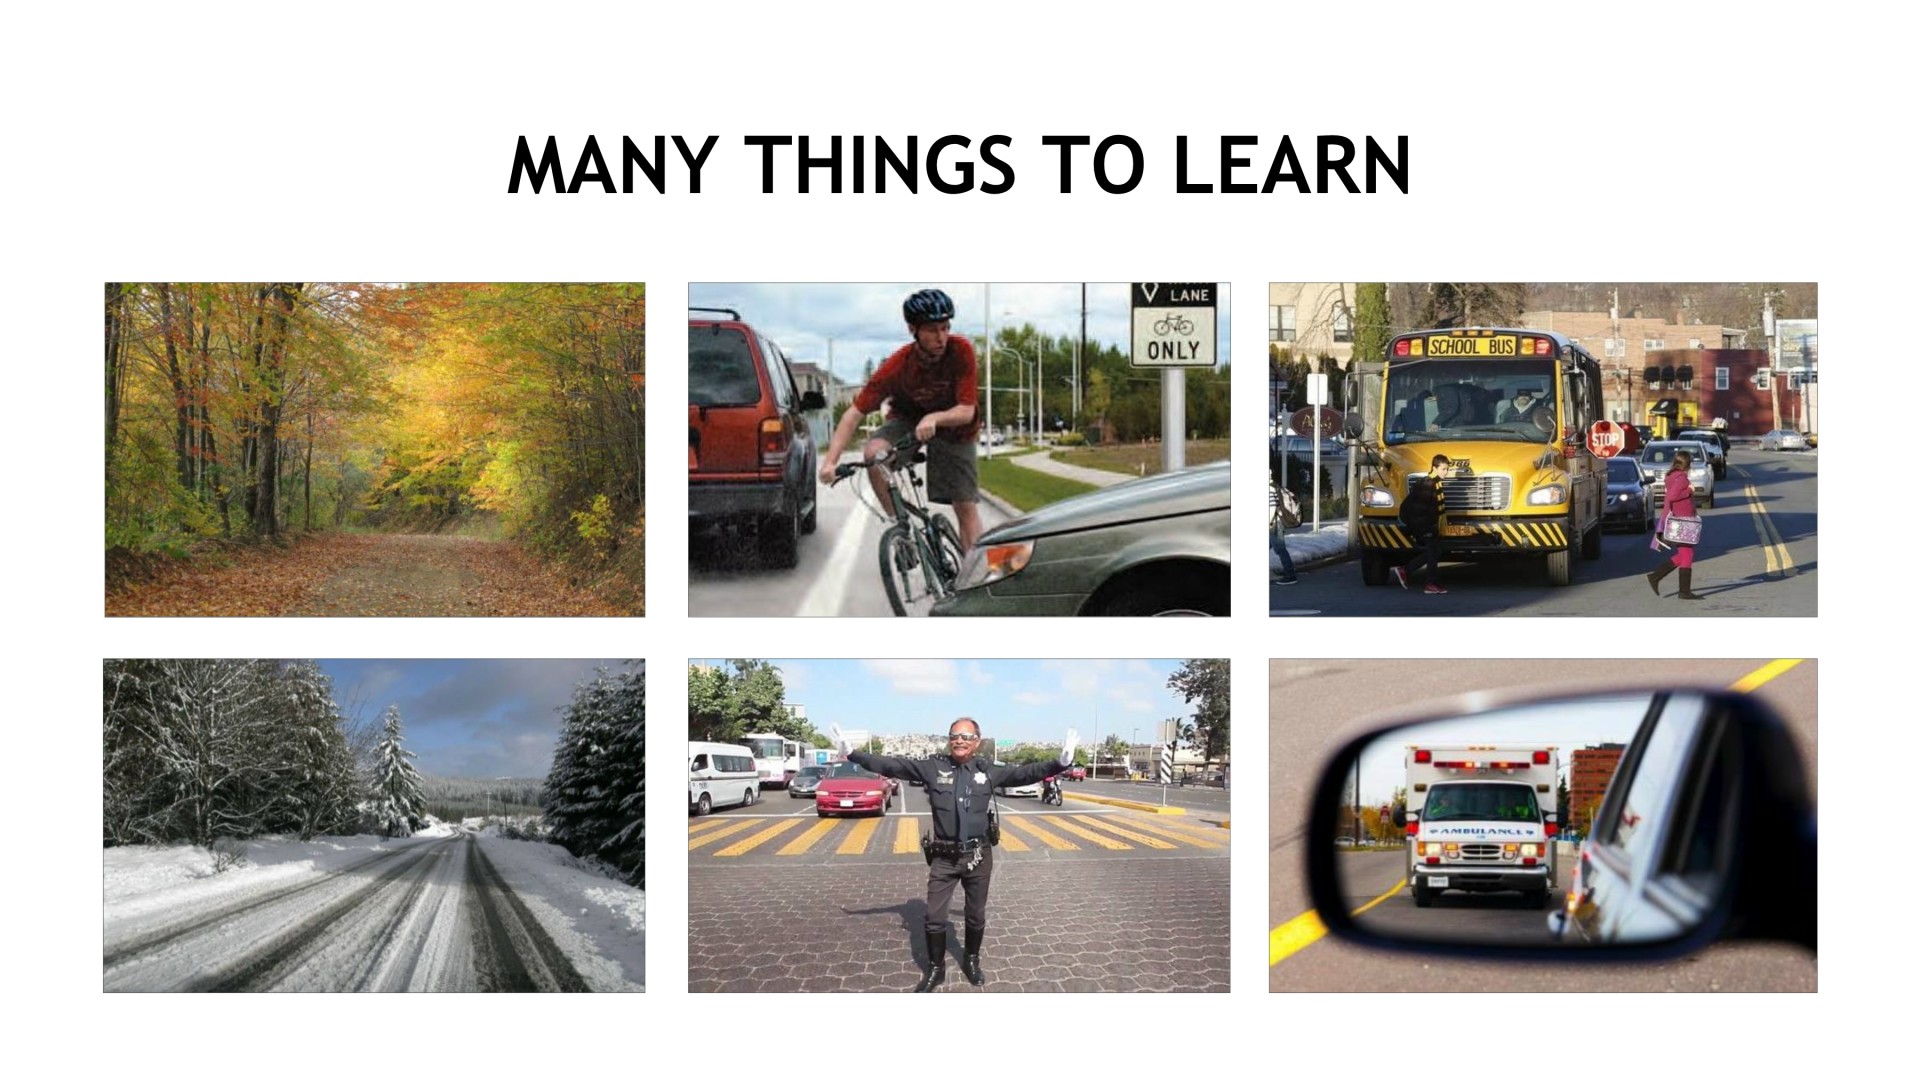
Cet aspect de l'évolution entreprise dans le monde des transports a d'une part besoin de plus de puissance de calcul et d'autre part d'une expertise dans le domaine du deep learning, soit de l'apprentissage progressif par un réseau de neurones artificiels (ce qui fonctionne extrêmement bien dans le cas de la reconnaissance d'éléments à l'intérieur d'une série d'images). Deux points pour lesquels Nvidia peut compter sur ses technologies et ses ingénieurs pour essayer de se démarquer.
L'an passé, Nvidia a ainsi annoncé Drive PX, une plateforme de pilotage automatique bâtie autour de 2 SoC Tegra X1. Mais comme c'est devenu une tradition avec ces SoC, plusieurs annonces annuelles successives sont nécessaires avant que des résultats n'émergent éventuellement. Drive PX n'aura donc pas réellement d'existence commerciale et se contentera des rôles de kit de développement et d'illustration de la stratégie de Nvidia.
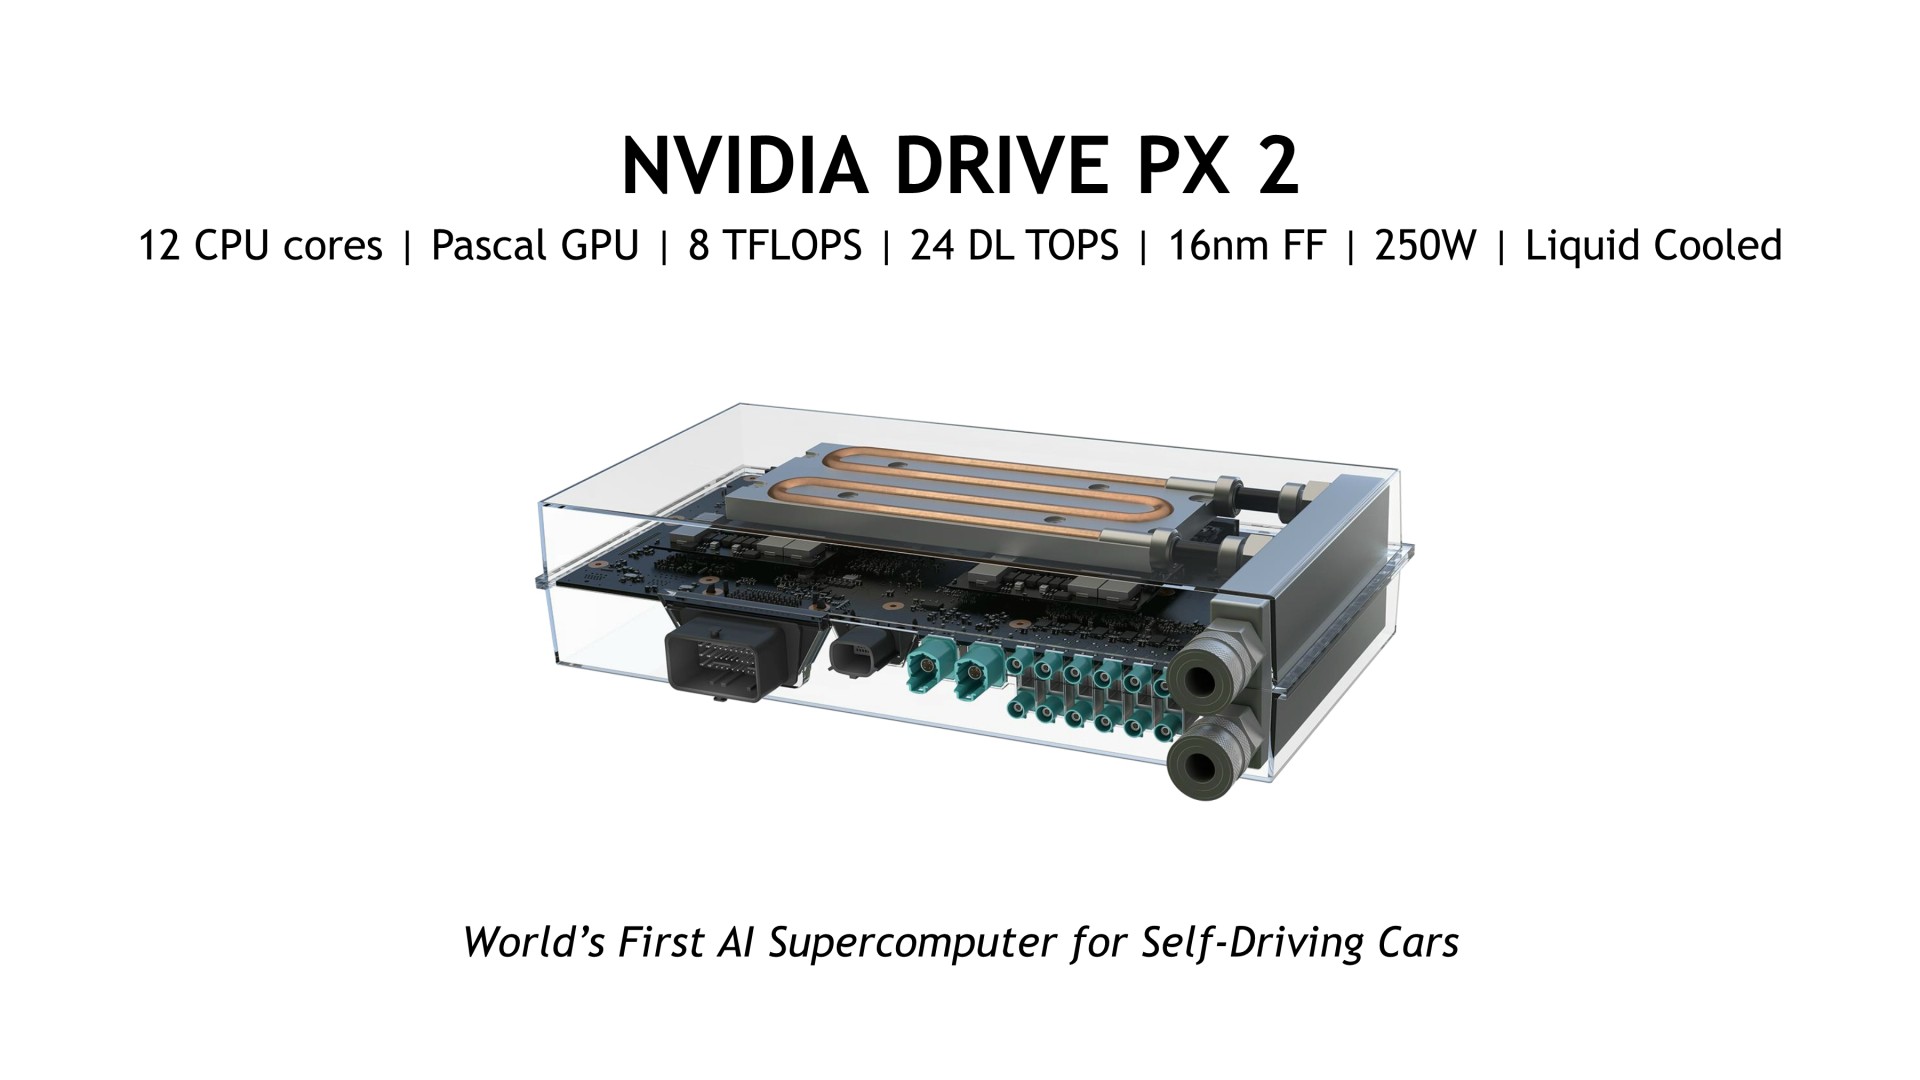
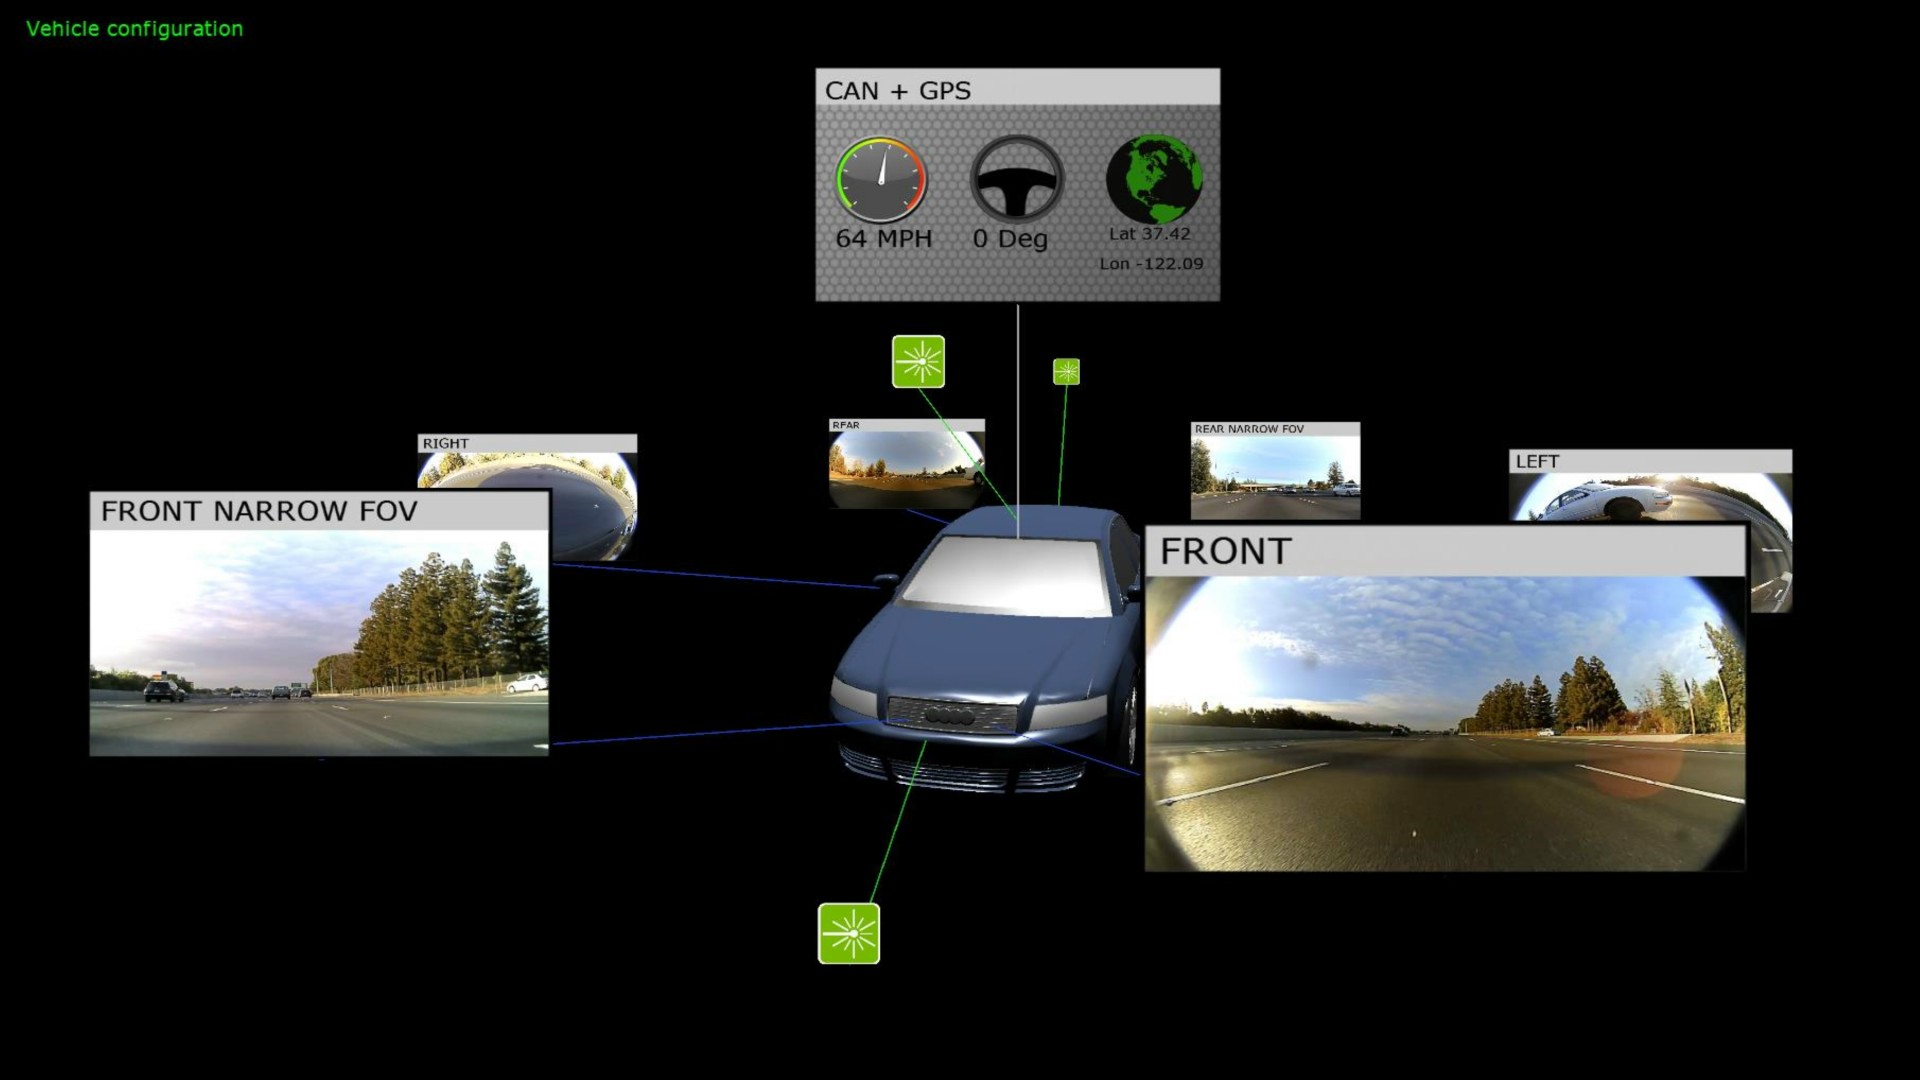
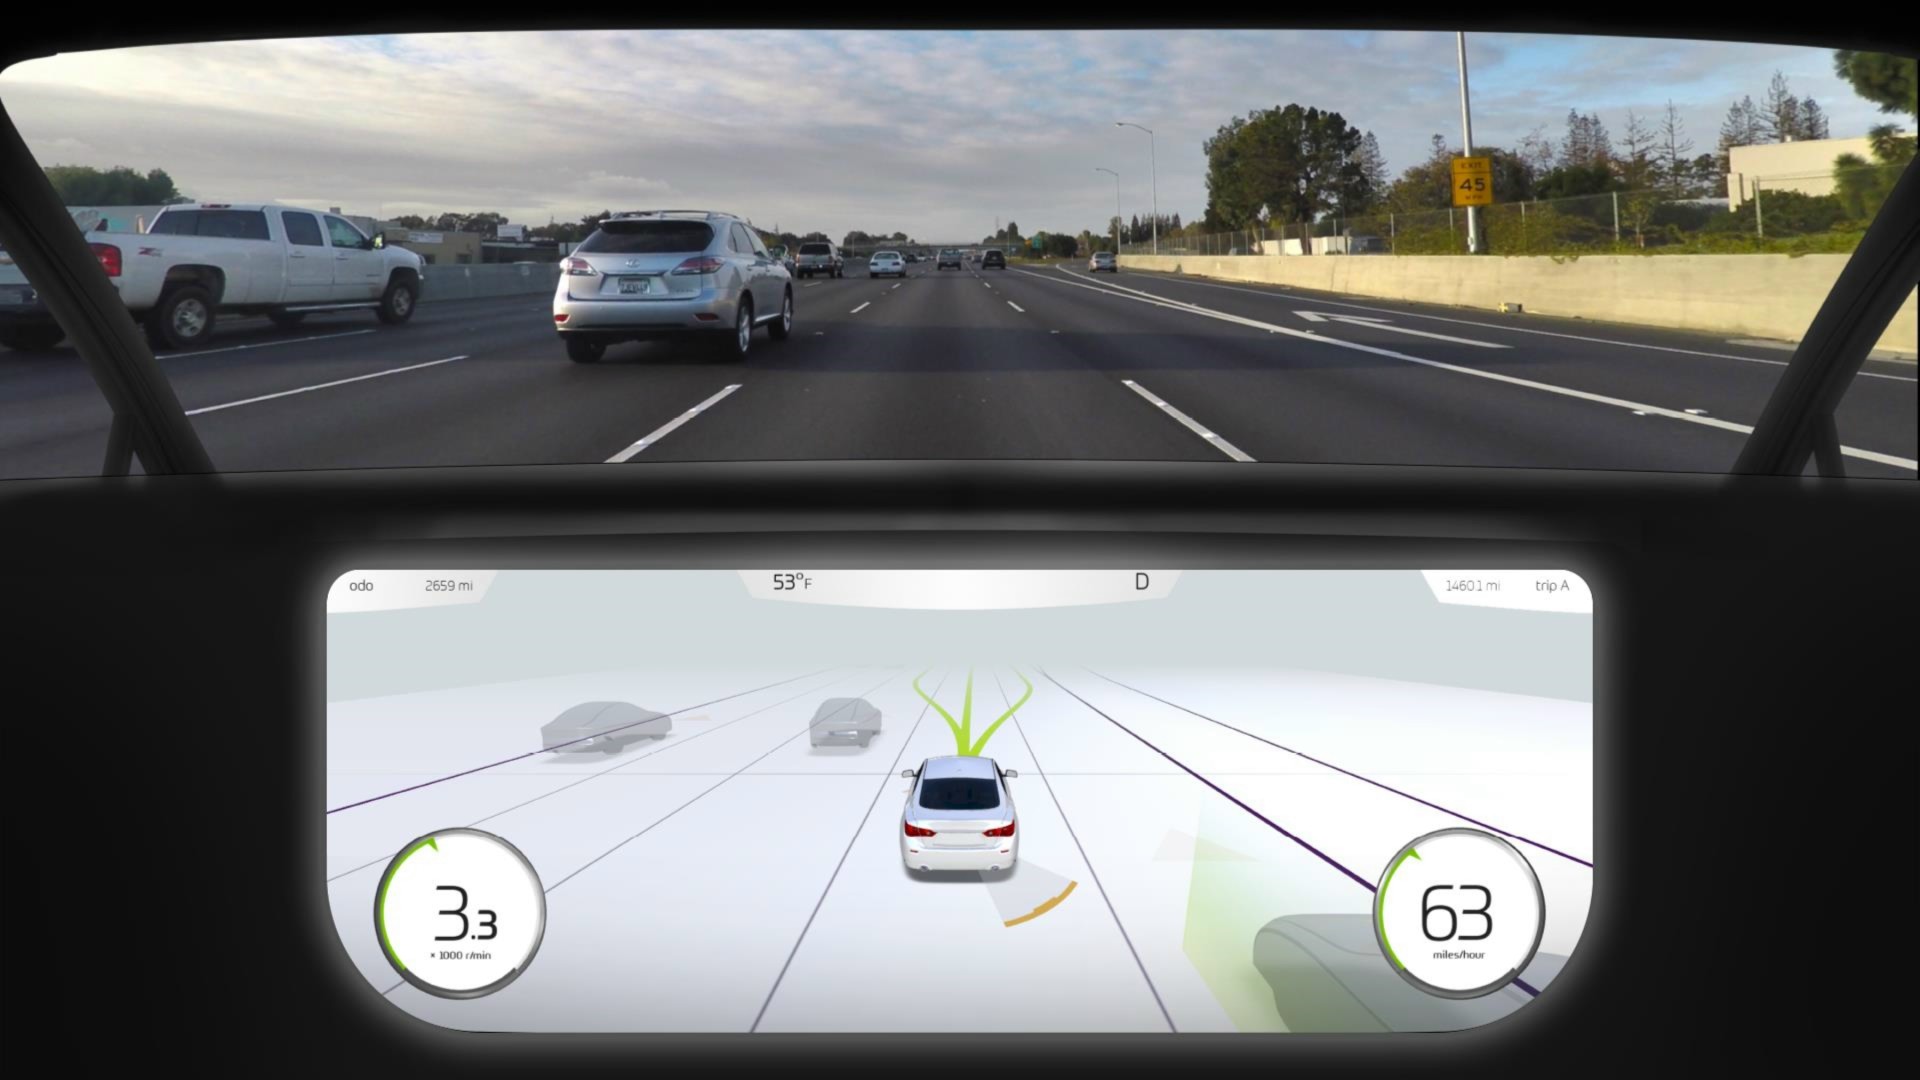
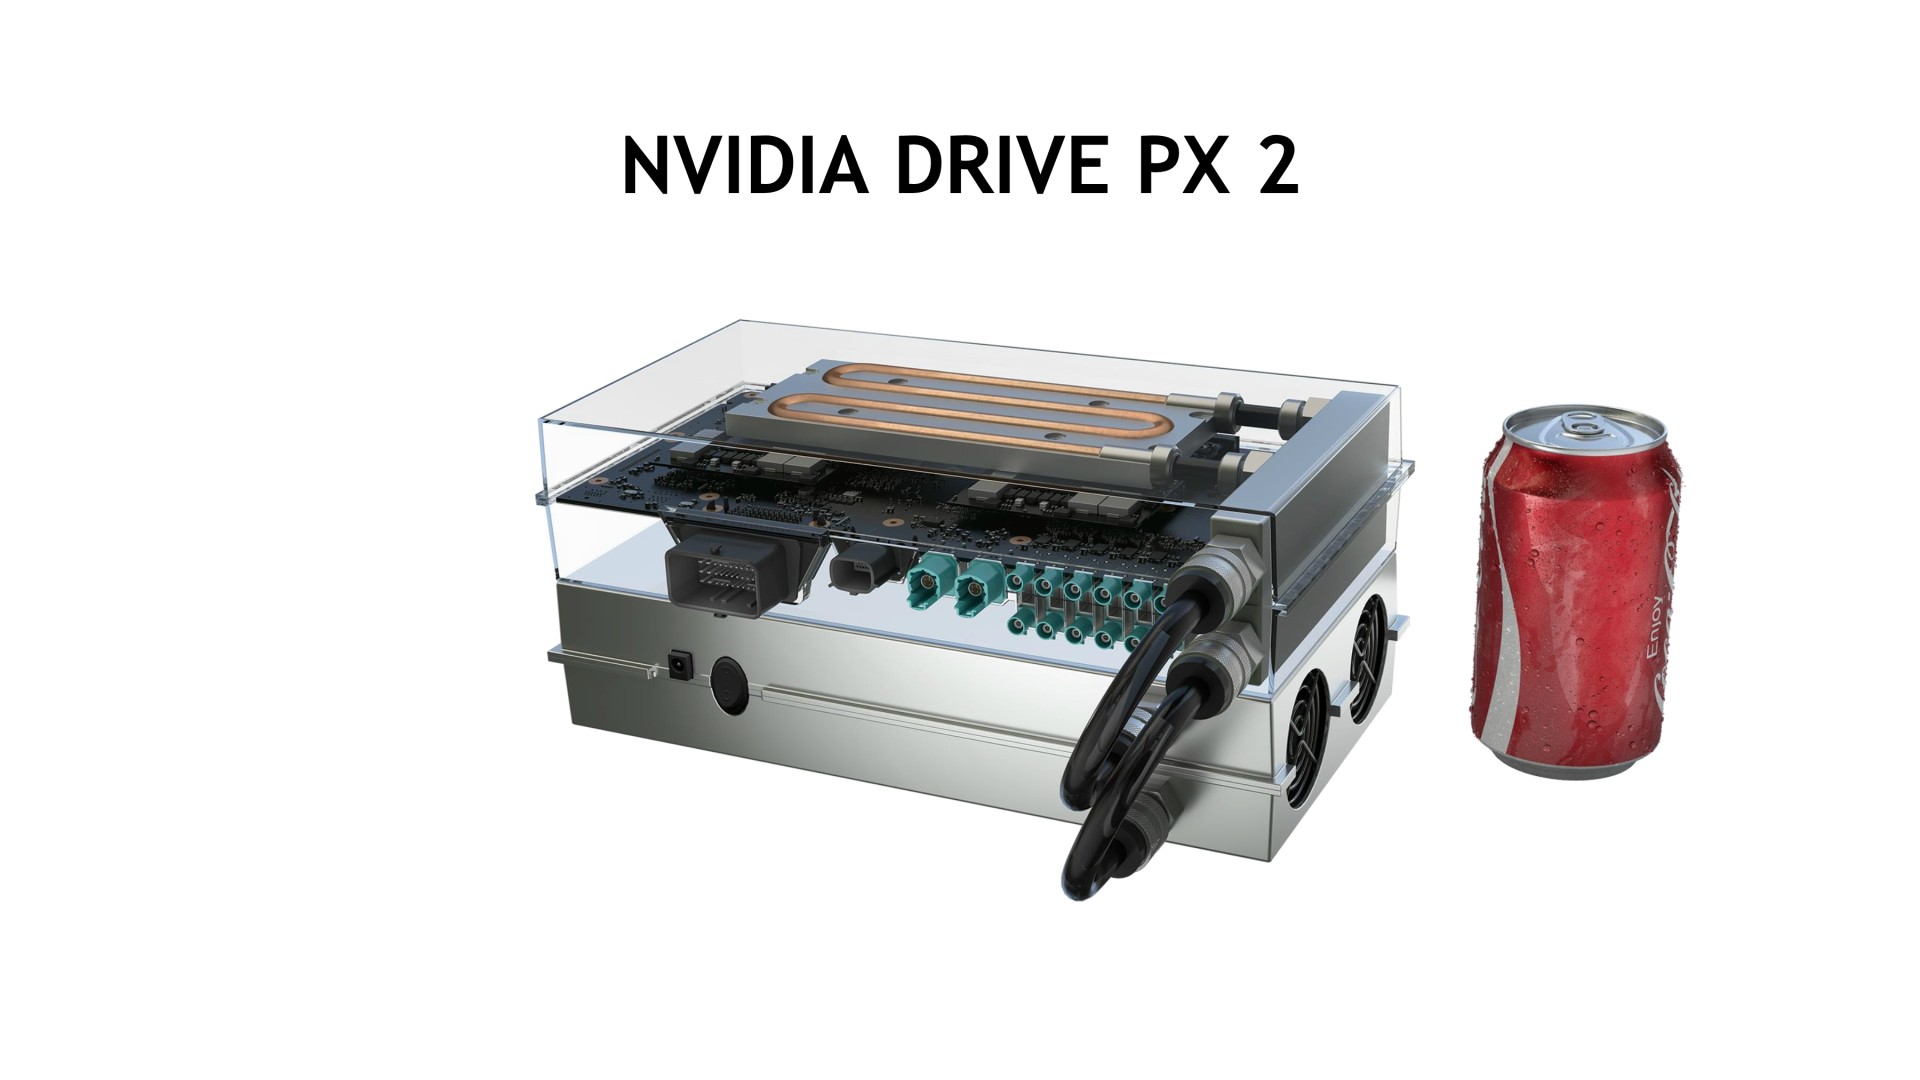
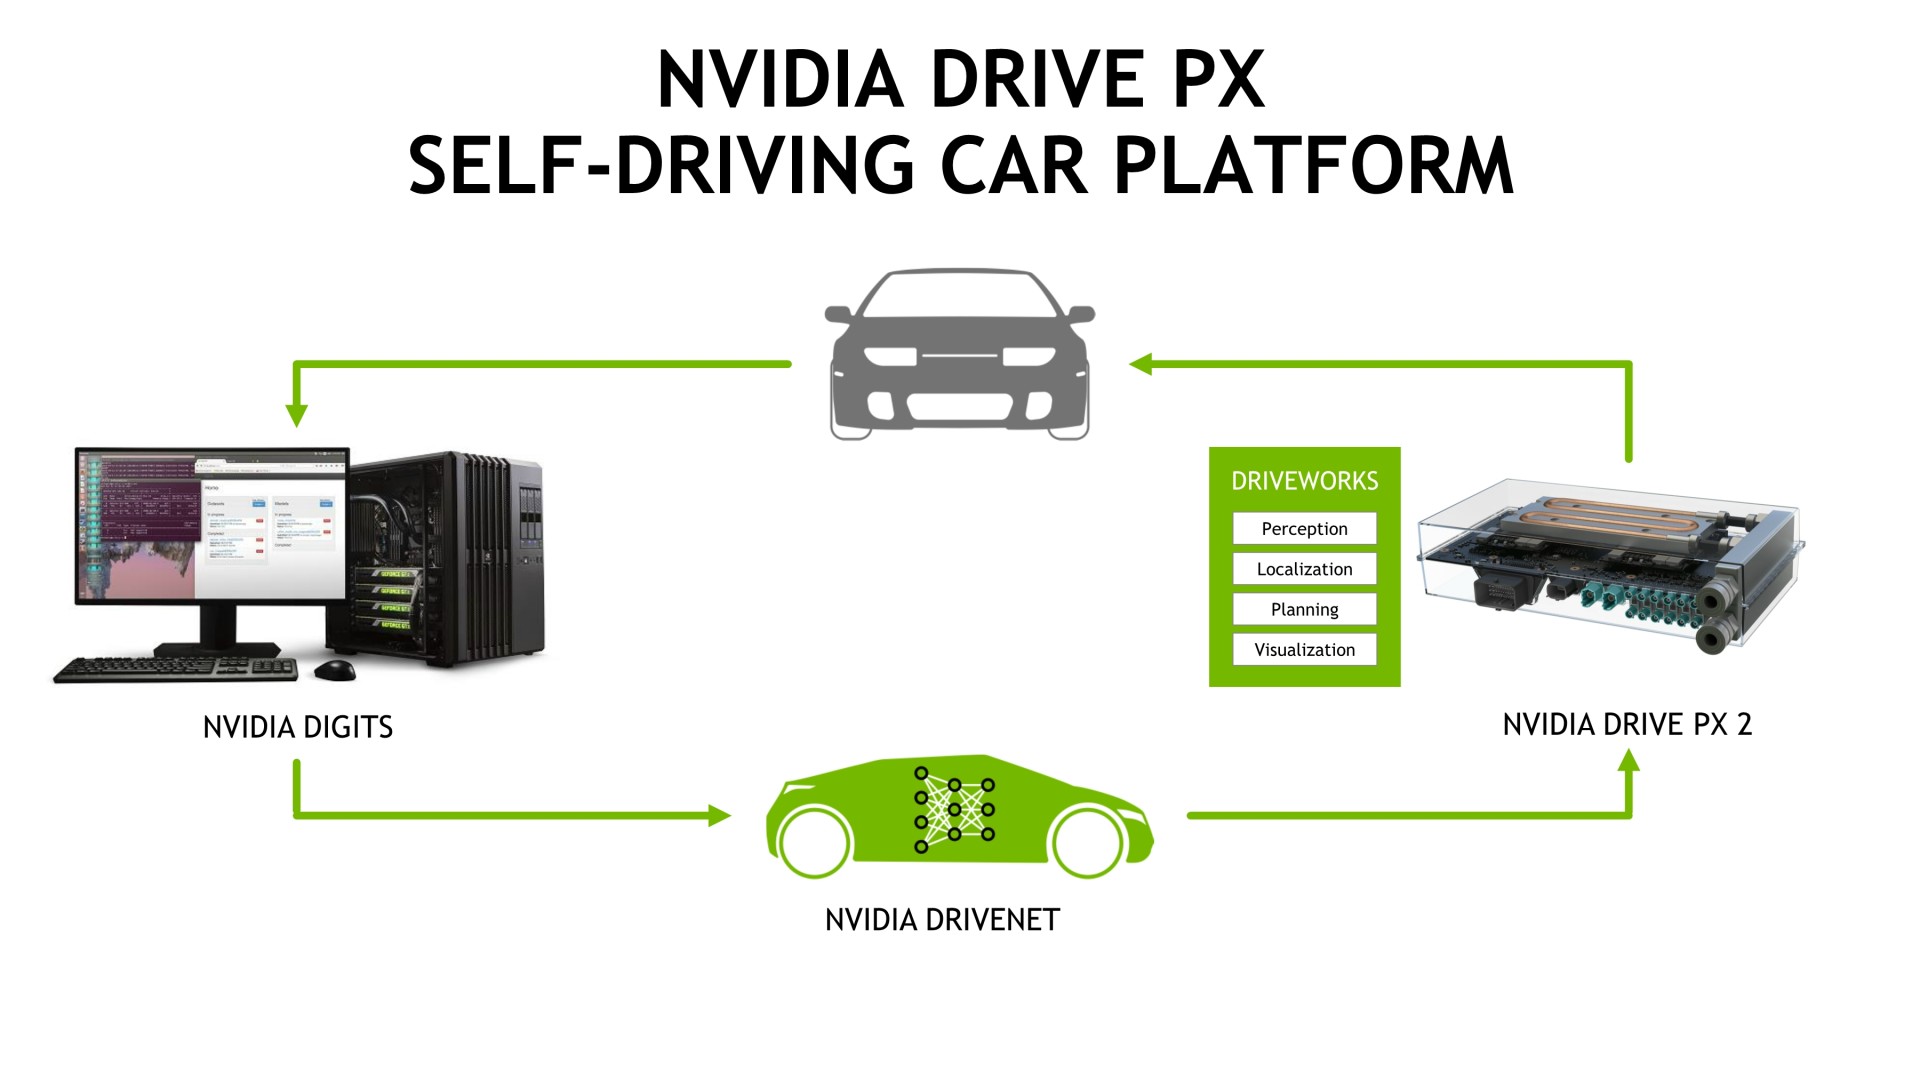
Fort logiquement, lors de ce CES, Nvidia a donc doublé la mise et annoncé son successeur, Drive PX 2, et peaufiné son angle d'attaque pour ce nouveau marché. Au cours des développements entrepris avec Drive PX, Nvidia a probablement fait le constat que sa solution n'était pas suffisamment performante, notamment au niveau des GPU Maxwell intégrés aux 2 Tegra X1 qui sont chargés de la détection des véhicules, personnes, panneaux et autres obstacles.
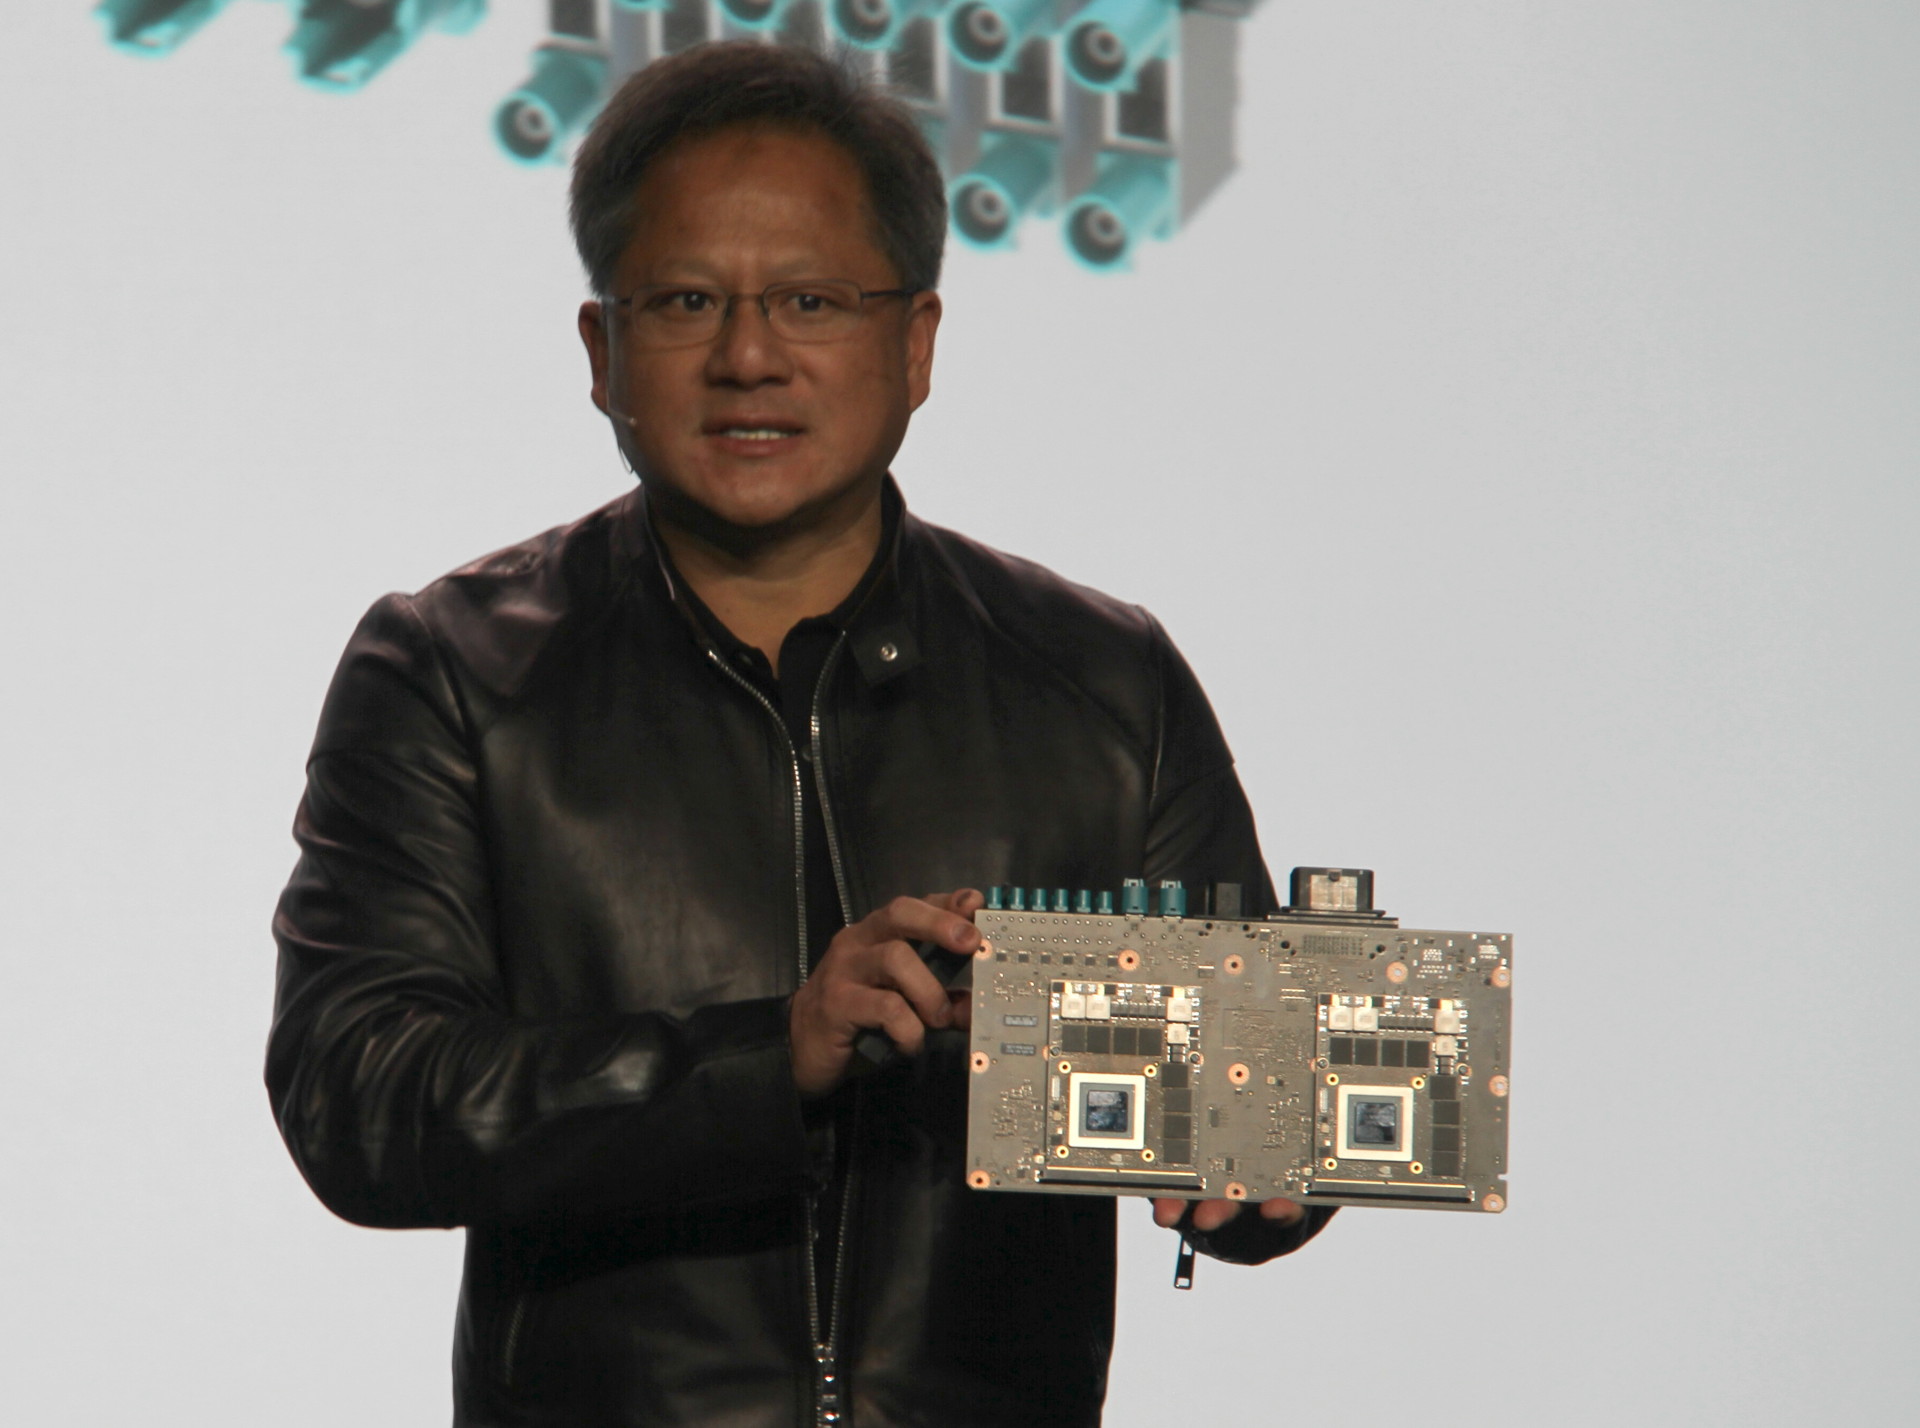
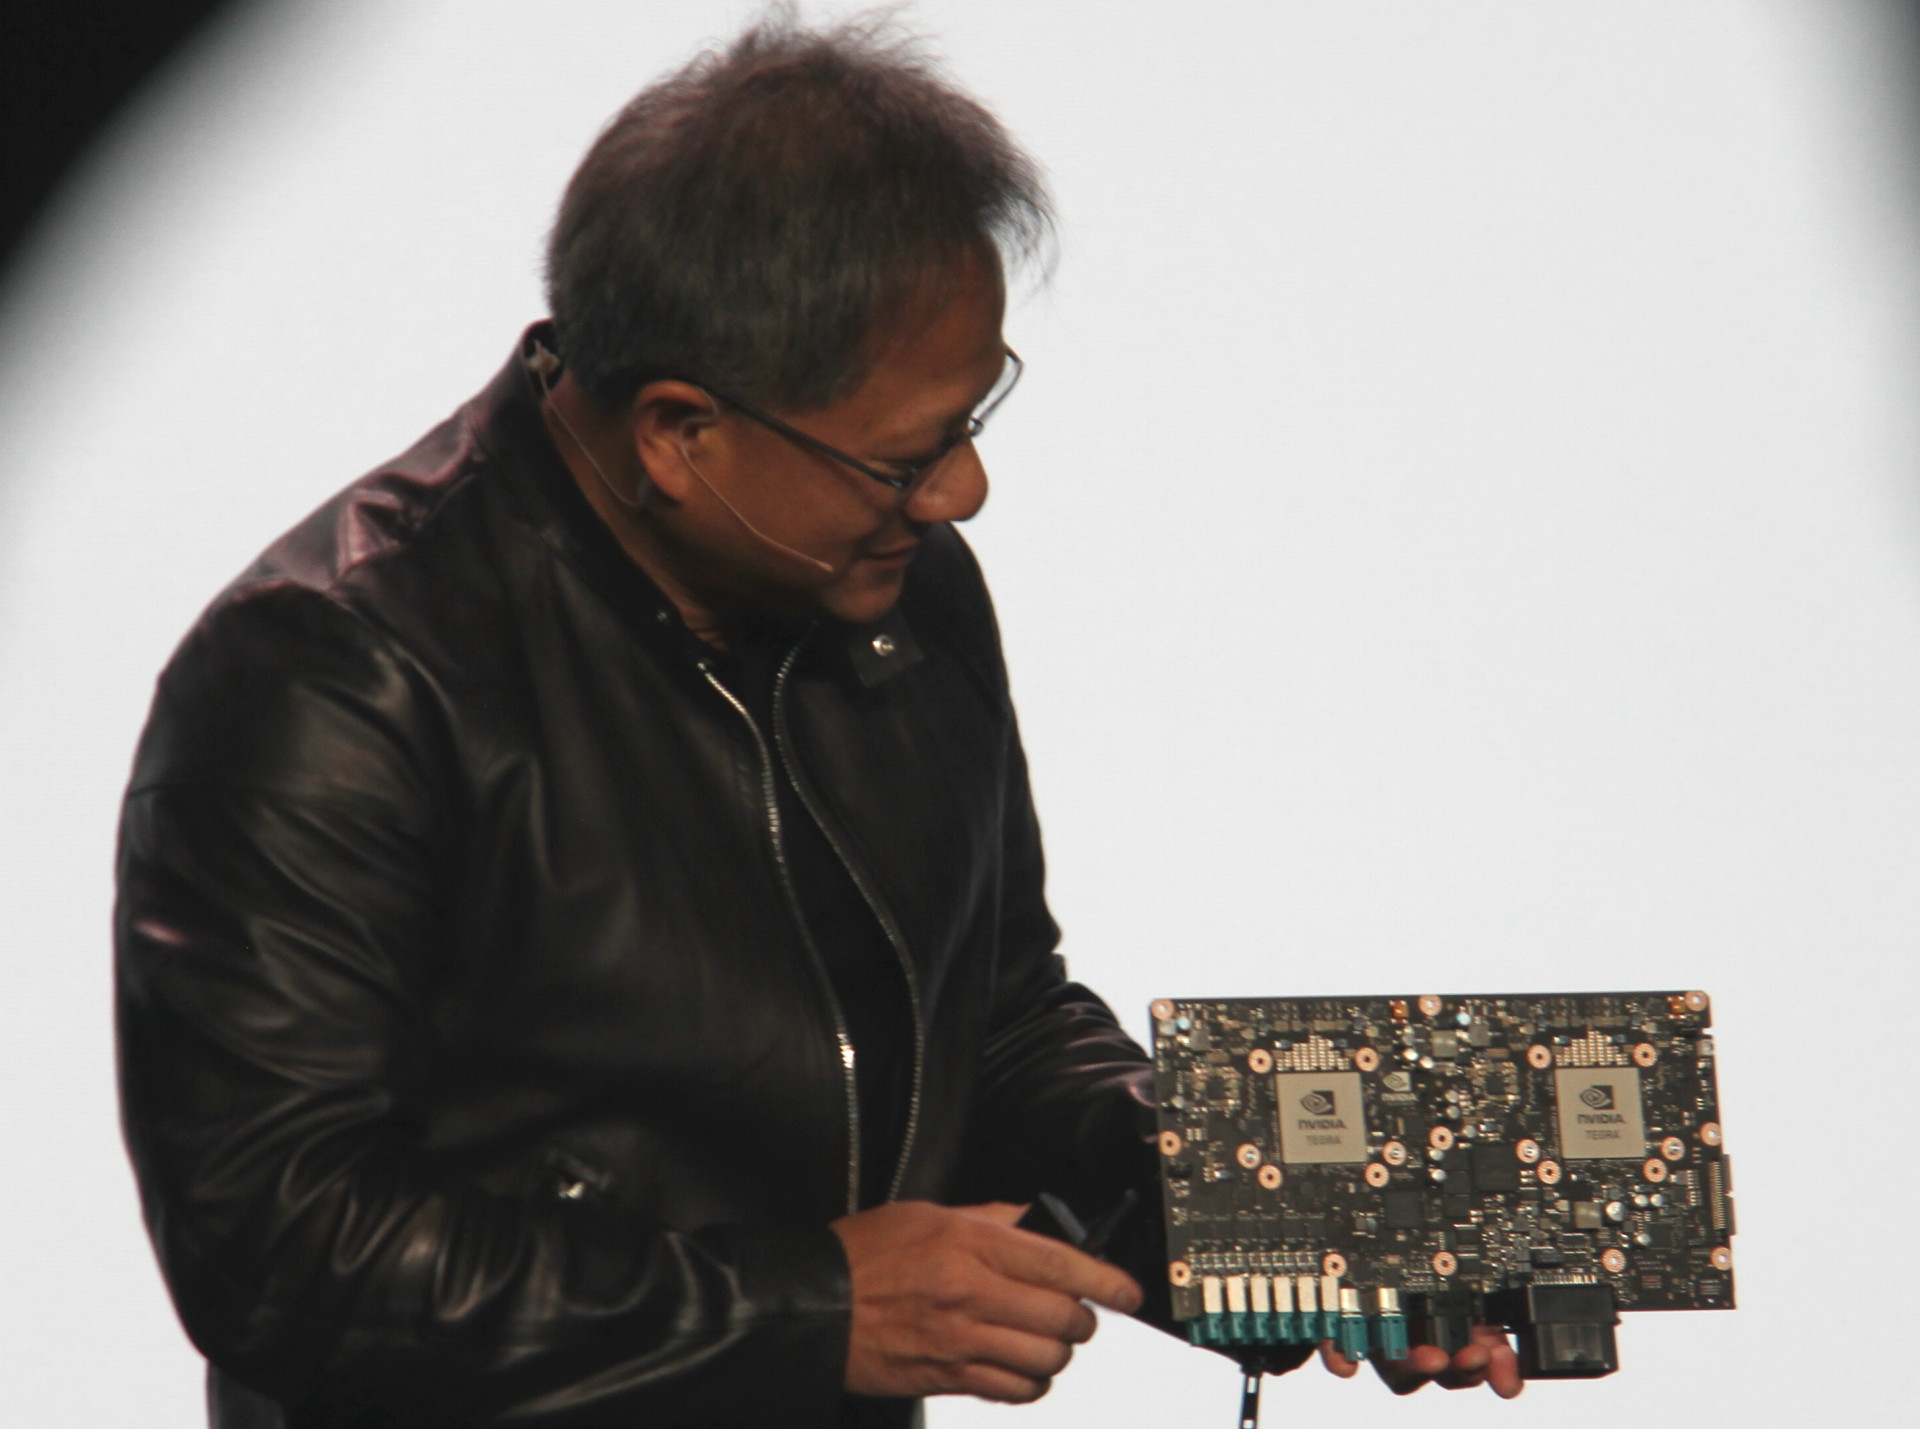
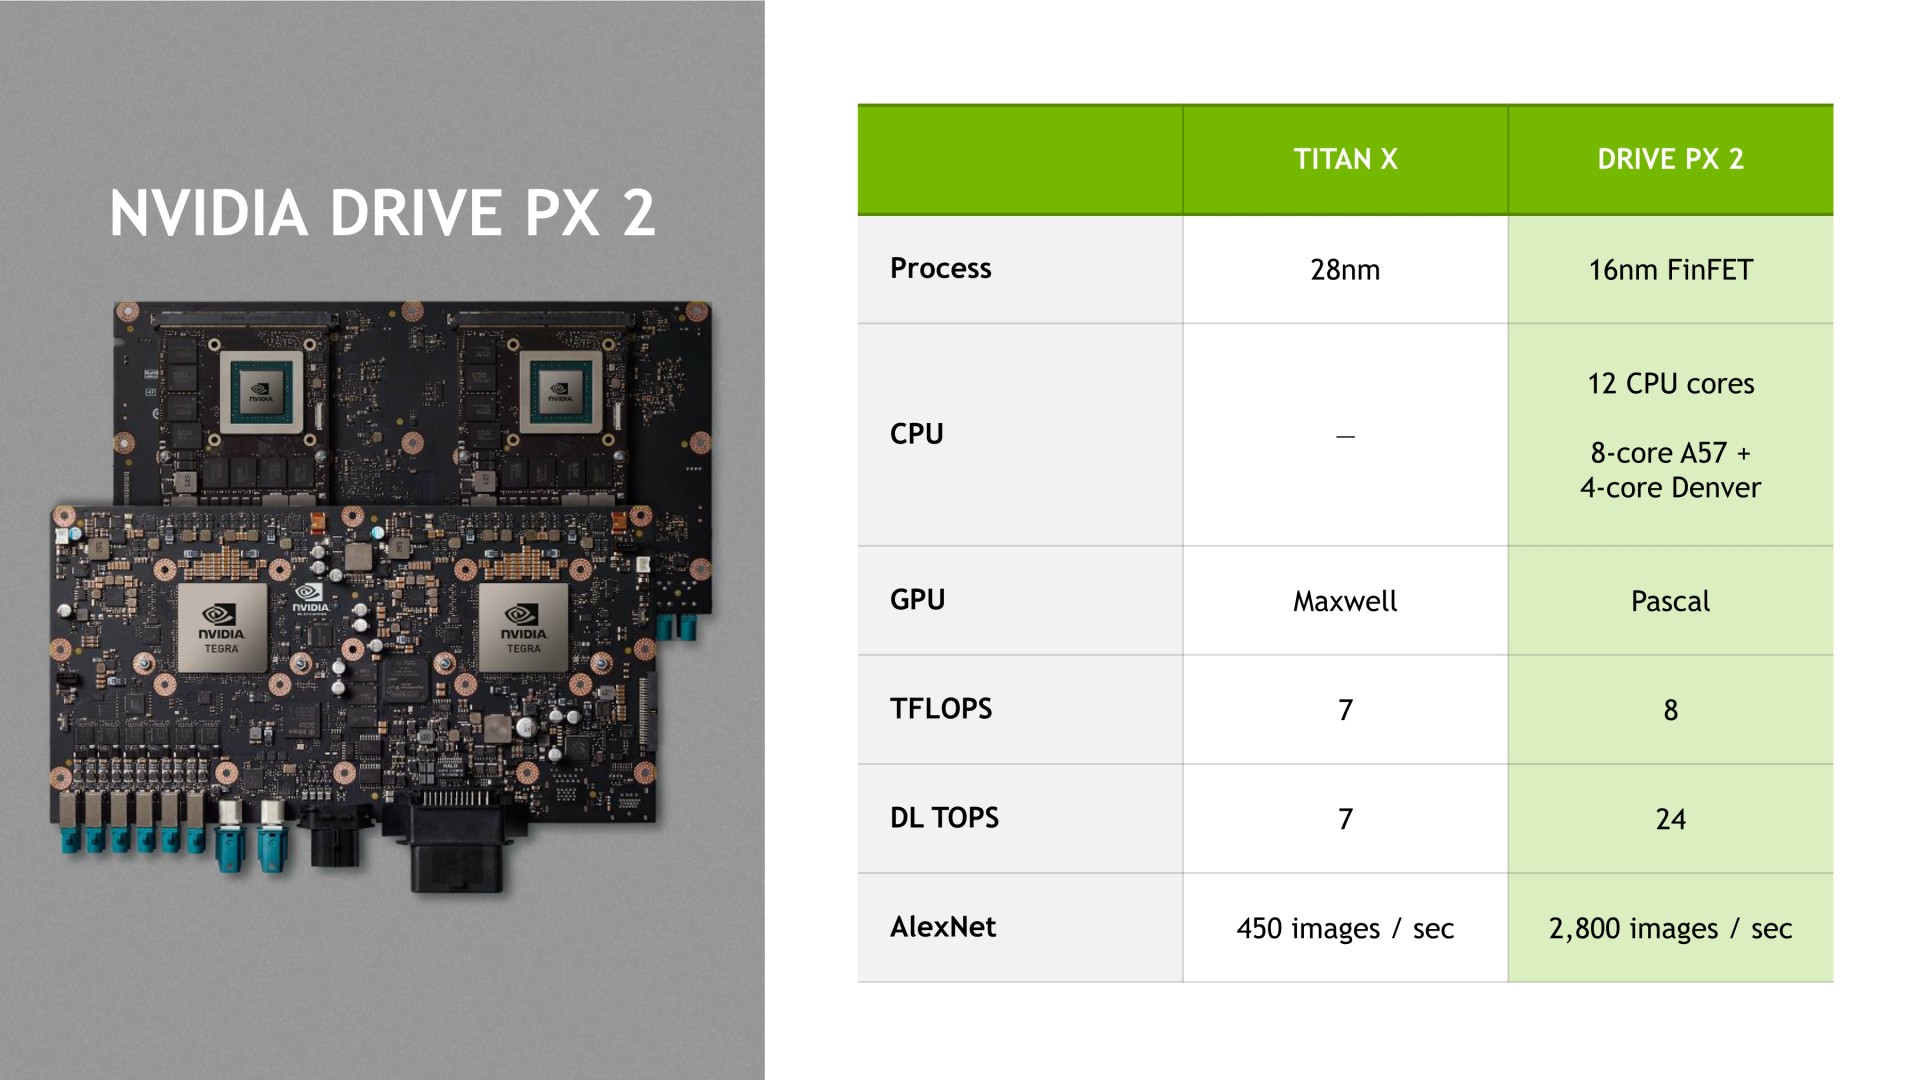
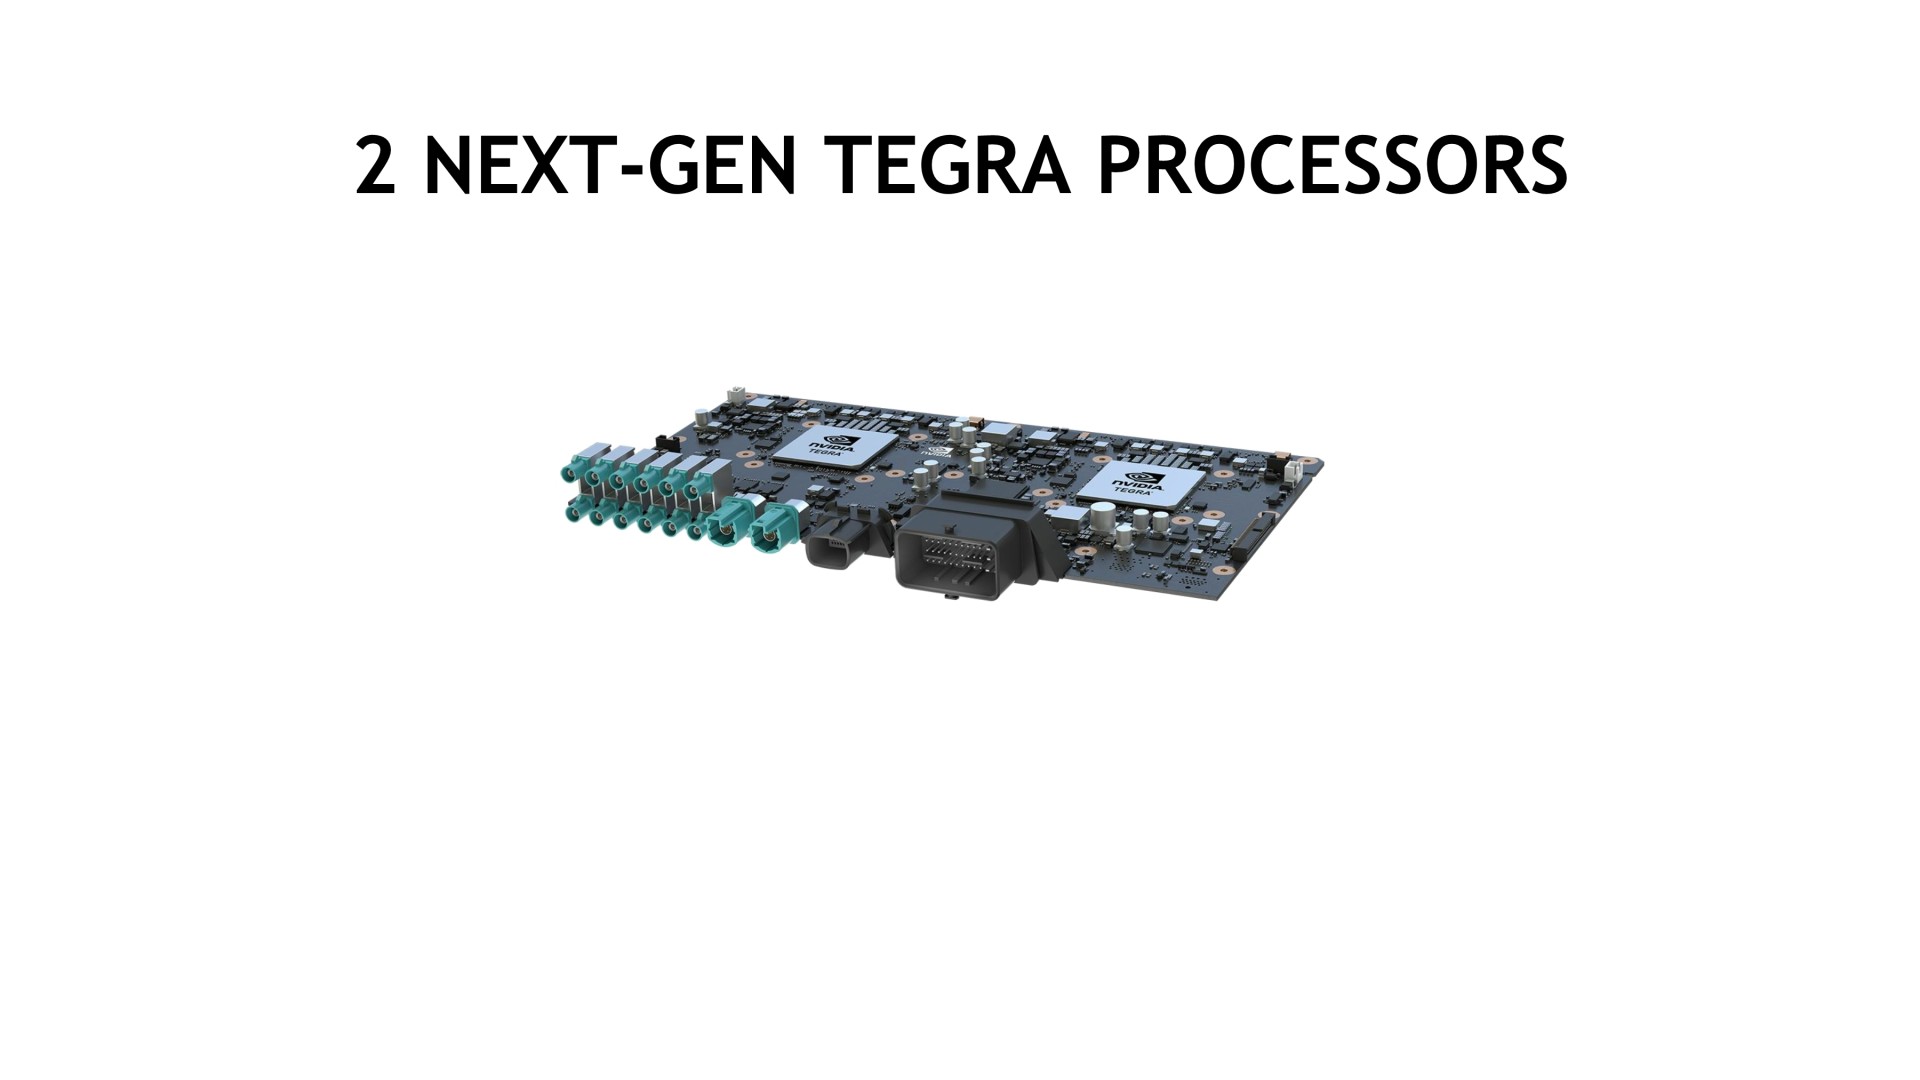
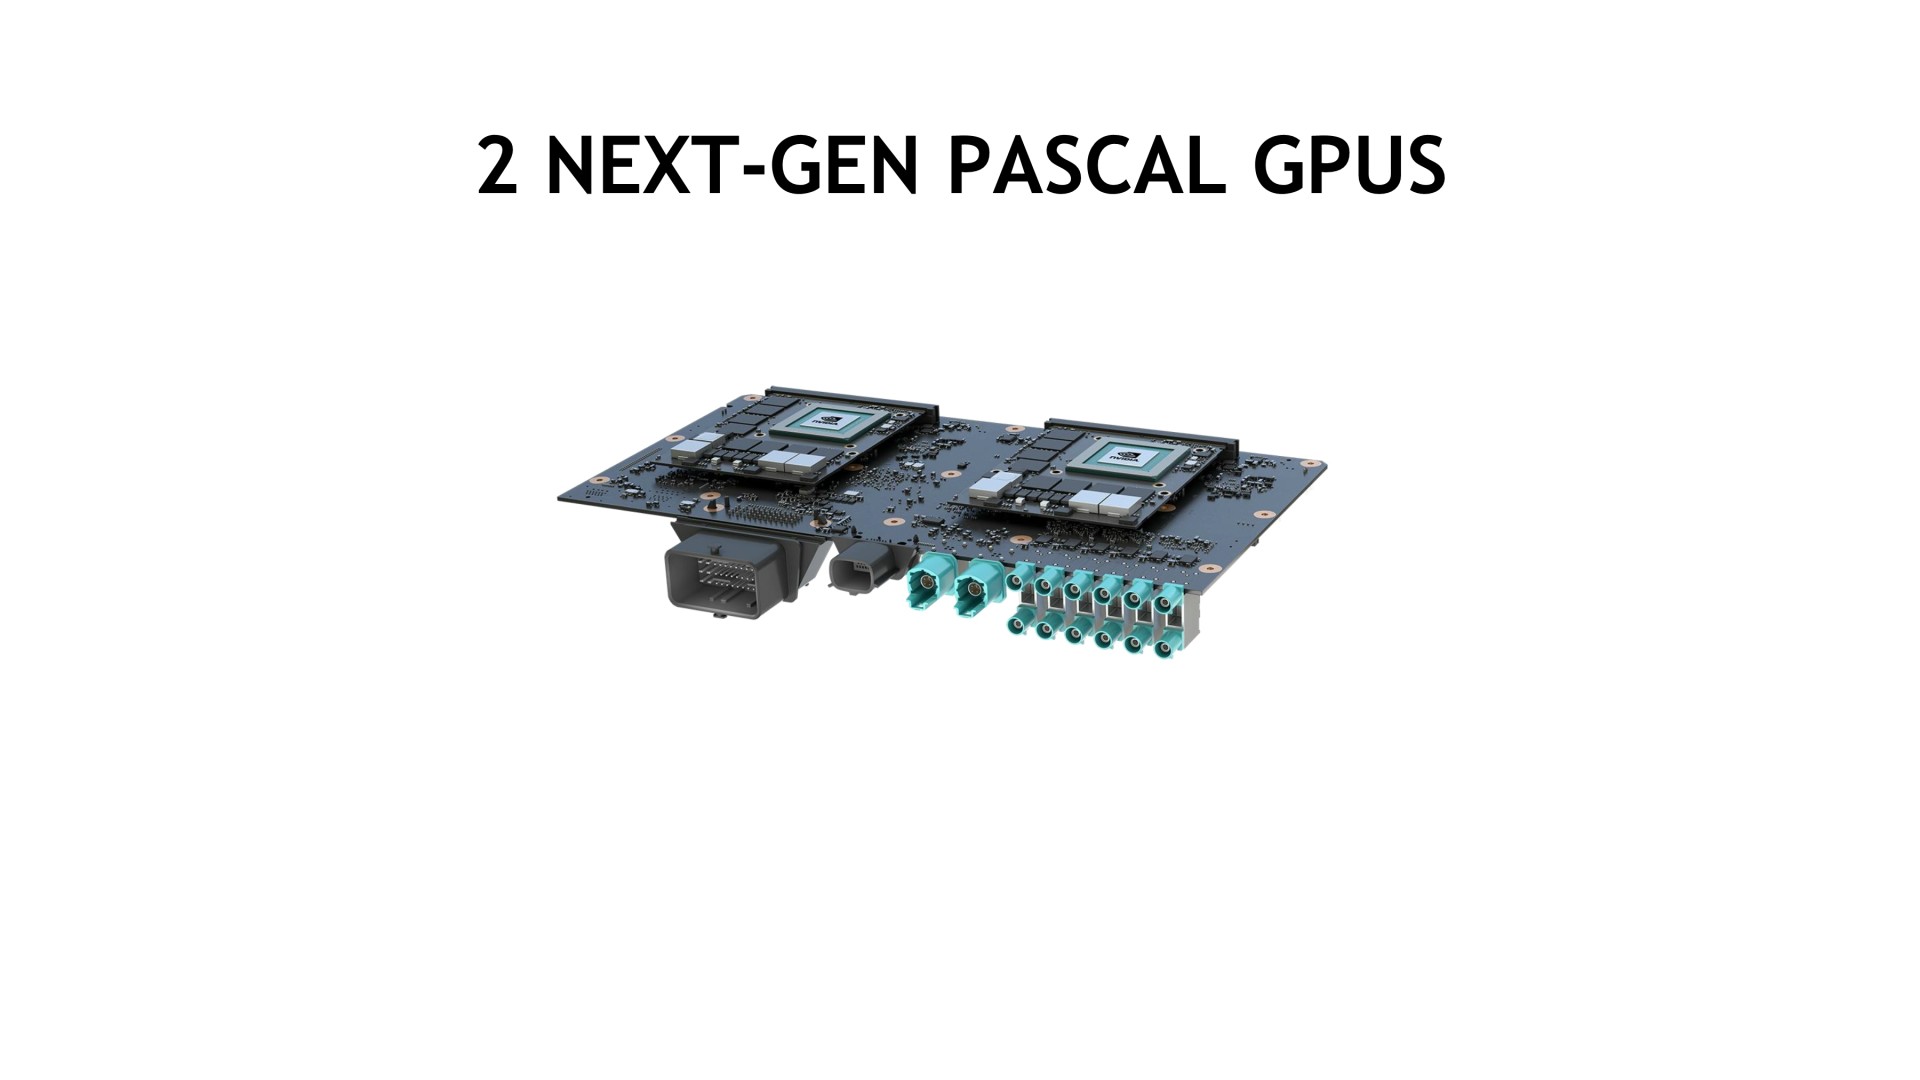
Pour Drive PX 2, Nvidia va toujours faire appel à 2 SoC Tegra mais d'une part il s'agira de SoC plus musclés et d'autre part ils seront accompagnés de 2 GPU dédiés ! Ces SoC seront fabriqués en 16nm FinFET et chacun équipés de 2 cœurs CPU Denver maison, de 4 cœurs Cortex-A57 et d'un GPU non précisé, qui ne sera peut-être pas exploité ici. Il est possible que ce SoC soit en fait celui qui était présenté depuis deux ans sous le nom de code Parker et qui serait donc équipé d'un GPU Maxwell.
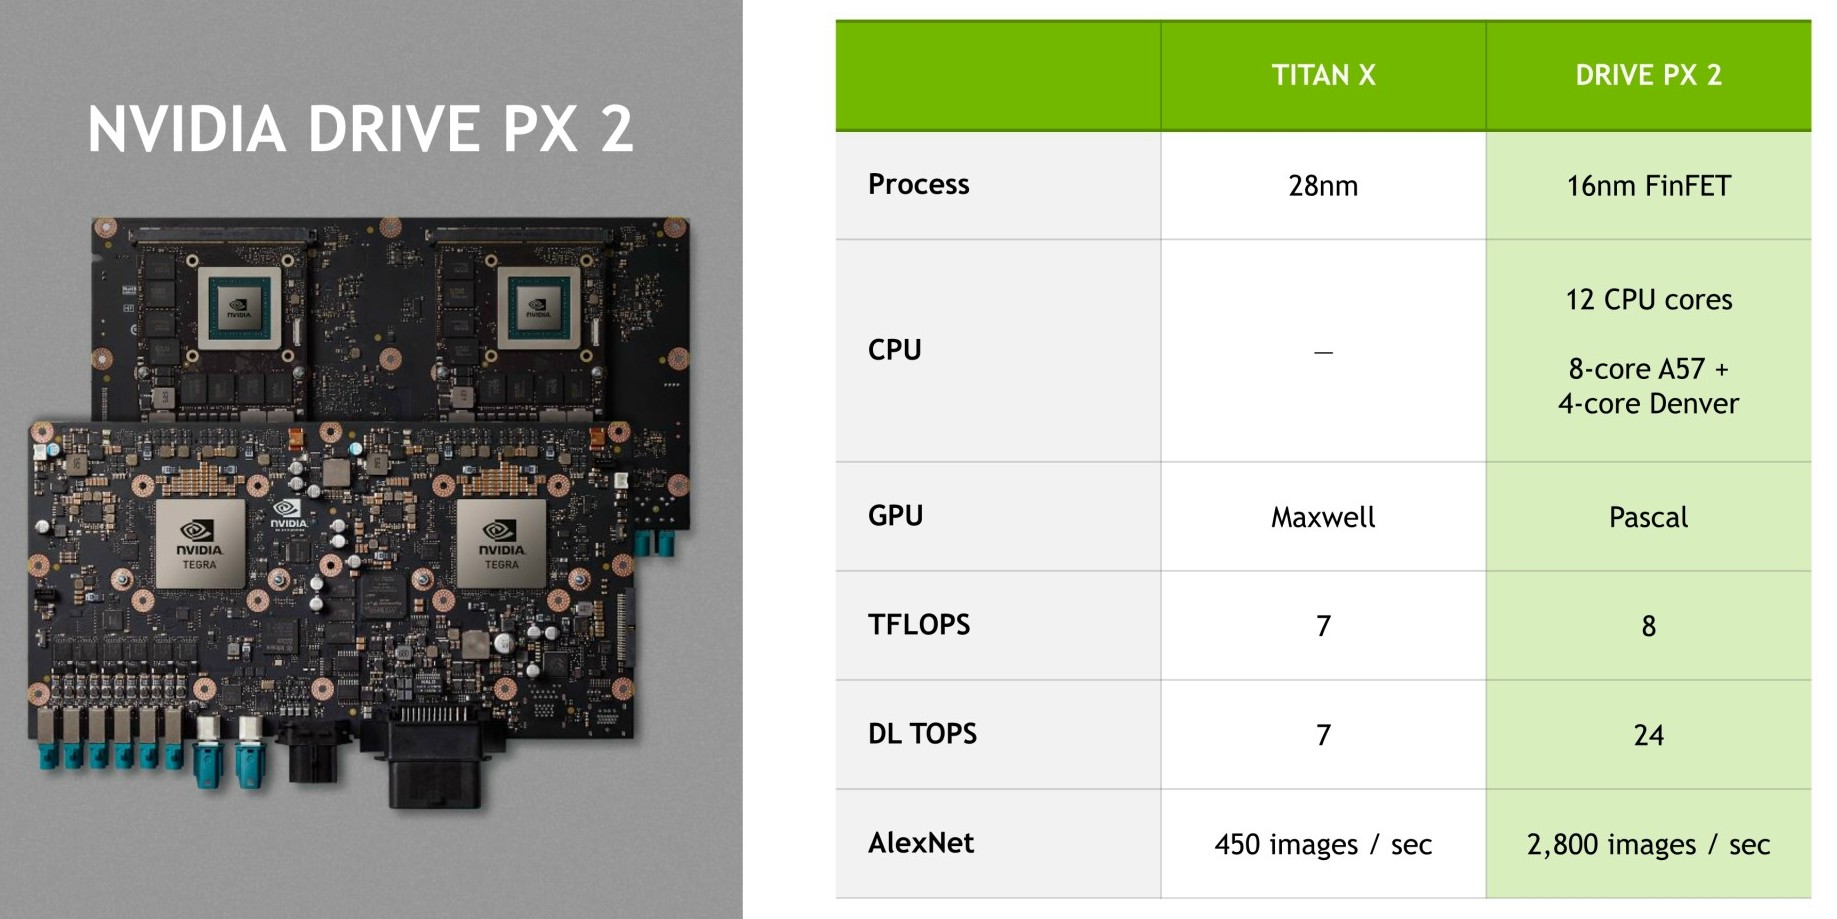
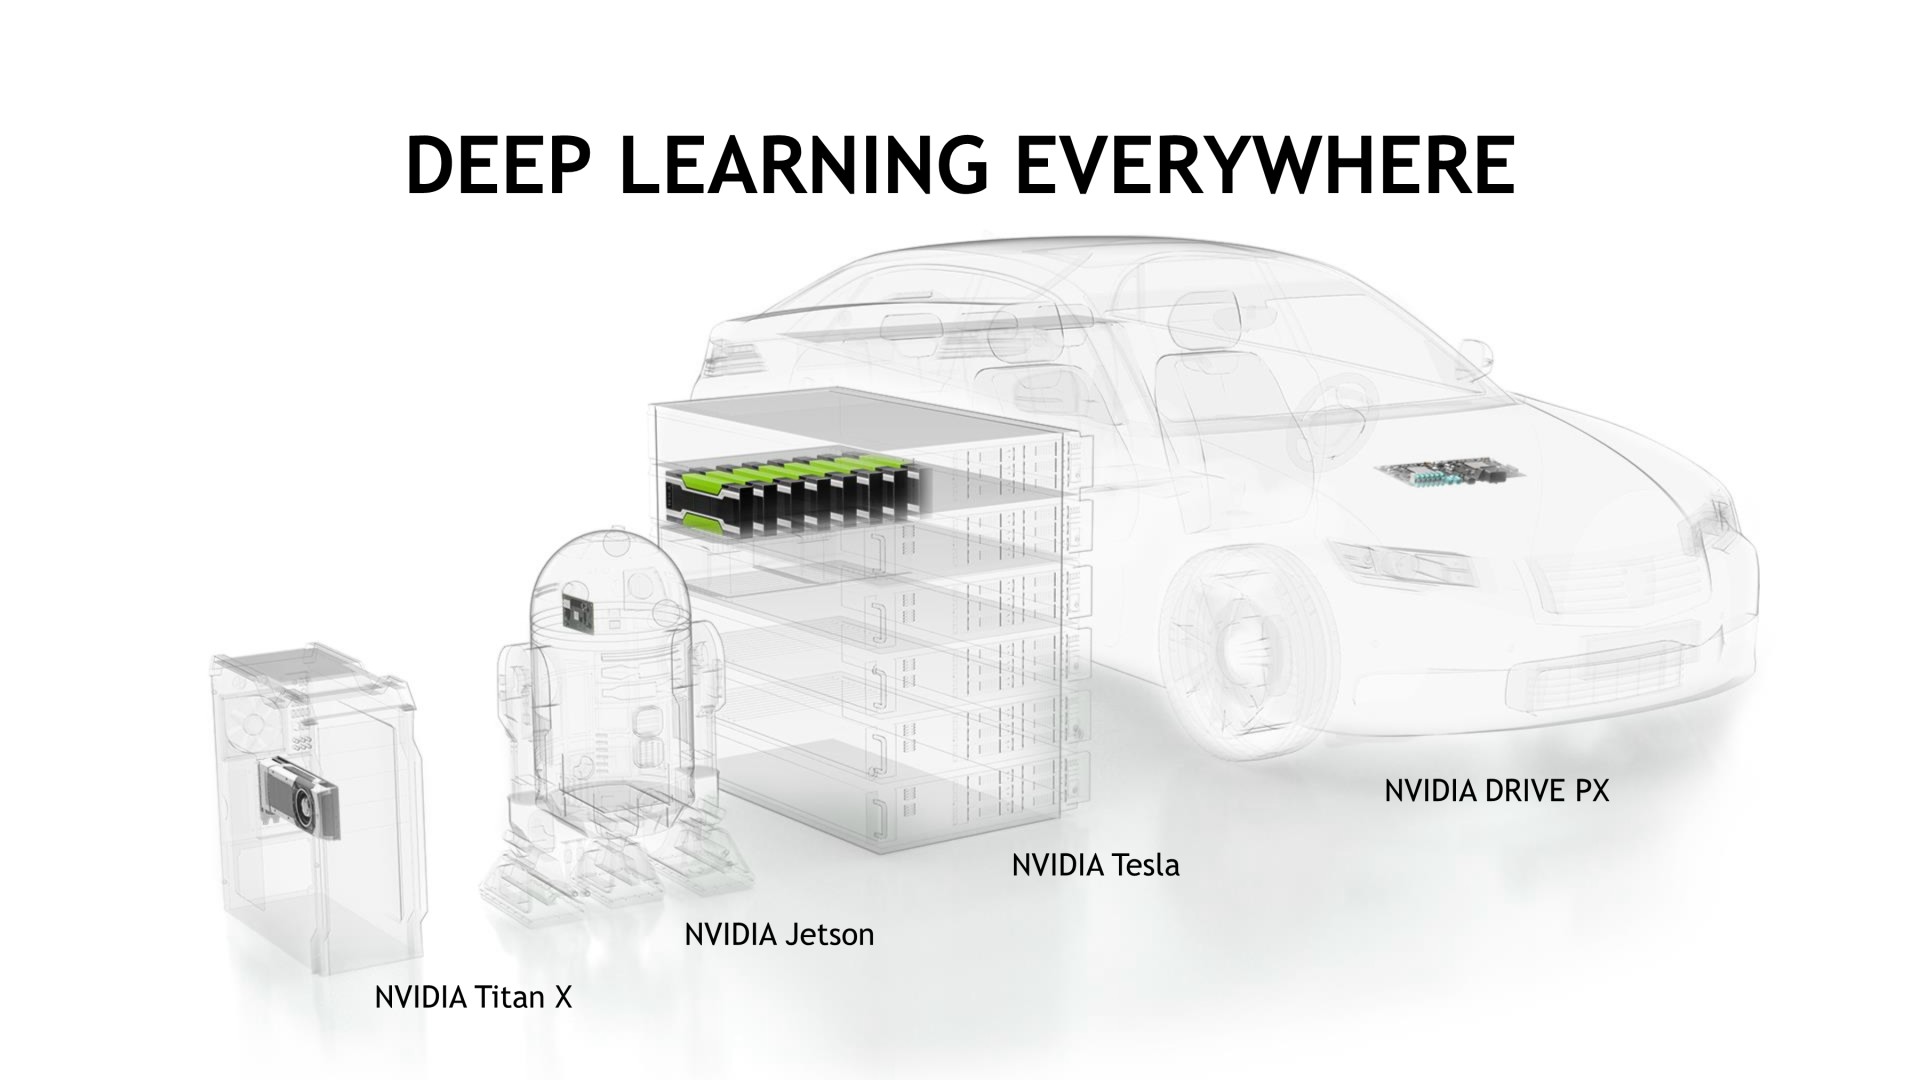
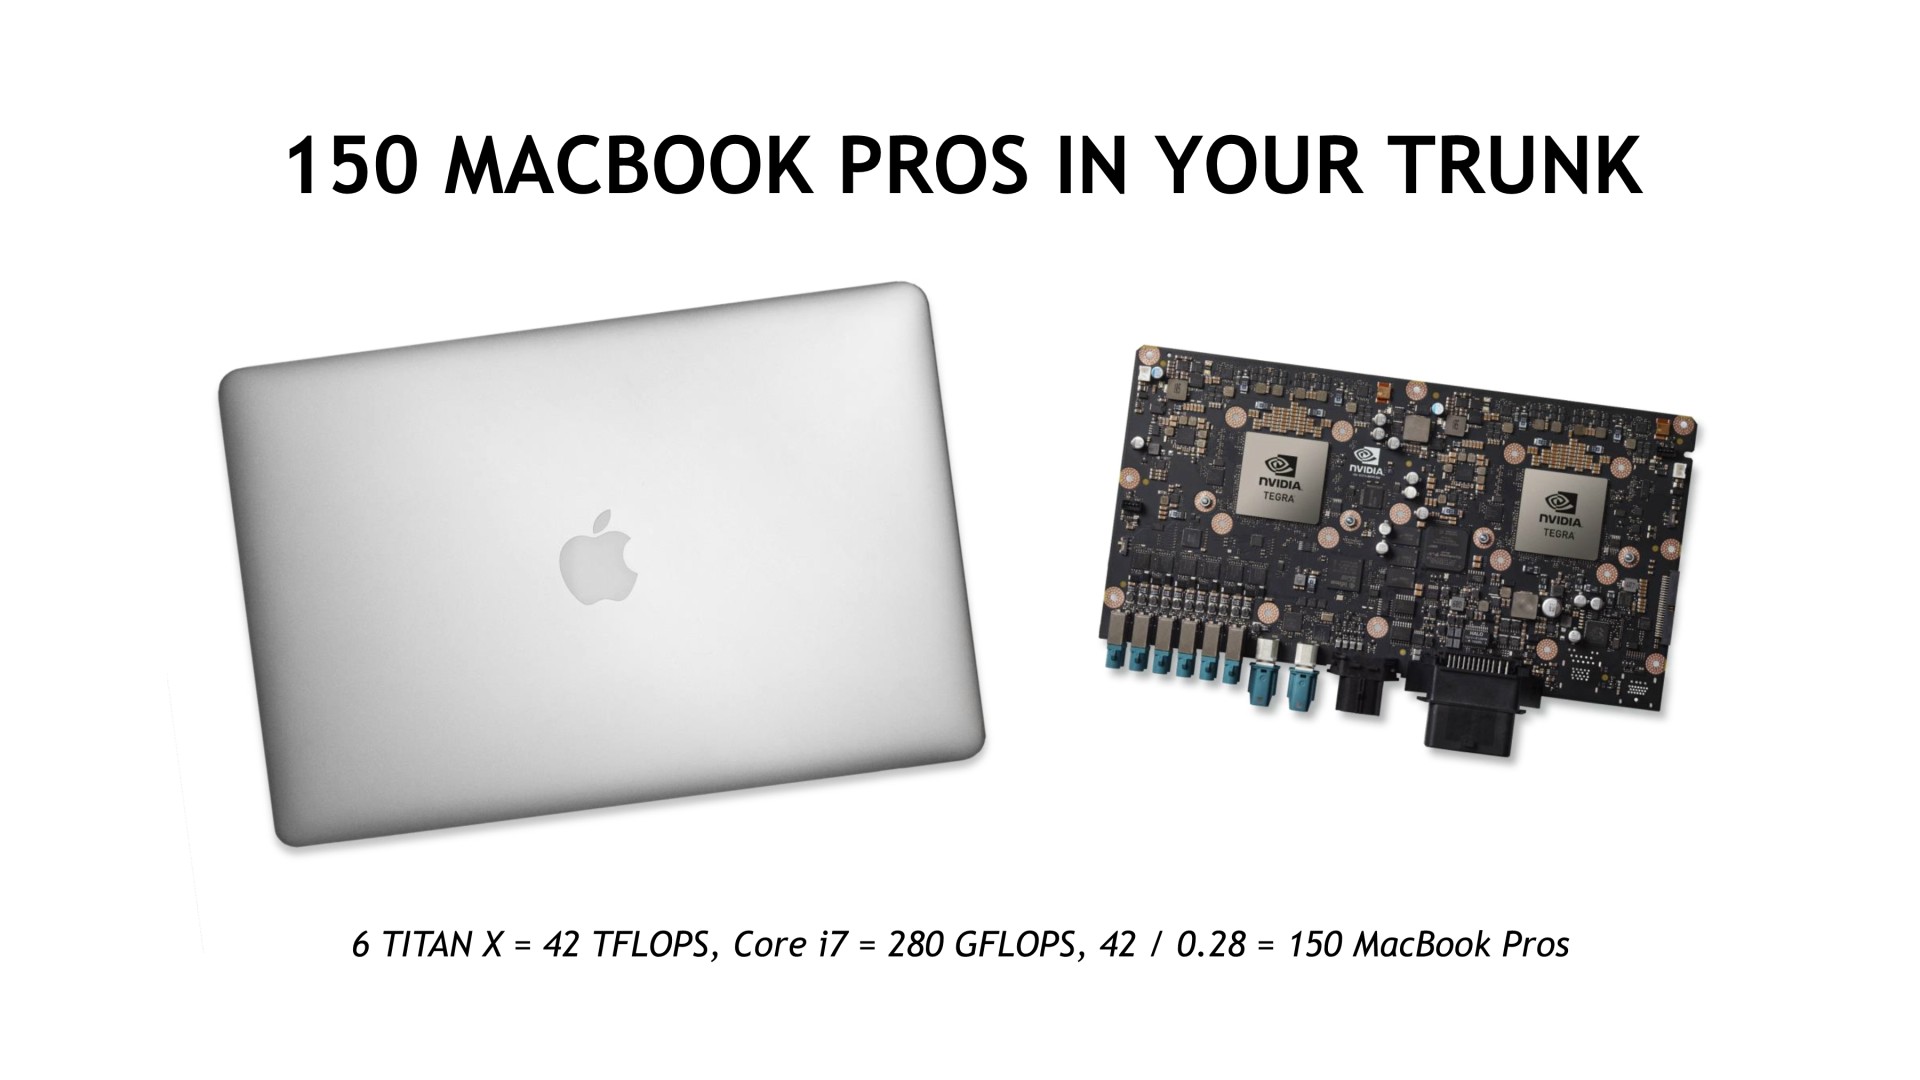
Chacun de ces SoC sera connecté à un GPU de génération Pascal, également fabriqué en 16nm FinFET. Nvidia n'en communique pas les spécifications mais se contente de parler d'une puissance de calcul de 4 Tflops ce qui correspond à peu près à une GeForce GTX 970 et à un ensemble supérieur à la puissance de calcul d'une GTX Titan X. Et ce n'est pas tout, Nvidia annonce ces GPU Pascal comme étant 3x plus rapides dans le cadre du deep learning qu'un GPU Maxwell de puissance de calcul équivalente. Un coup de boost important qui découle probablement en grande partie du support natif des opérations en 16-bit et/ou 8-bit. A noter que les illustrations de Drive PX 2 sont basées sur un prototype équipé de GPU Maxwell GM204, ne cherchez donc pas à déduire de quelconques informations sur les futurs GPU Pascal sur base de ces photos.
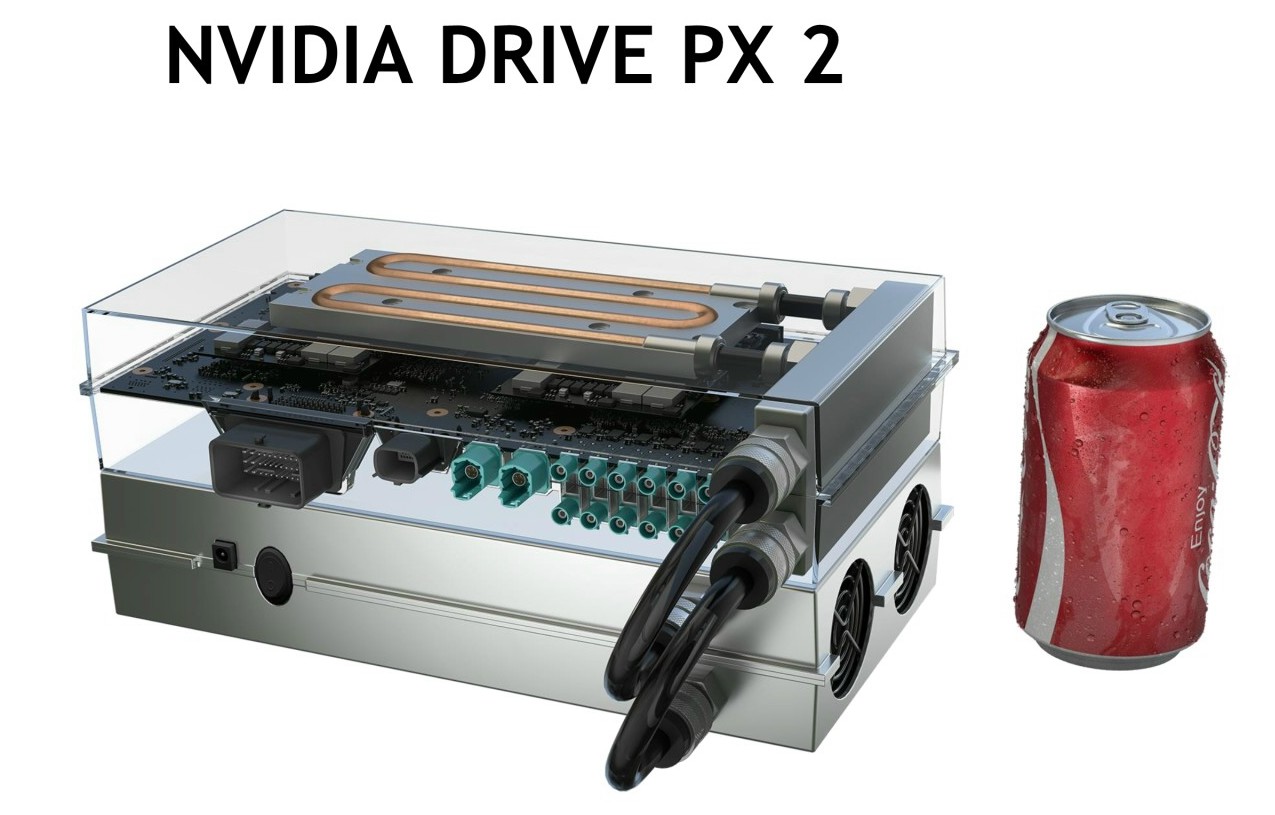
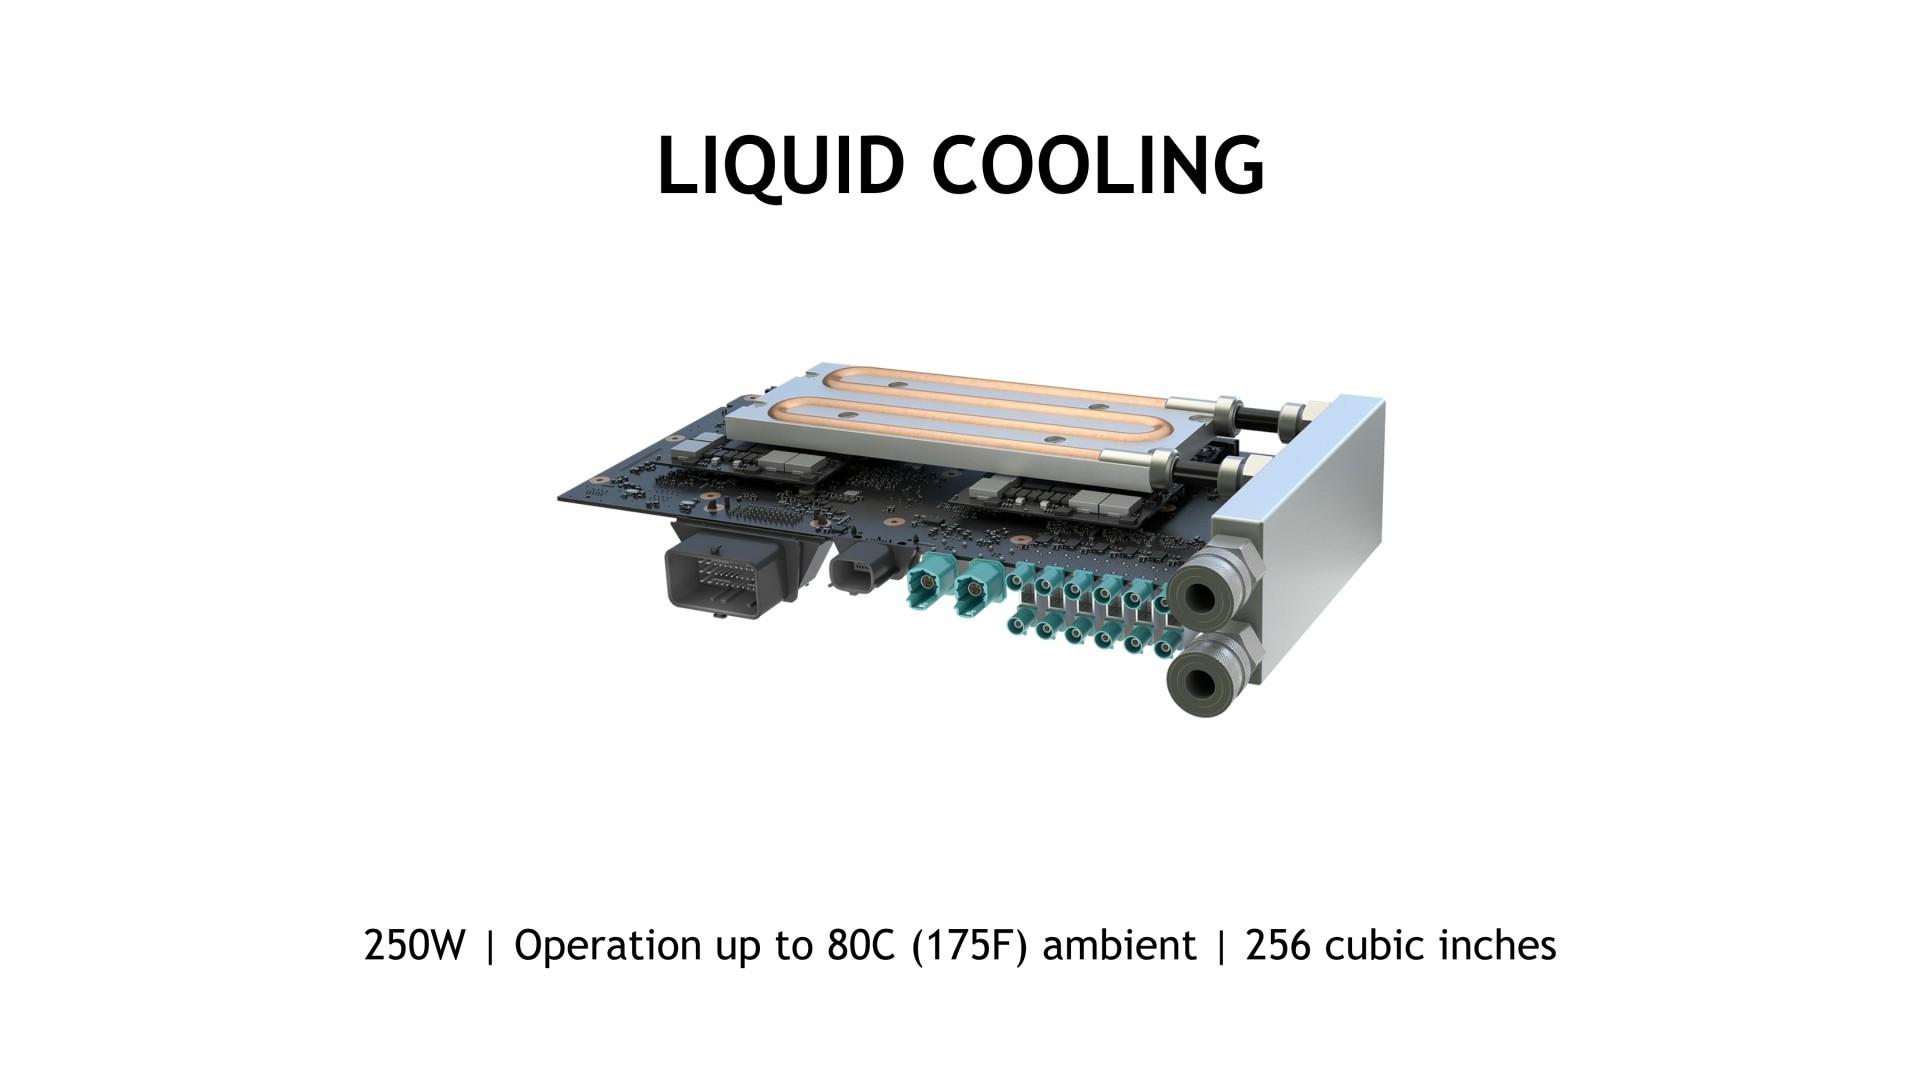
Malgré le recours au 16nm FinFET, l'ensemble sera relativement gourmand et Nvidia parle de 250W. Au passage, nous pouvons ainsi imaginer grossièrement qu'un équivalent Pascal de la GTX 970 verrait sa consommation chuter de 150 à 100W. Pour refroidir l'ensemble, dont la fiabilité doit être garantie en toutes circonstances dans la cadre du pilotage d'une voiture, Nvidia a développé un système de watercooling spécifique mais les éventuels fabricants de voiture intéressés par Drive PX 2 seront bien entendu libres de mettre en place leur propre solution.
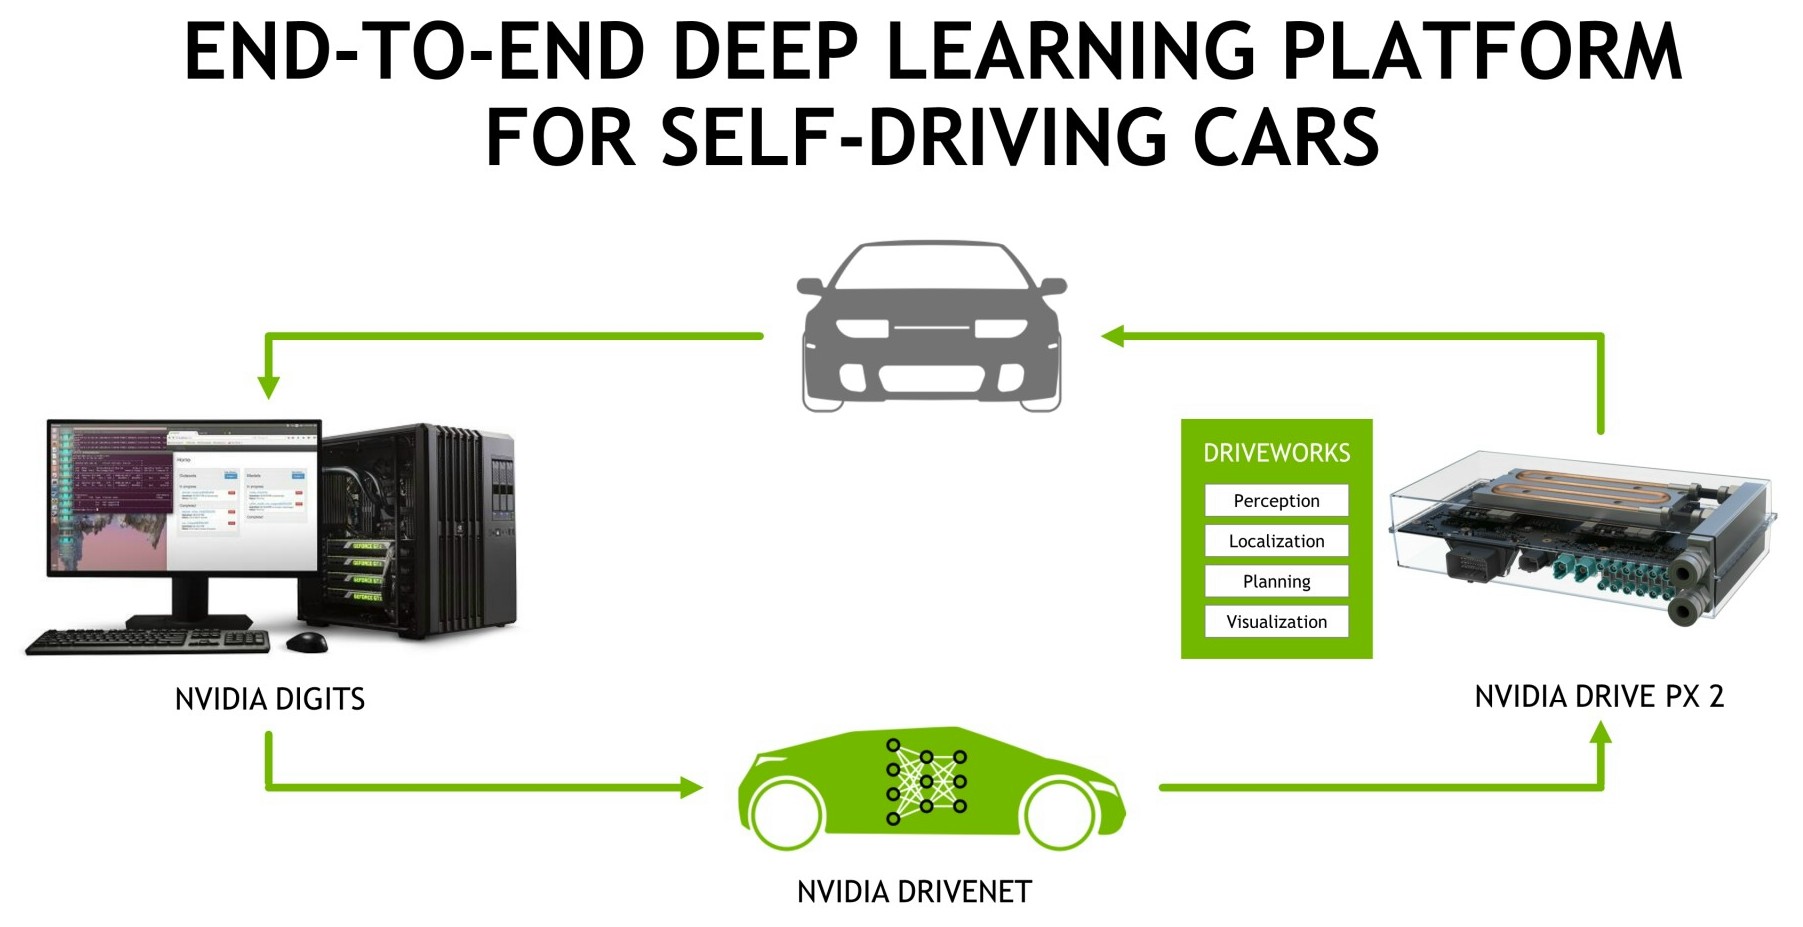
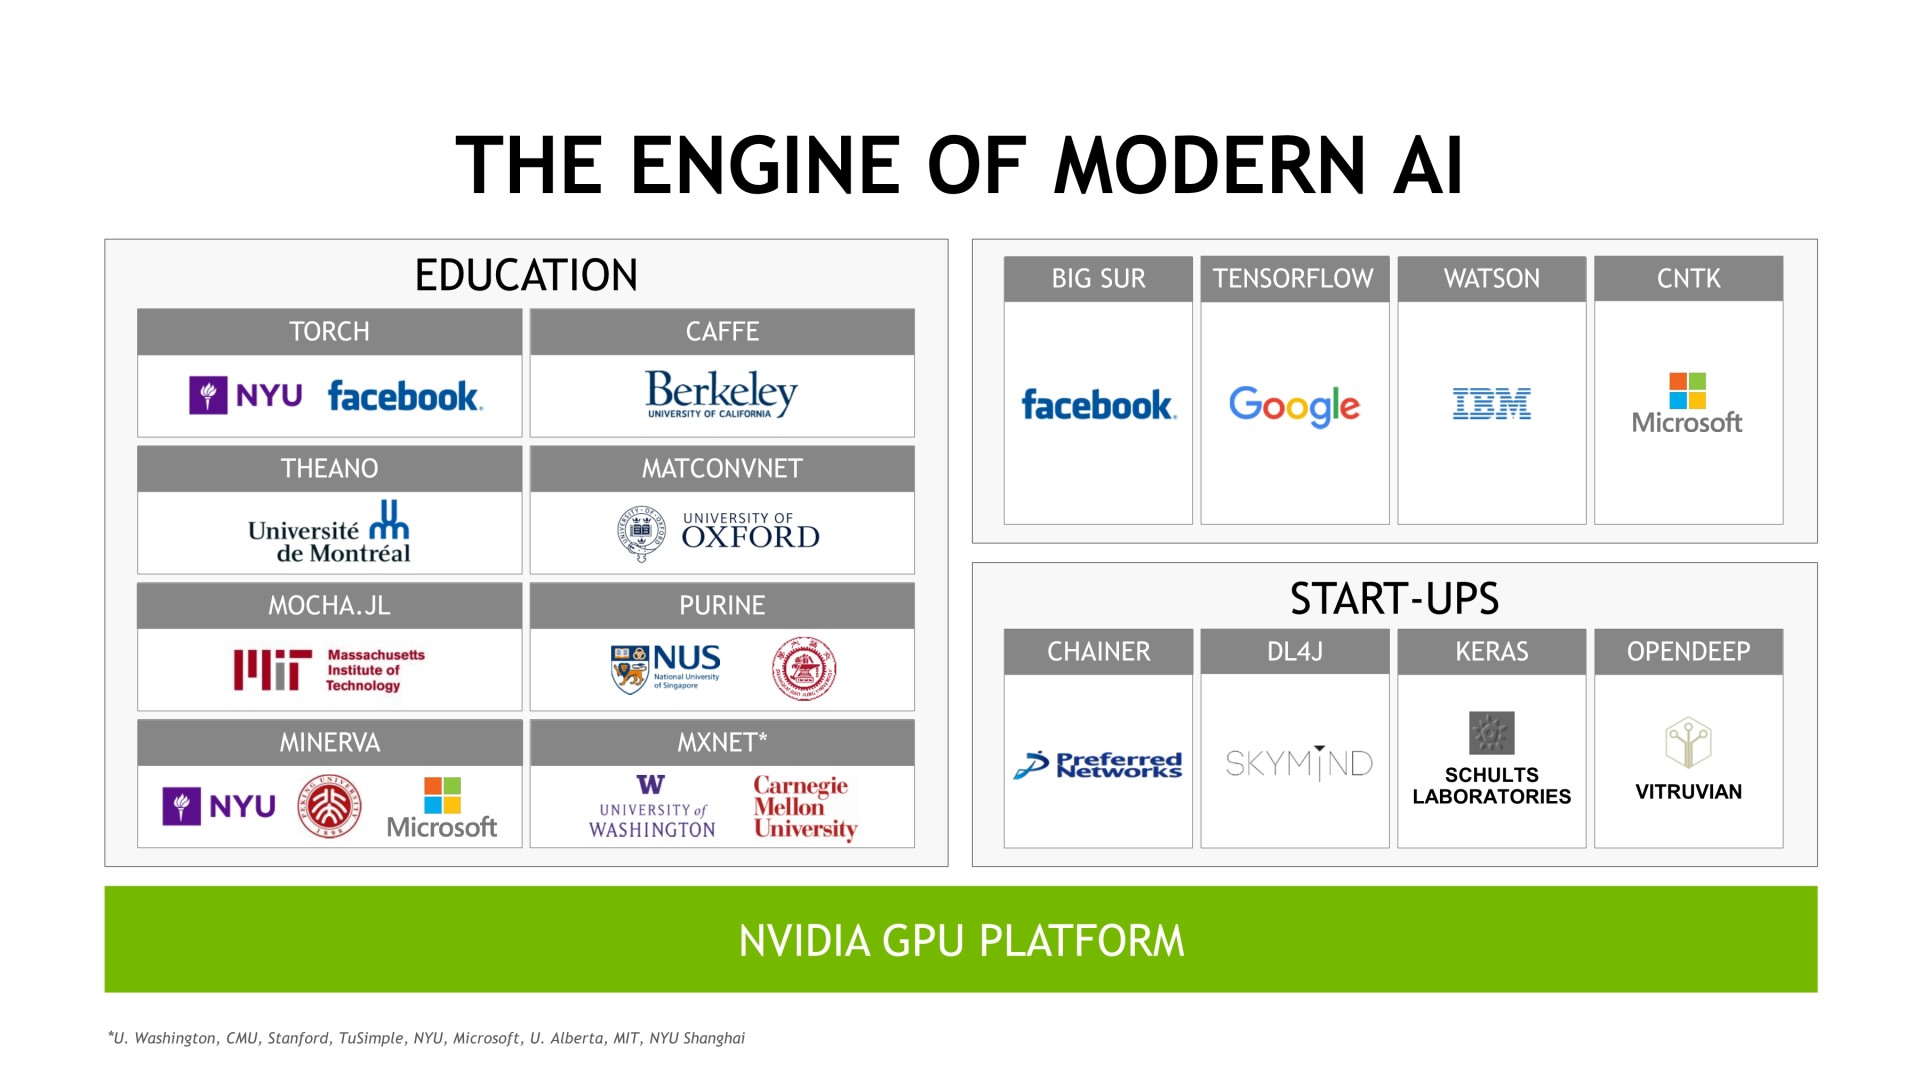
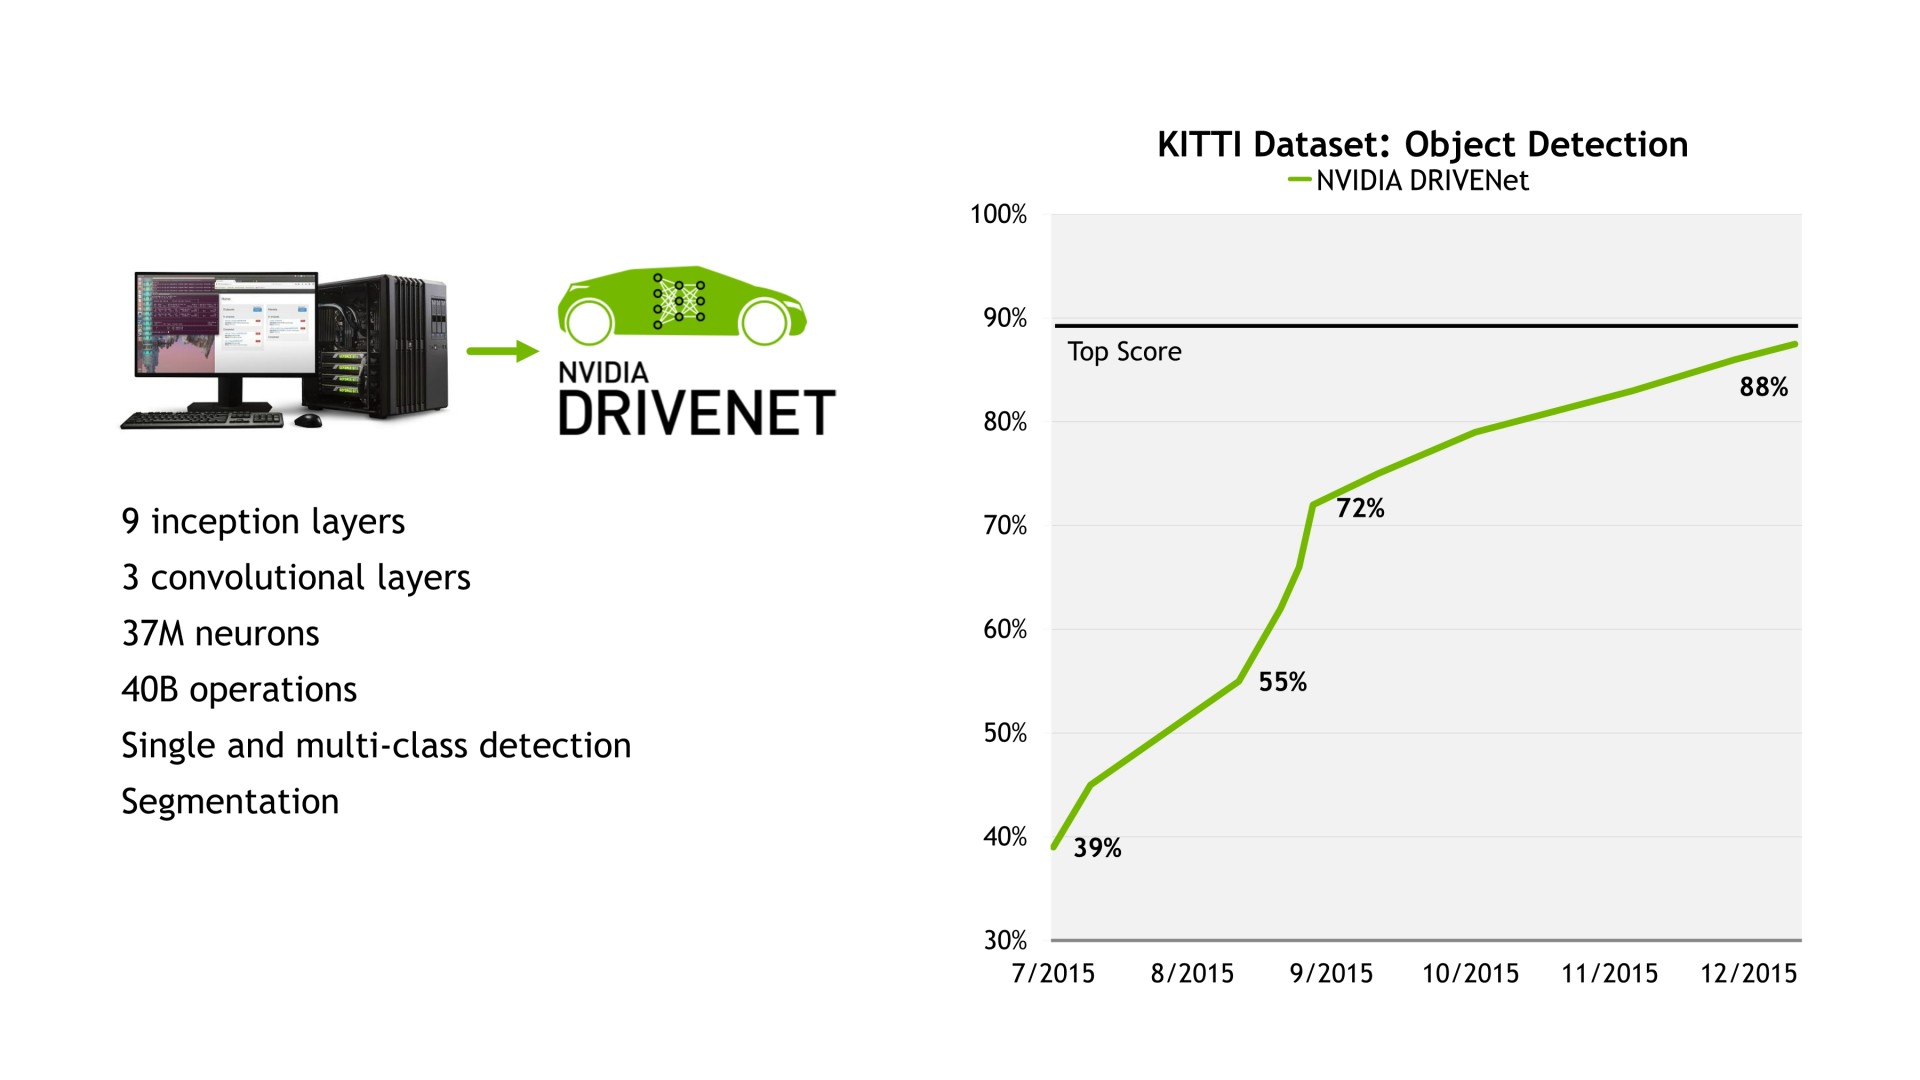
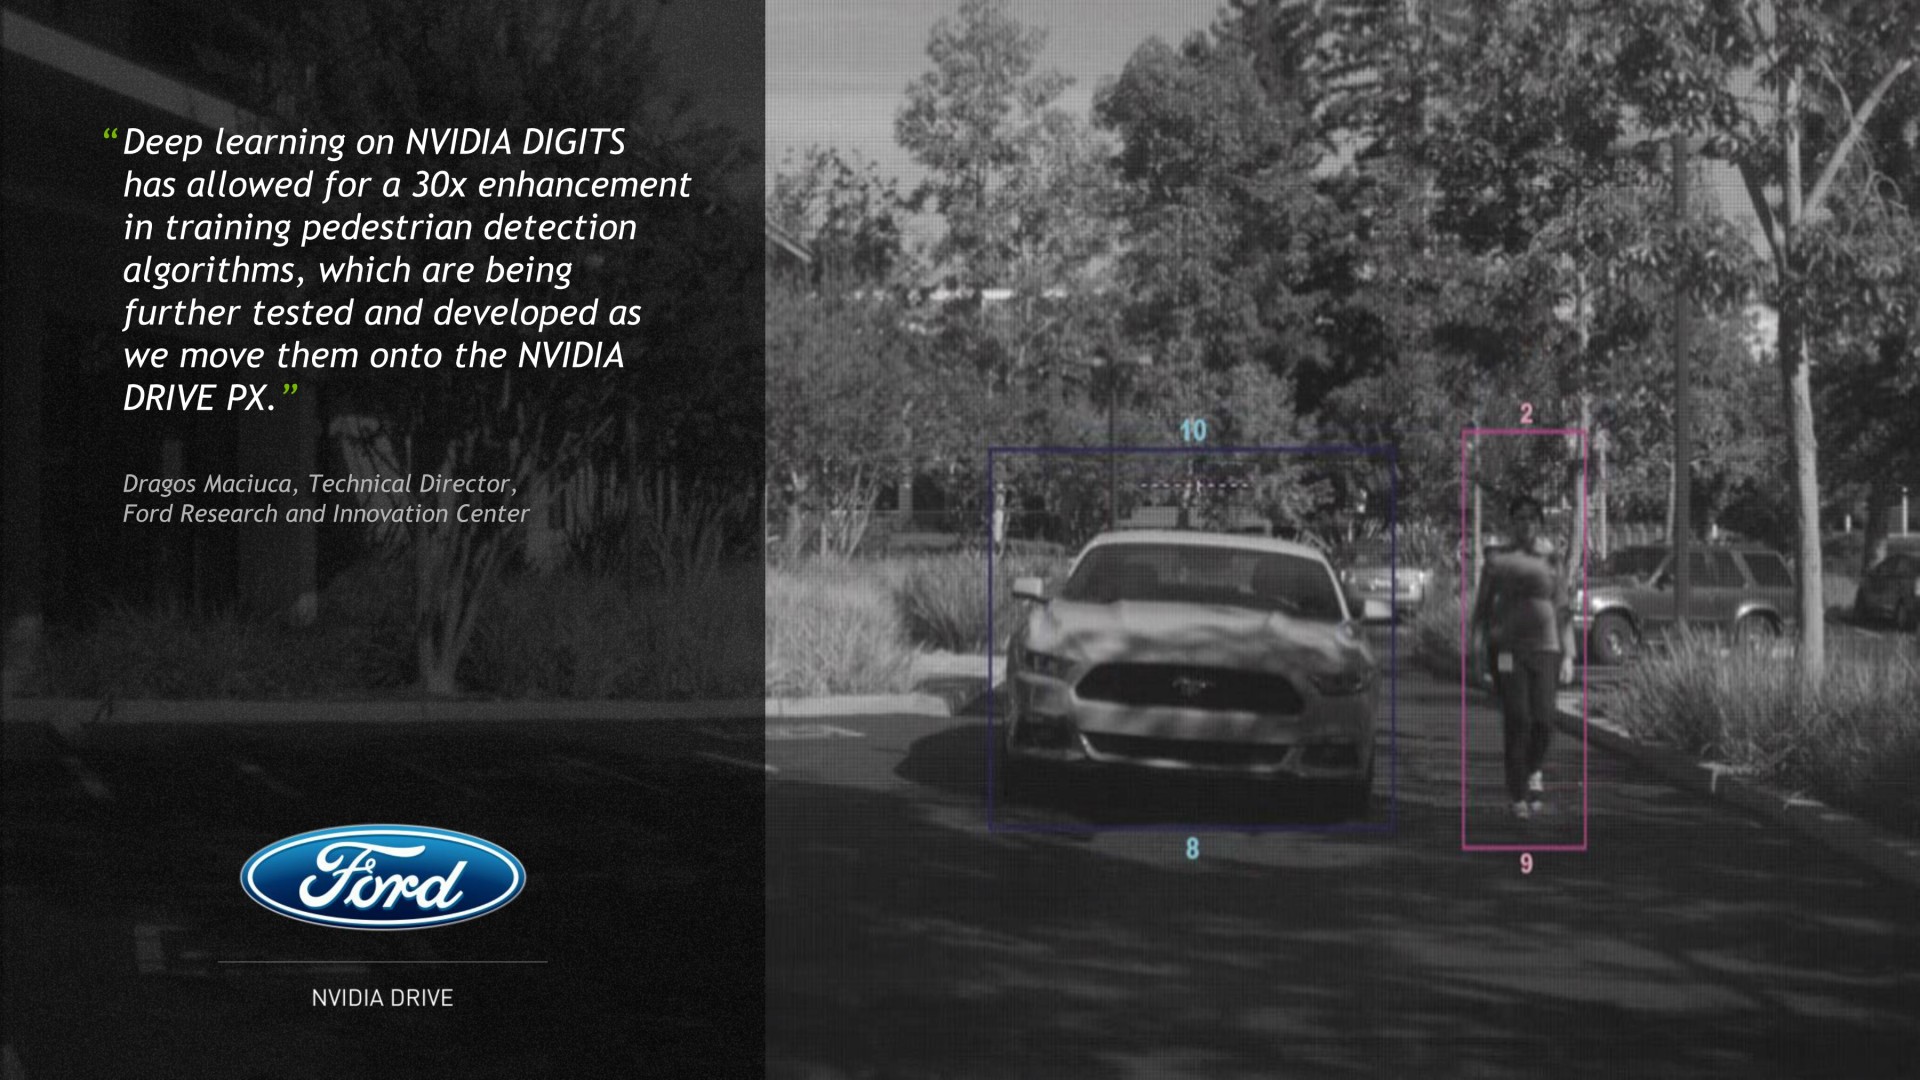
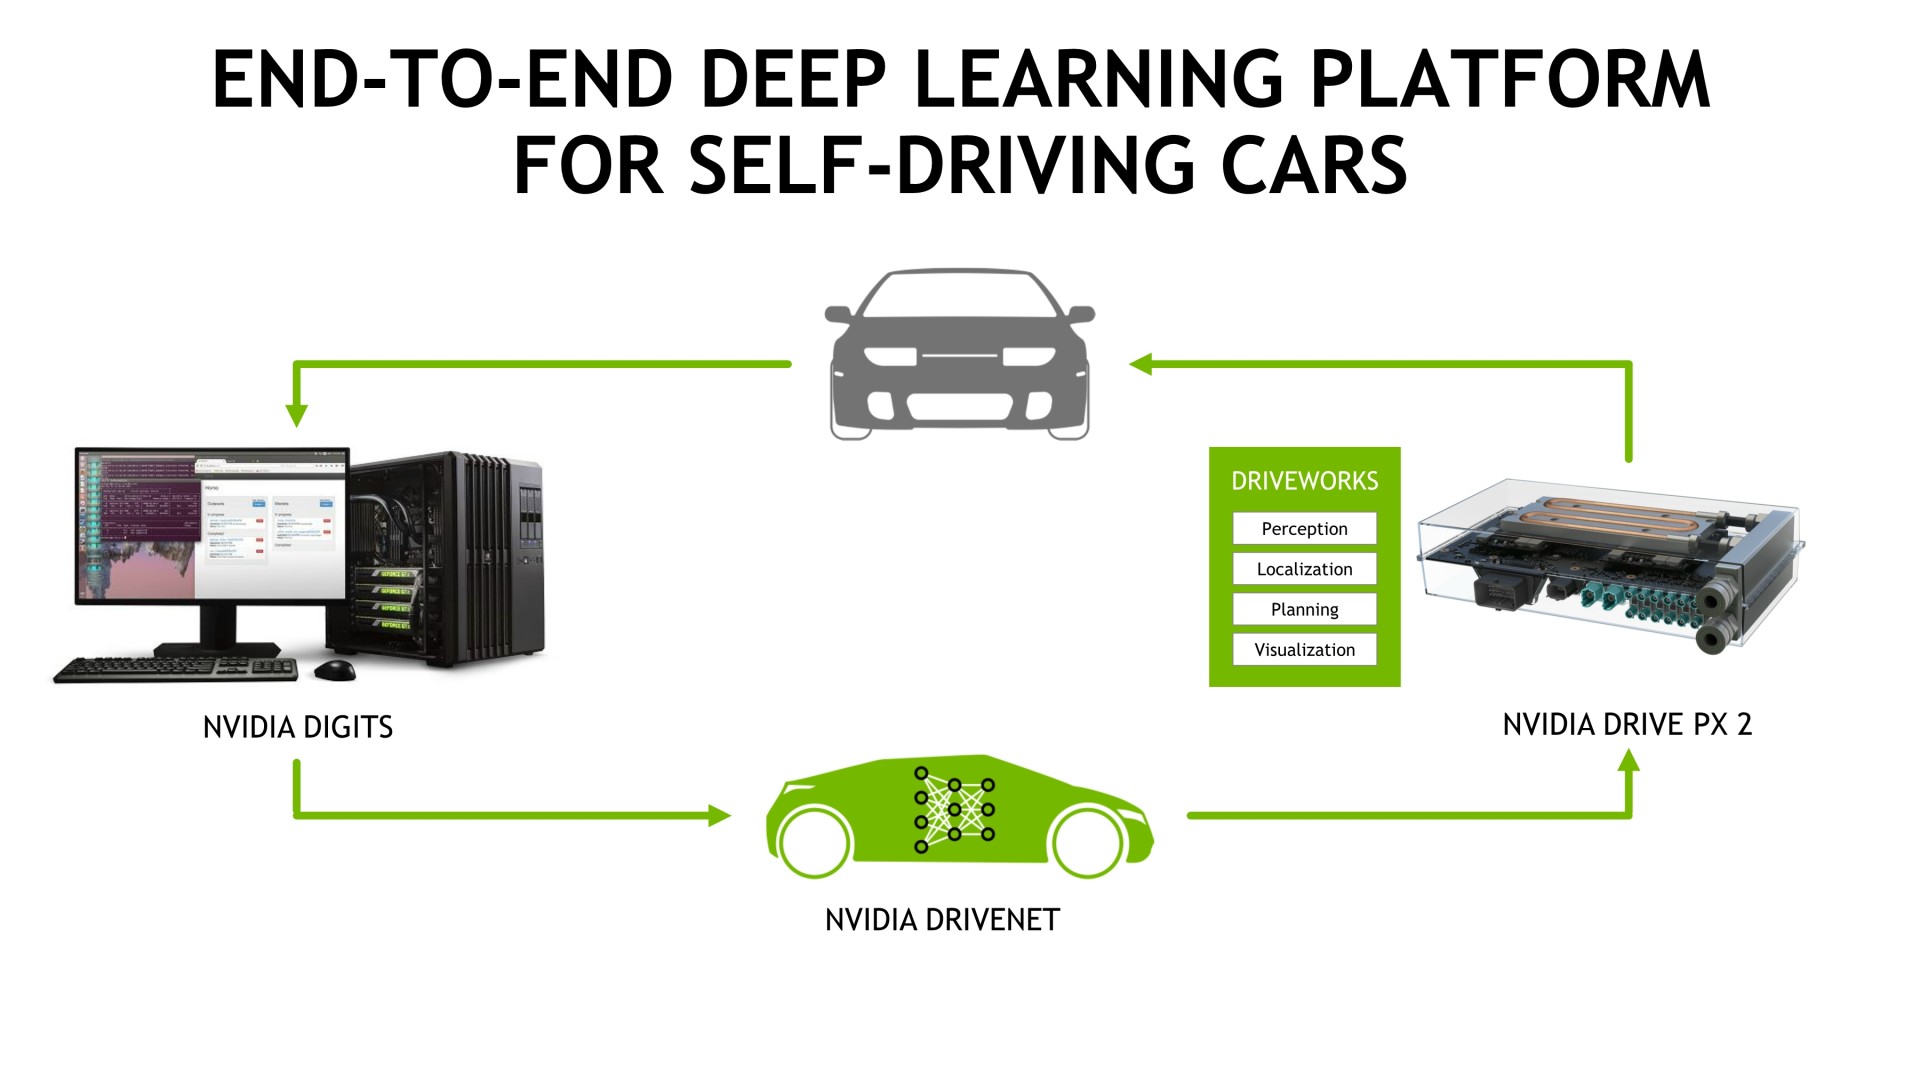
Enfin, pour mieux s'attaquer à ce marché, Nvidia a mis en place un écosystème complet qui passe par DIGITS, sa plateforme de deep learning, et d'autre part par DRIVENET, un réseau neuronal que ses ingénieurs ont commencé à entraîner il y a 6 mois et qui affiche déjà de très bons résultats. Nvidia peut ainsi fournir à des clients potentiels tous les outils nécessaires au développement de leur propre réseau neuronal ou une base déjà totalement fonctionnelle.
Un premier constructeur a déjà annoncé être intéressé par cette solution de Nvidia : Volvo qui intégrera Drive PX 2 en 2017 dans une centaine de voitures autonomes pour une première phase de test. De quoi peut-être permettre à "Drive PX 3" de trouver un succès commercial ?
Vous pourrez retrouver l'intégralité de la présentation de Nvidia ci-dessous :
AMD annonce Polaris, sa future architecture GPU
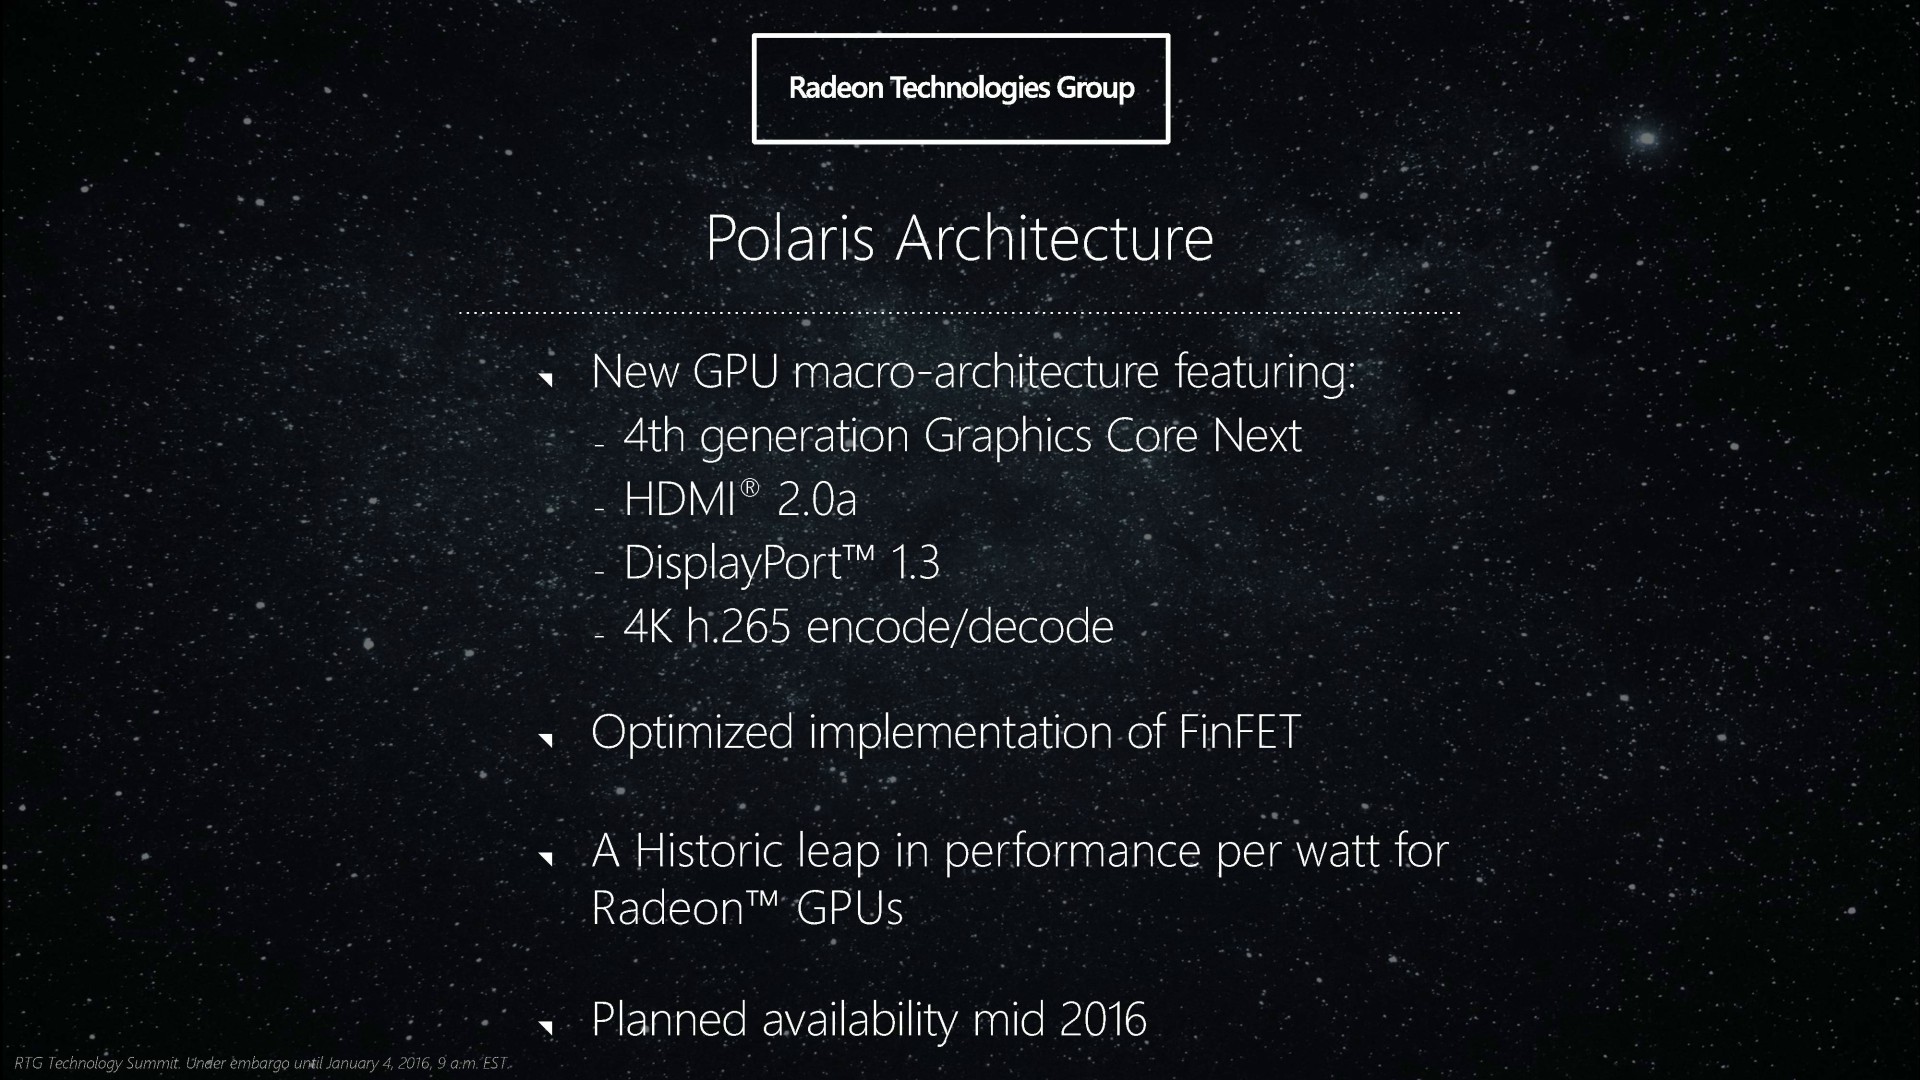
Enfin, après 4 années de GCN en 28nm, les Radeon vont accueillir une nouvelle architecture gravée en 14nm : Polaris. Et pour AMD le focus se portera sur l'efficacité énergétique avec un bond en avant annoncé sans précédent !
Le Radeon Technology Group d'AMD profite de ce début d'année pour lever un (très petit) coin du voile qui entoure sa prochaine génération de GPU, notamment en donnant un nom de code à son architecture : Polaris (l'étoile polaire). Et pour positionner sans équivoque ses objectifs avec cette architecture, AMD explique avoir opté pour ce nom de code en faisant le parallèle entre l'efficacité des étoiles à générer des photons et l'efficacité demandée aux GPU pour générer des pixels.
Comme vous le savez, l'architecture actuelle des Radeon est globalement en retrait par rapport à l'architecture Maxwell de Nvidia au niveau de l'efficacité énergétique. Fort de larges parts de marché et ayant bien anticipé le très long passage par le procédé de fabrication 28nm (exploité pour les GPU depuis 4 ans déjà !), Nvidia a développé deux architectures pour celui-ci : Kepler et Maxwell. En face, AMD est resté sur une architecture GCN moins efficace en se contentant d'évolutions mineures de son cœur. Pourquoi ? Probablement parce que, contrairement à Nvidia, AMD avait parié sur l'exploitation d'un procédé en 20nm qui ne s'est jamais concrétisée pour les GPU.
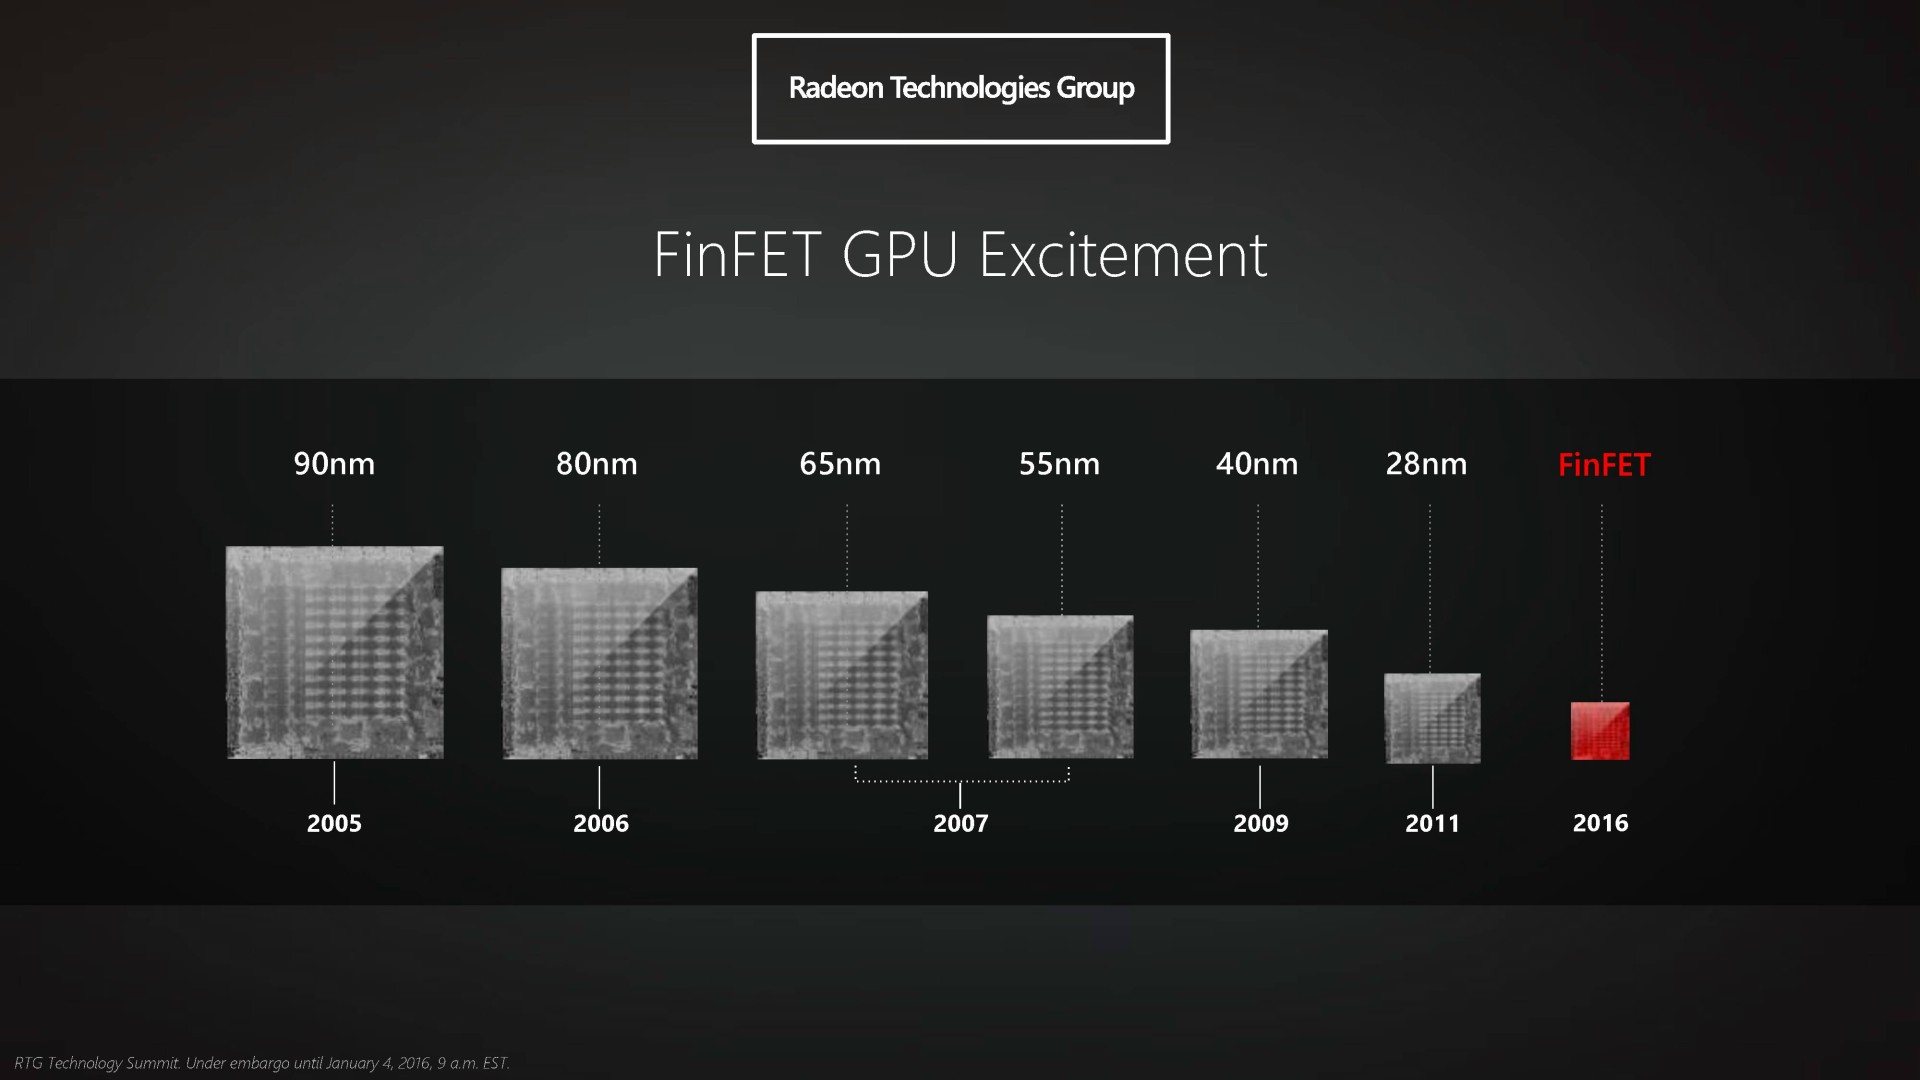
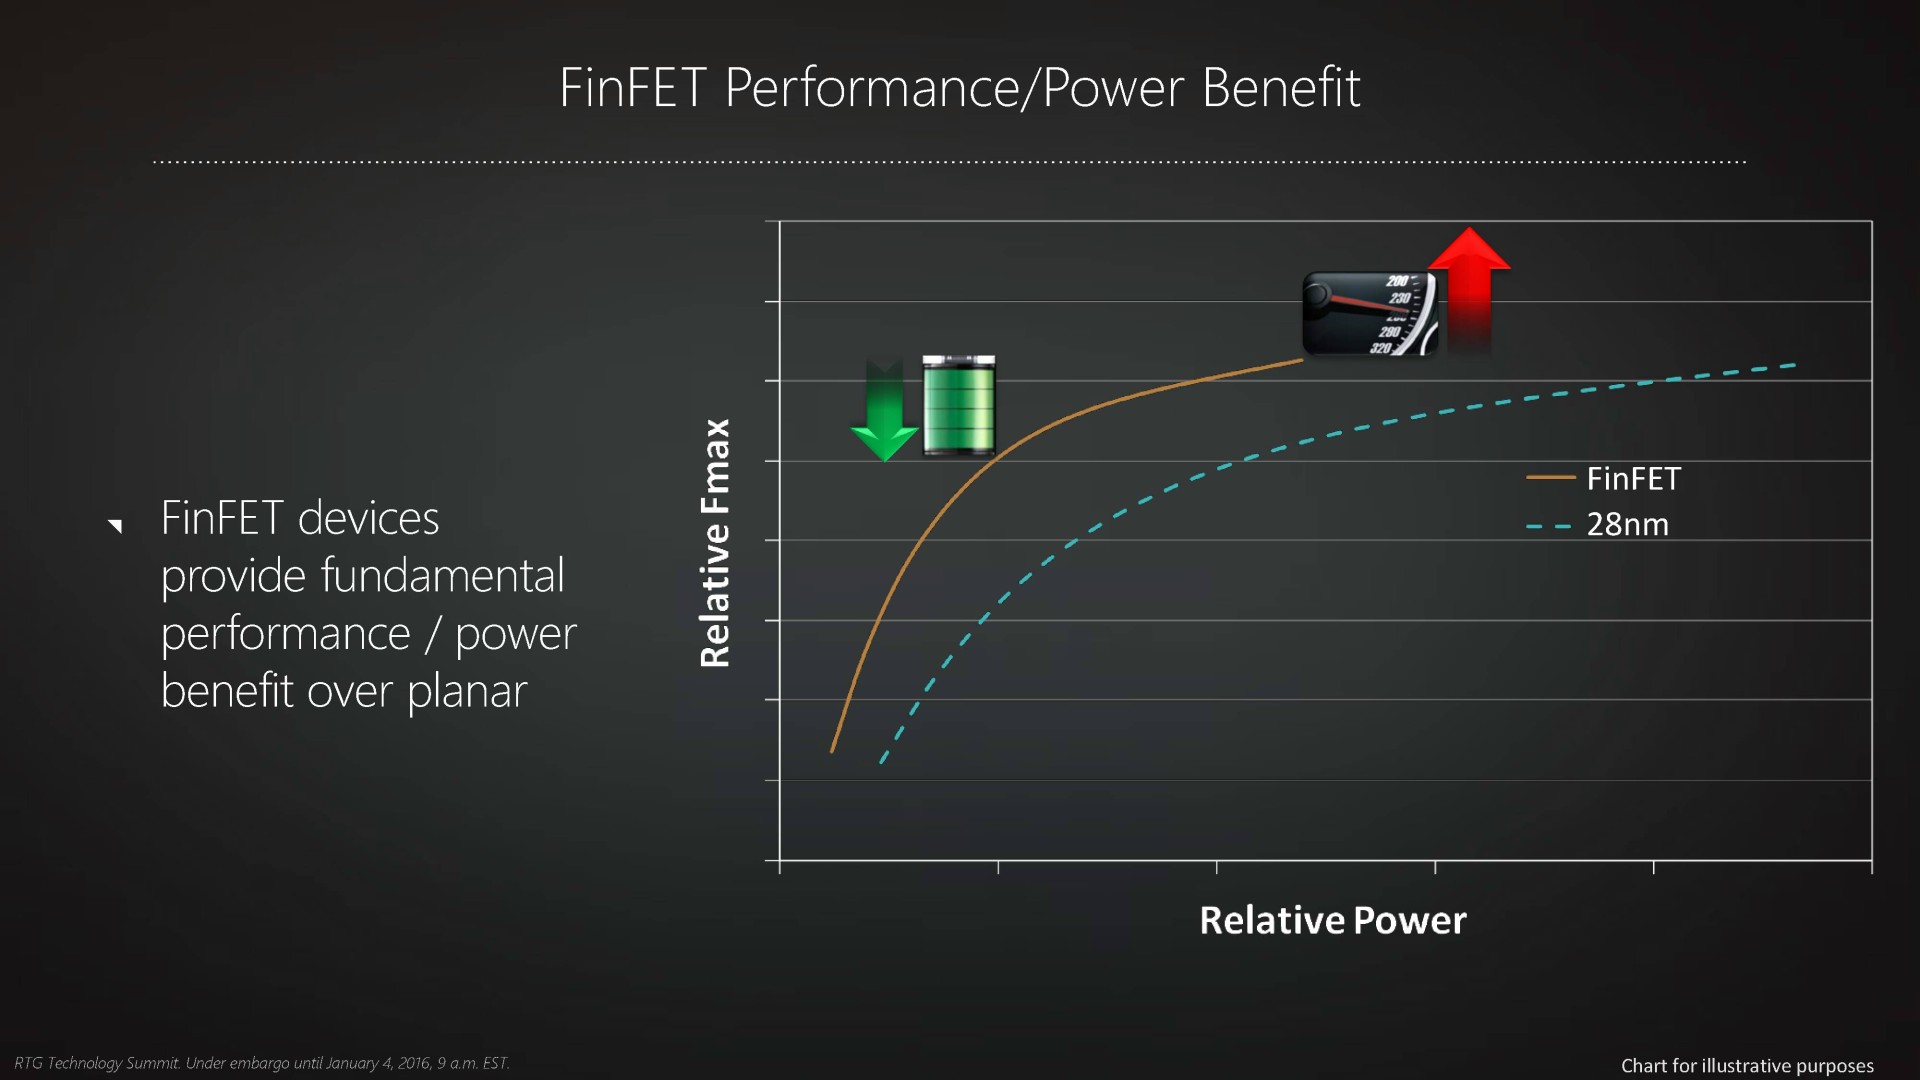
Tout cela va enfin changer en 2016 avec l'arrivée de GPU fabriqués en 16nm FinFET+ chez TSMC et en 14nm LPP chez GlobalFoundries et Samsung. Ces nouveaux procédés de fabrication ont pour point commun de donner enfin aux GPU l'accès à la technologie FinFET, de quoi donner un coup de pied dans une fourmilière bien trop tranquille à notre goût !
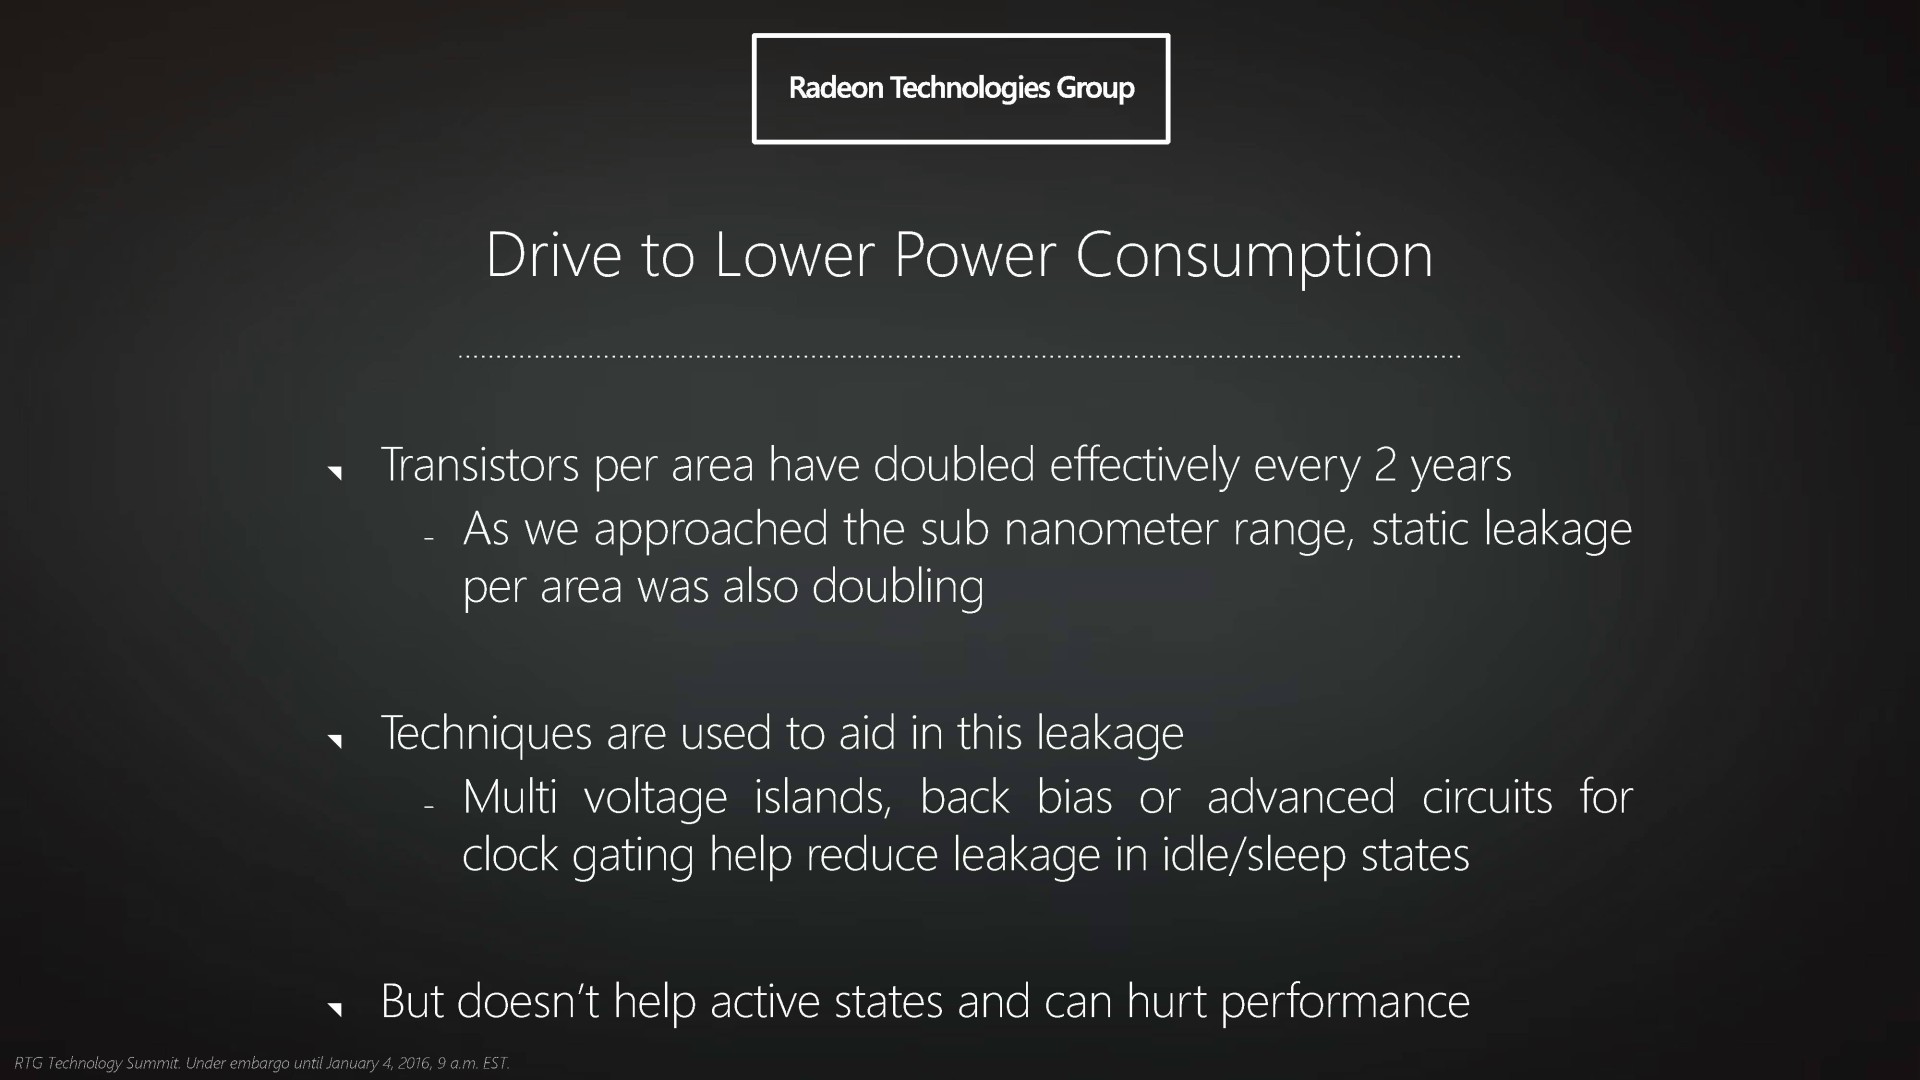
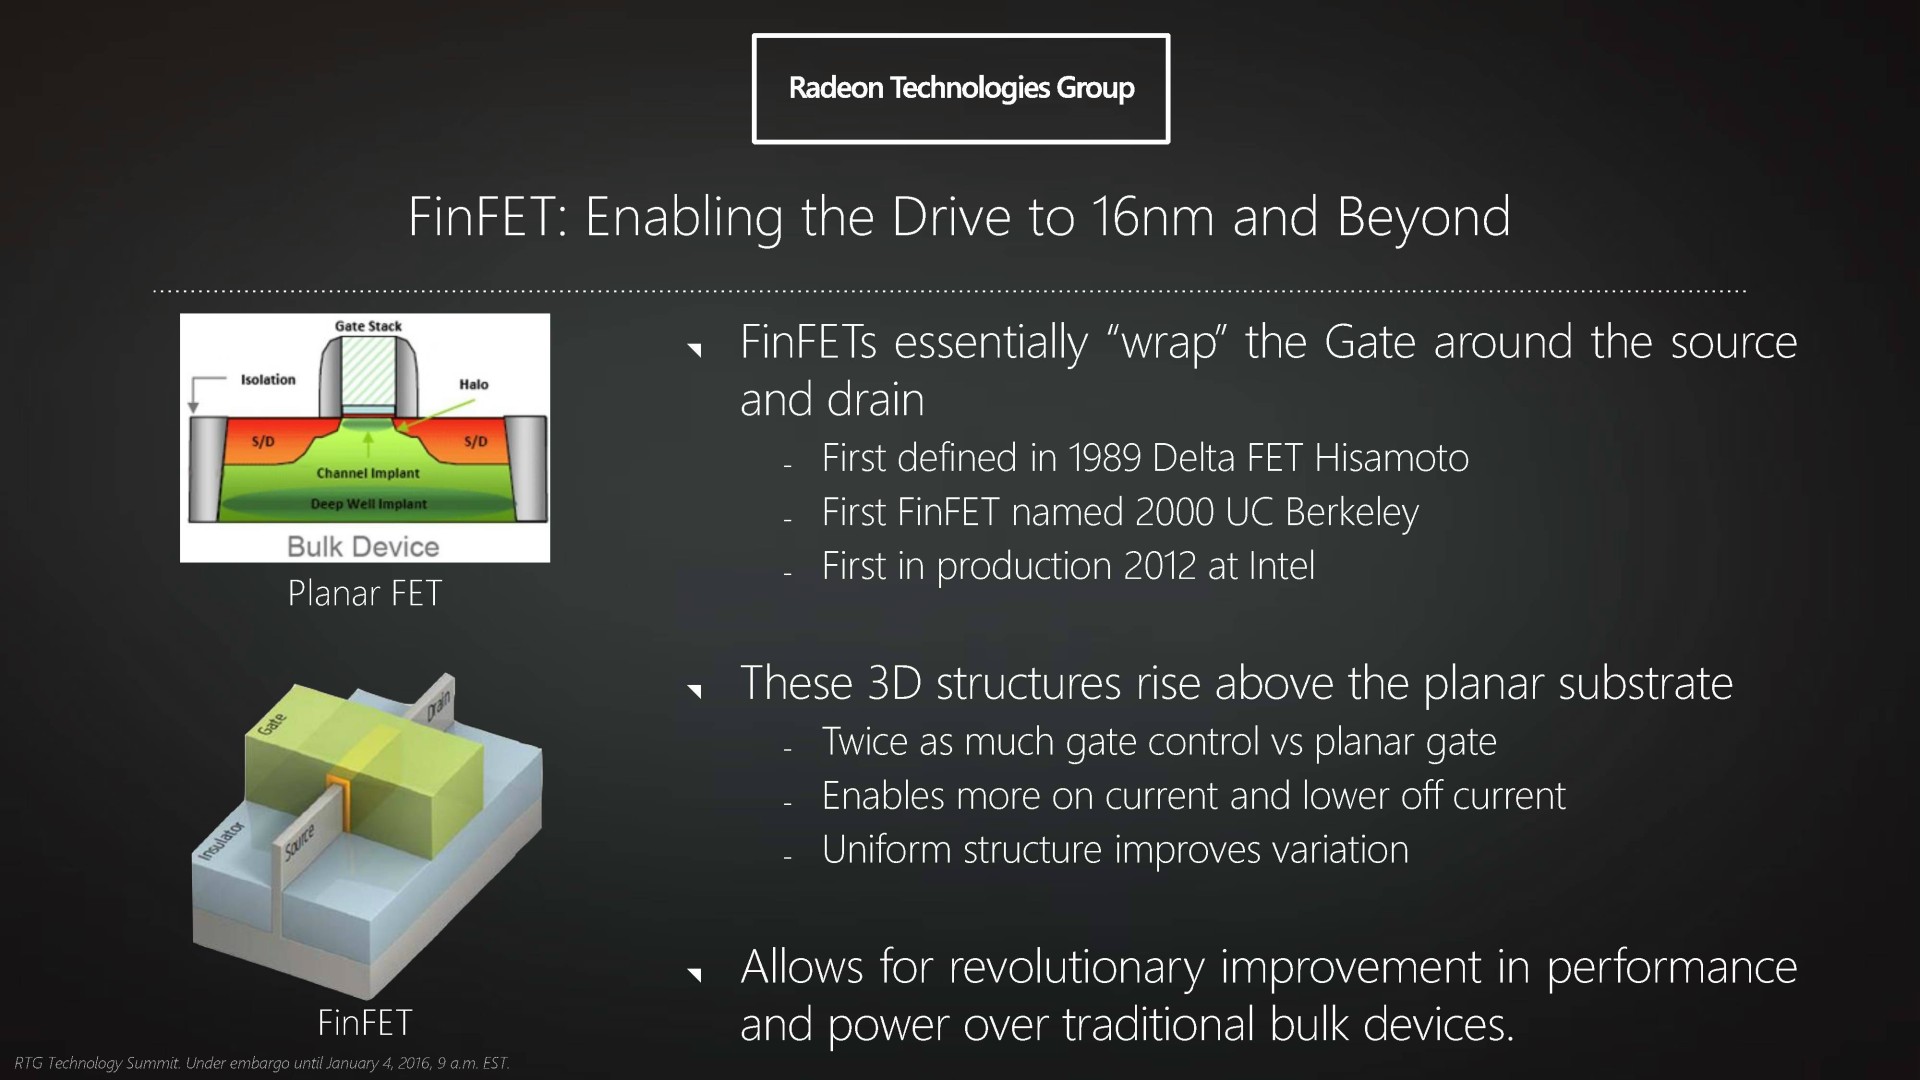
Introduit par Intel en 2012 sous les noms de "transistors tri-gates" ou de "transistors 3D", le FinFET se détache de la construction planaire classique des transistors en donnant une troisième dimension à la porte ce qui permet d'en augmenter la surface de contact et de mieux l'isoler. Les courants de fuite, qui peuvent représenter une grosse partie de la consommation d'un transistors classique, sont alors nettement réduits.
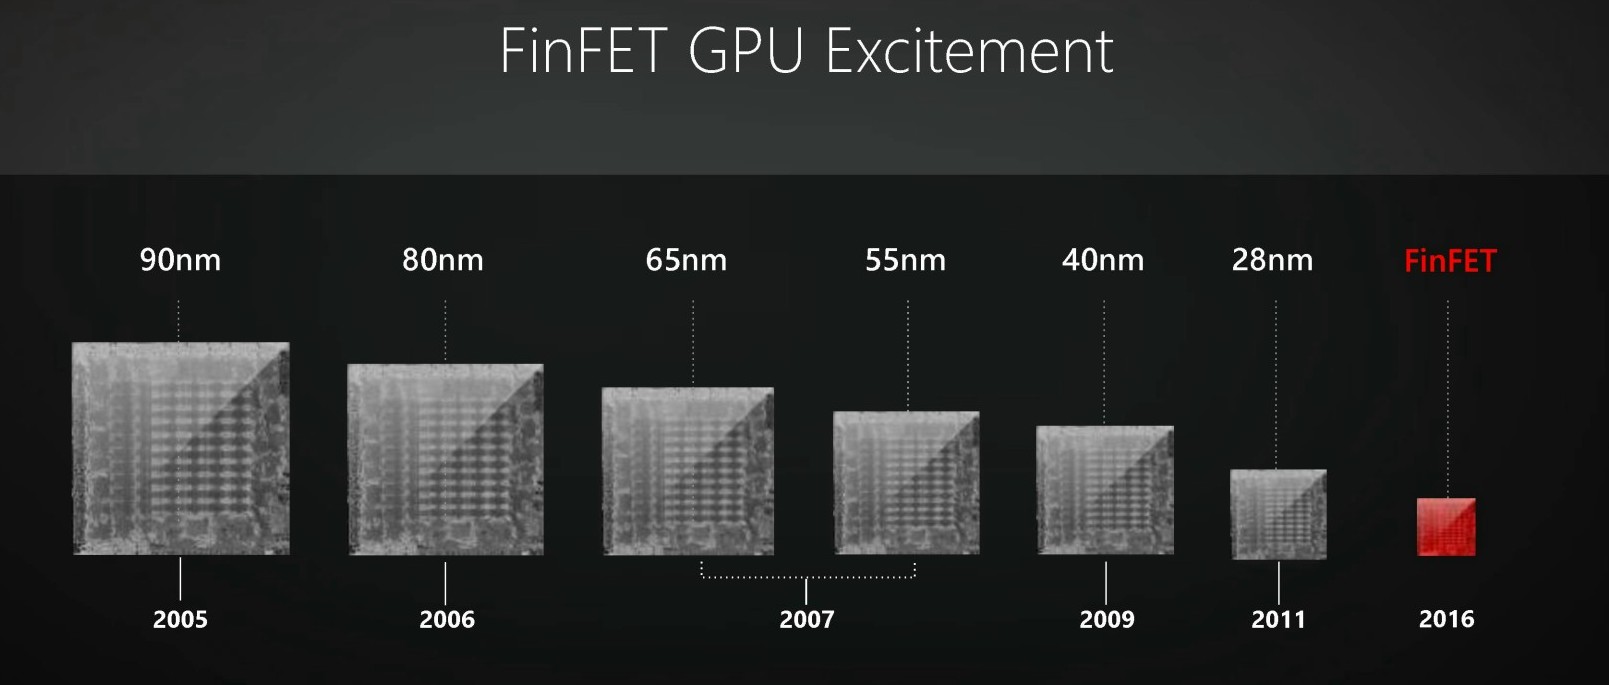
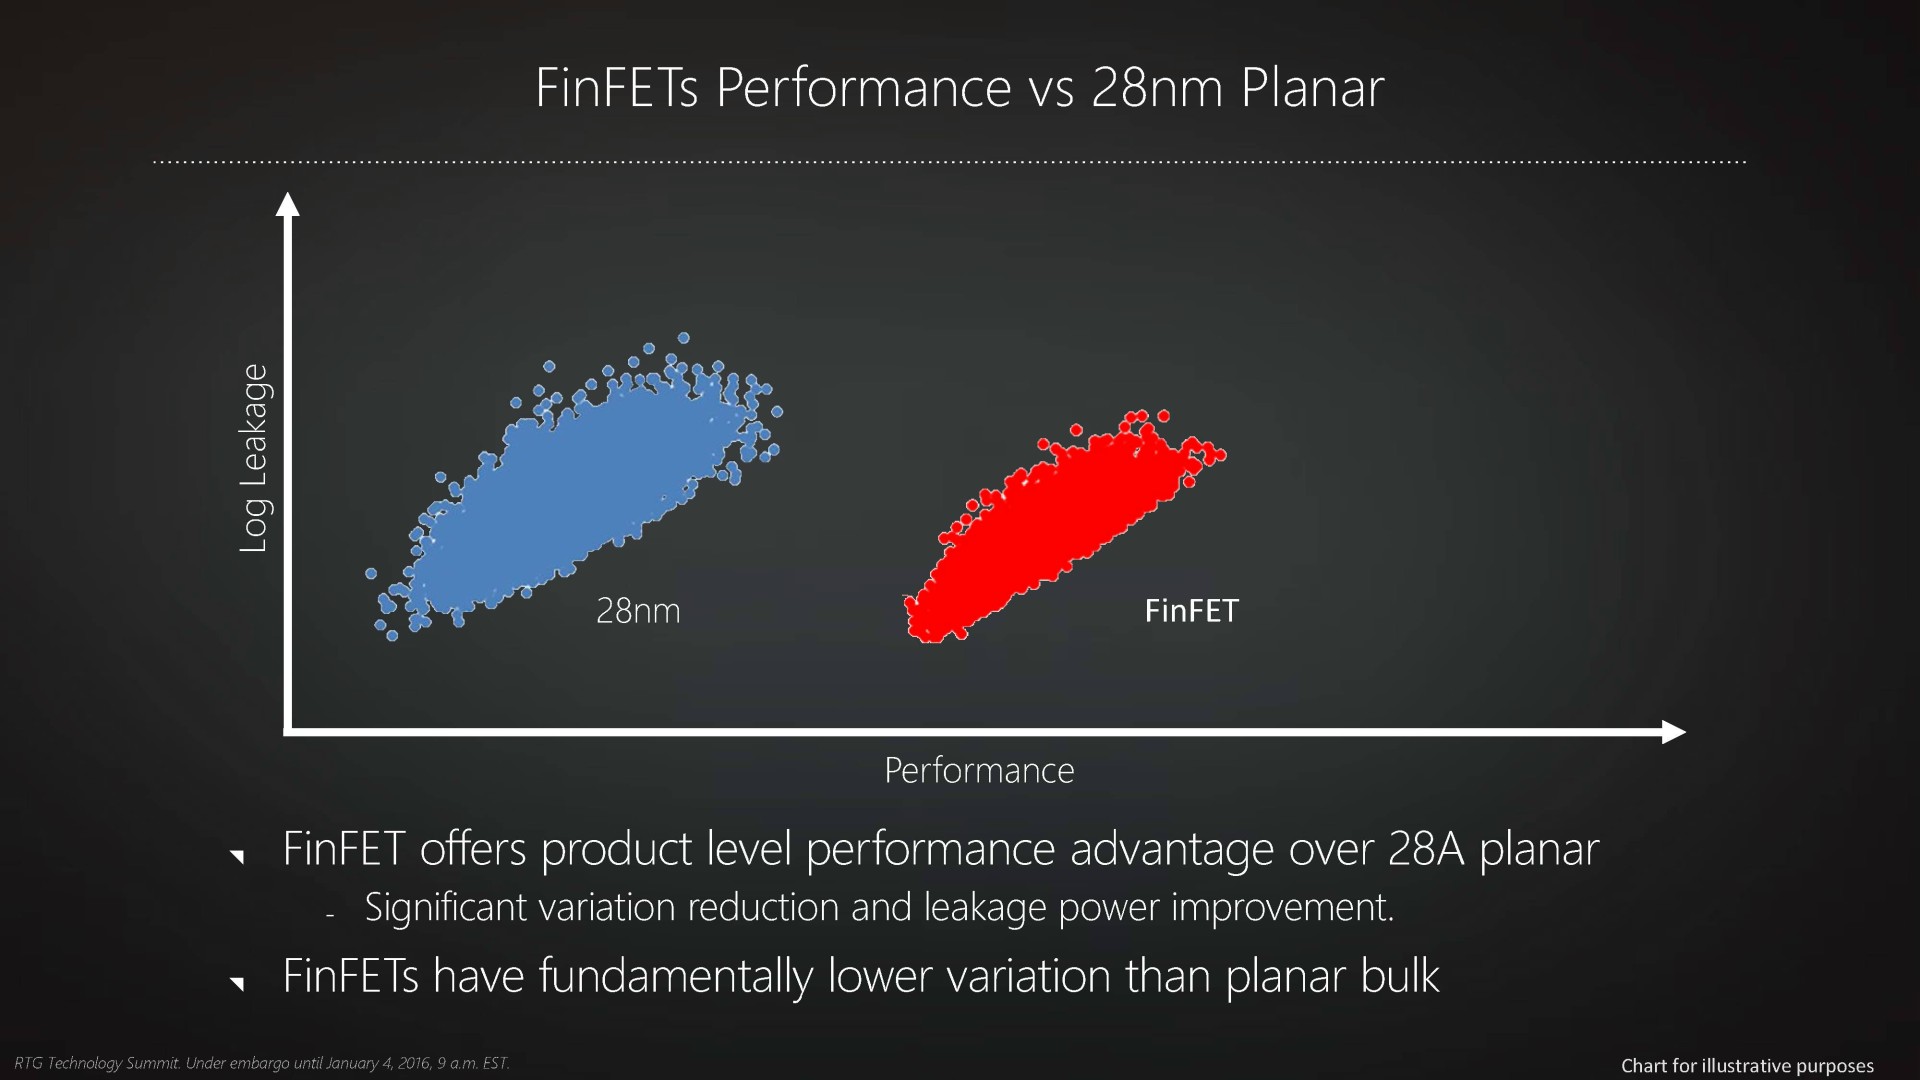
Autant, voire plus, que la finesse de gravure, c'est ainsi le passage au FinFET qui autorise une avancée significative dans les performances des transistors, ce qui peut se traduire par un gain de fréquence, une nette réduction de la consommation ou un mélange de ces deux points selon le positionnement de la puce. Autre avantage selon AMD, le FinFET permet d'obtenir un comportement plus homogène de l'ensemble des transistors, ce qui réduirait la variabilité dans les échantillons produits.
Comme c'est traditionnellement le cas pour les Radeon, c'est lors de ce changement de process qu'AMD va introduire une évolution significative de son architecture GPU, sur laquelle le Radeon Technology Group va bien entendu vouloir communiquer. Et pour cela il faut pouvoir lui mettre un nom.
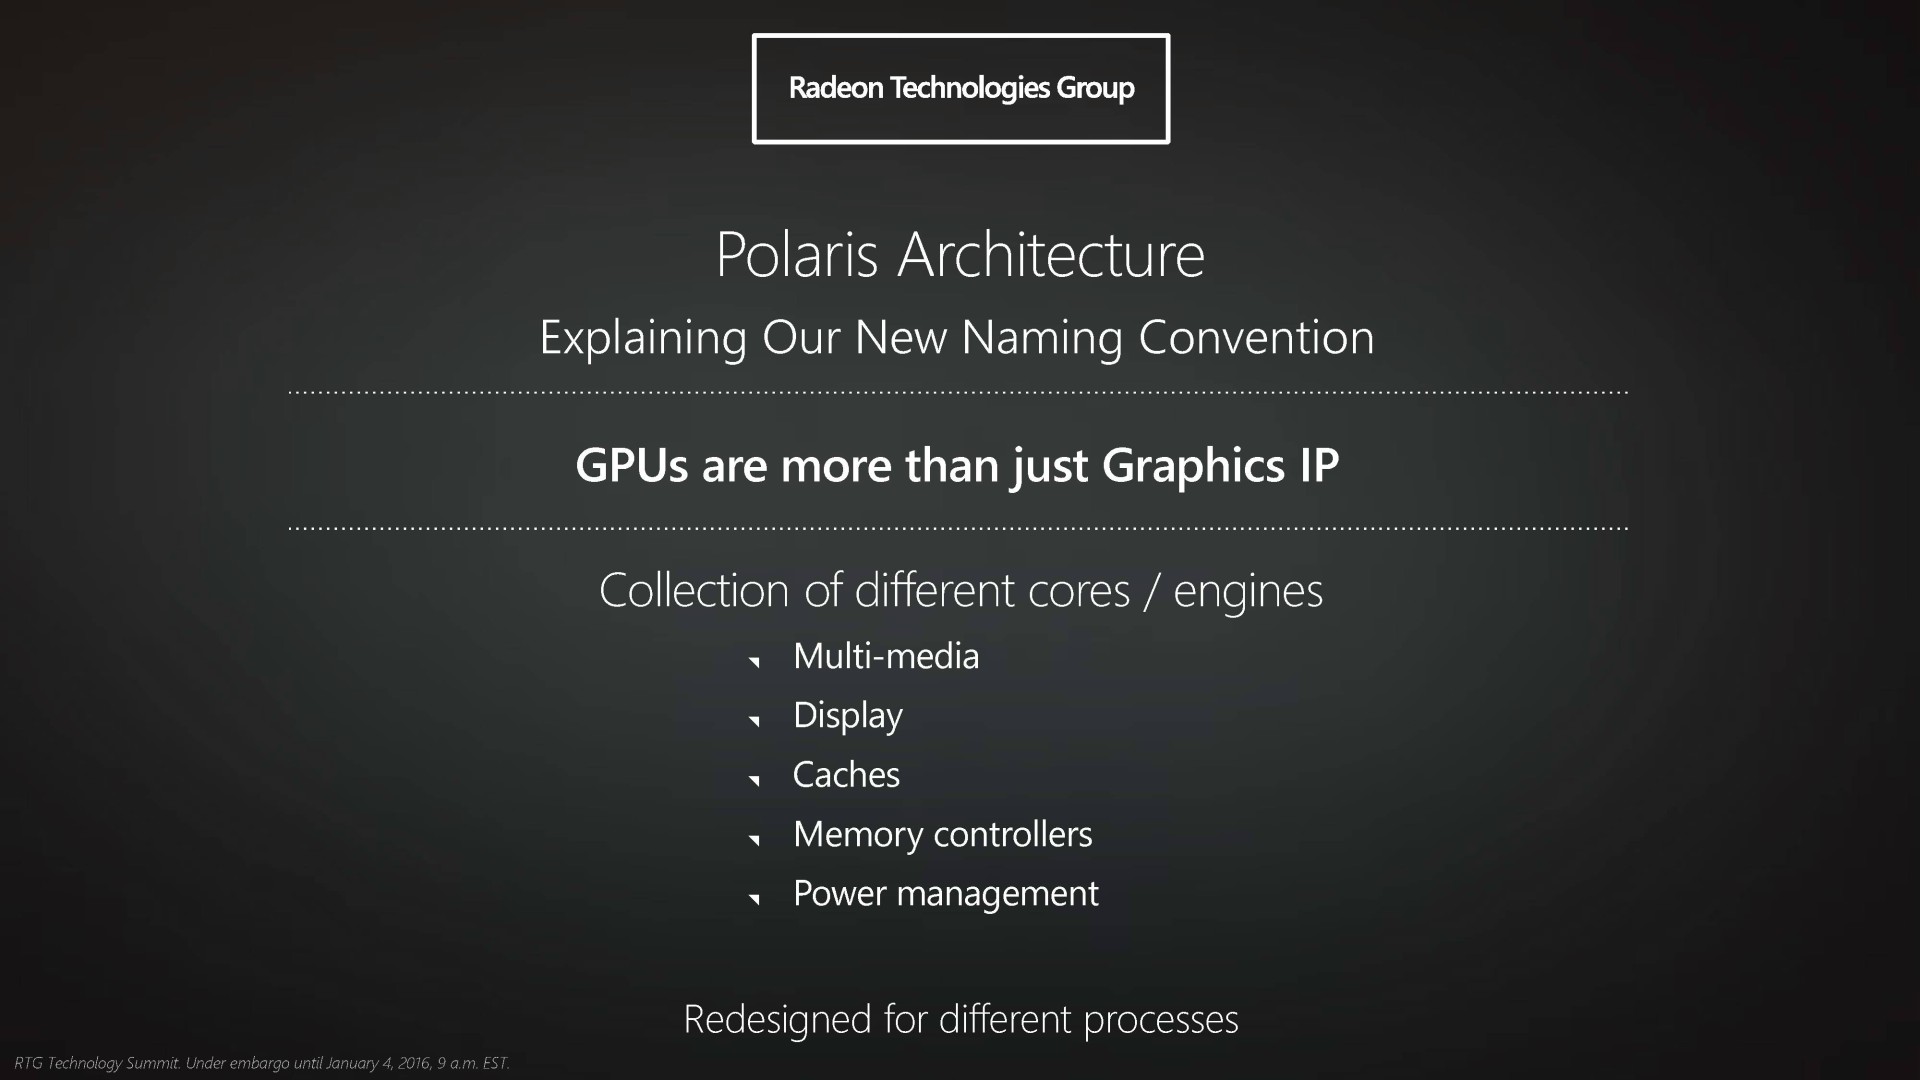
La nomenclature des architectures GPU d'AMD, ou plutôt son absence, a été source de confusion ces dernières années. En l'absence de communication d'AMD, nous avons ainsi fait référence à GCN 1.1 et GCN 1.2 pour parler des petites évolutions apportées depuis la Radeon HD 7970 de décembre 2011. AMD préfère cependant concentrer le terme GCN sur les unités de calcul du GPU (ses "cœurs"), d'autres éléments du GPU pouvant évoluer indépendamment. Polaris représente ainsi le nom global de la nouvelle architecture et GCN 4 la nouvelle version de ses unités d'exécution (après GCN 1 / 1.0, GCN 2 / 1.1 et GCN 3 / 1.2).
Raja Koduri, qui dirige Le Radeon Technology Group, nous a indiqué vouloir faire en sorte que les cartes graphiques qui embarqueront un GPU de type Polaris soient clairement identifiables. Pragmatique et réaliste, il est bien conscient qu'avec une éventuelle future gamme de cartes graphiques, il pourra être difficile pour ses équipes de résister à la tentation d'y intégrer d'anciens GPU. Il sera ainsi important de permettre aux GPU Polaris d'être mis en avant de manière explicite.
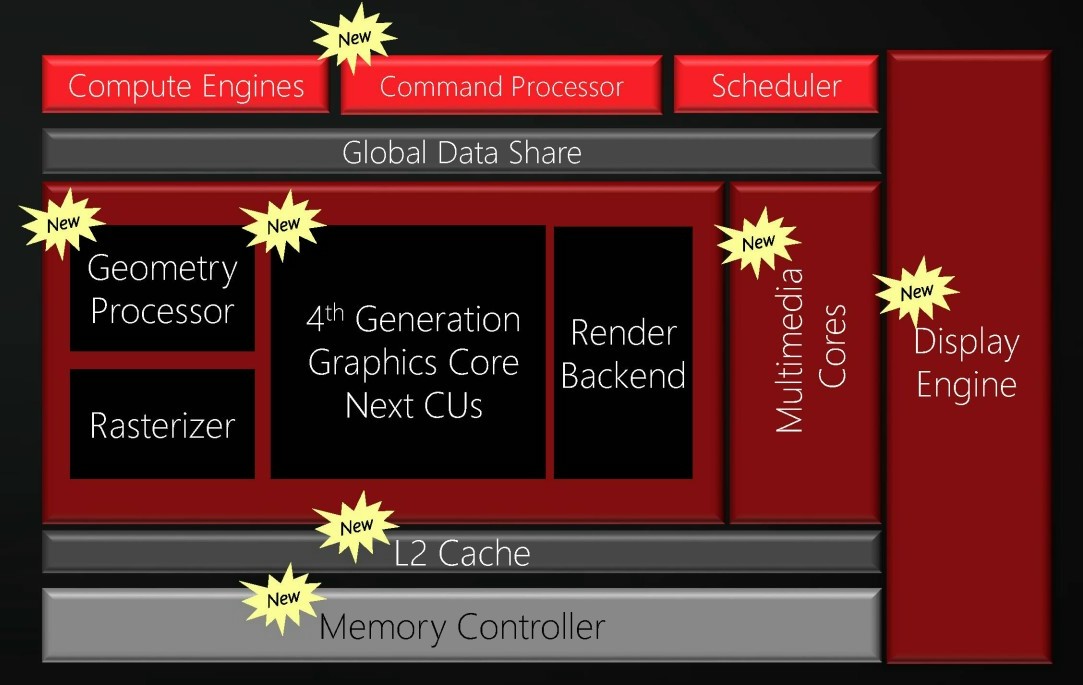
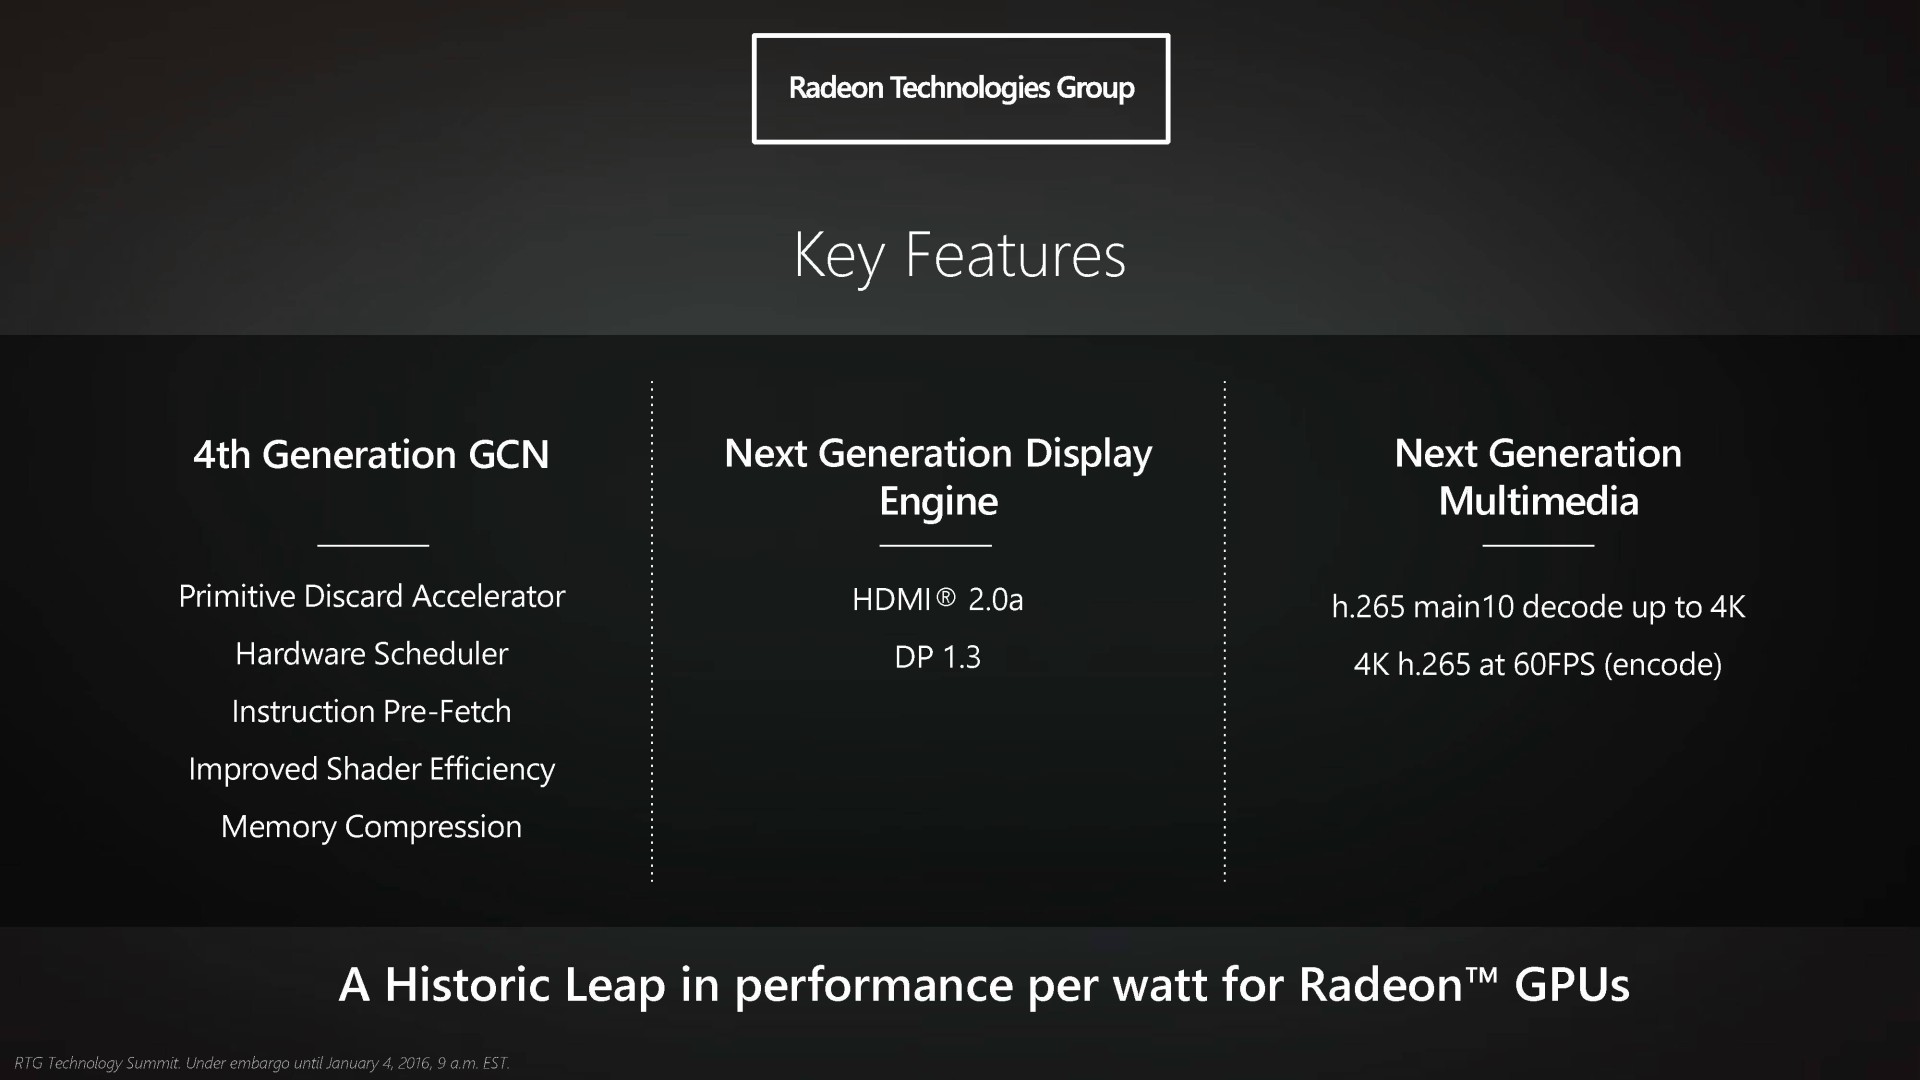
Avec Polaris, à peu près tous les blocs du GPU vont être mis à jour. Nous vous avons déjà parlé de l'aspect affichage et vidéo le mois passé. Pour rappel, les GPU Polaris supporteront le HDMI 2.0a, le DisplayPort 1.3 et le décodage des vidéo 4K en H.265.
Les processeurs de commandes (grahiques et compute), les processeurs géométriques, le cache L2 et le contrôleur mémoire seront également revus pour accompagner le passage aux Compute Units (CU) de type GCN de 4ème génération. Sur ce dernier point AMD précise que Polaris pourra supporter soit un bus GDDR5 soit un bus HBM, suivant les GPU.
Malheureusement, AMD en dit très peu sur les évolutions et ne donne que ces quelques maigres détails :

AMD indique tout d'abord que le cœur de l'architecture a été amélioré pour une meilleure efficacité énergétique. Comme Nvidia a commencé à le faire à partir de la génération Kepler, nous pouvons supposer qu'AMD va essayer de ne plus avoir besoin d'une logique d'ordonnancement complexe et gourmande à l'intérieur des CU, là où le comportement d'une suite de certaines instruction est totalement déterministe et peut donc se contenter d'un ordonnancement statique préparé lors de la compilation.
AMD parle également d'amélioration des ordonnanceurs matériels, mais cette fois nous supposons qu'ils ne font pas référence aux CU mais au front-end et aux tâches globales initiées par les processeurs de commandes. Il s'agit ainsi probablement d'améliorations destinées au support du multi-engine de Direct3D 12. Il est également question de nouveaux modes de compression. Il pourrait s'agir de la compression ASTC, coûteuse à implémenter (mais le 14nm règle ce problème) et qu'AMD et Nvidia avaient évité jusqu'ici, contrairement aux concepteurs de GPU pour SoC pour lesquels quelques transistors de plus ne sont jamais trop chers payés pour économiser de la bande passante mémoire et de l'énergie.
Enfin, AMD mentionne un Primitive Discard Accelerator, soit un système d'éjection des triangles masqués du pipeline de rendu. Pour rappel, statistiquement, à peu près la moitié des triangles d'un objet tournent le dos à la caméra et peuvent être éjectés du rendu dès que cet état est confirmé. Pouvoir le faire rapidement permet de booster les performances géométriques en situation réelle.
Actuellement, les moteurs géométriques des Radeon ne sont pas capables d'effectuer cette tâche plus rapidement que le rendu d'un triangle, contrairement aux GeForce qui en profitent pour se démarquer dans certaines scènes, notamment quand la tesselation génère de nombreux triangles masqués. Avec Polaris, AMD devrait enfin combler ce déficit, probablement en doublant le nombre de moteurs d'éjection des primitives par moteur de rastérisation (Nvidia a opté pour une autre approche en décentralisant une partie du traitement géométrique mais nous ne nous attendons pas à ce qu'AMD suive cette voie).

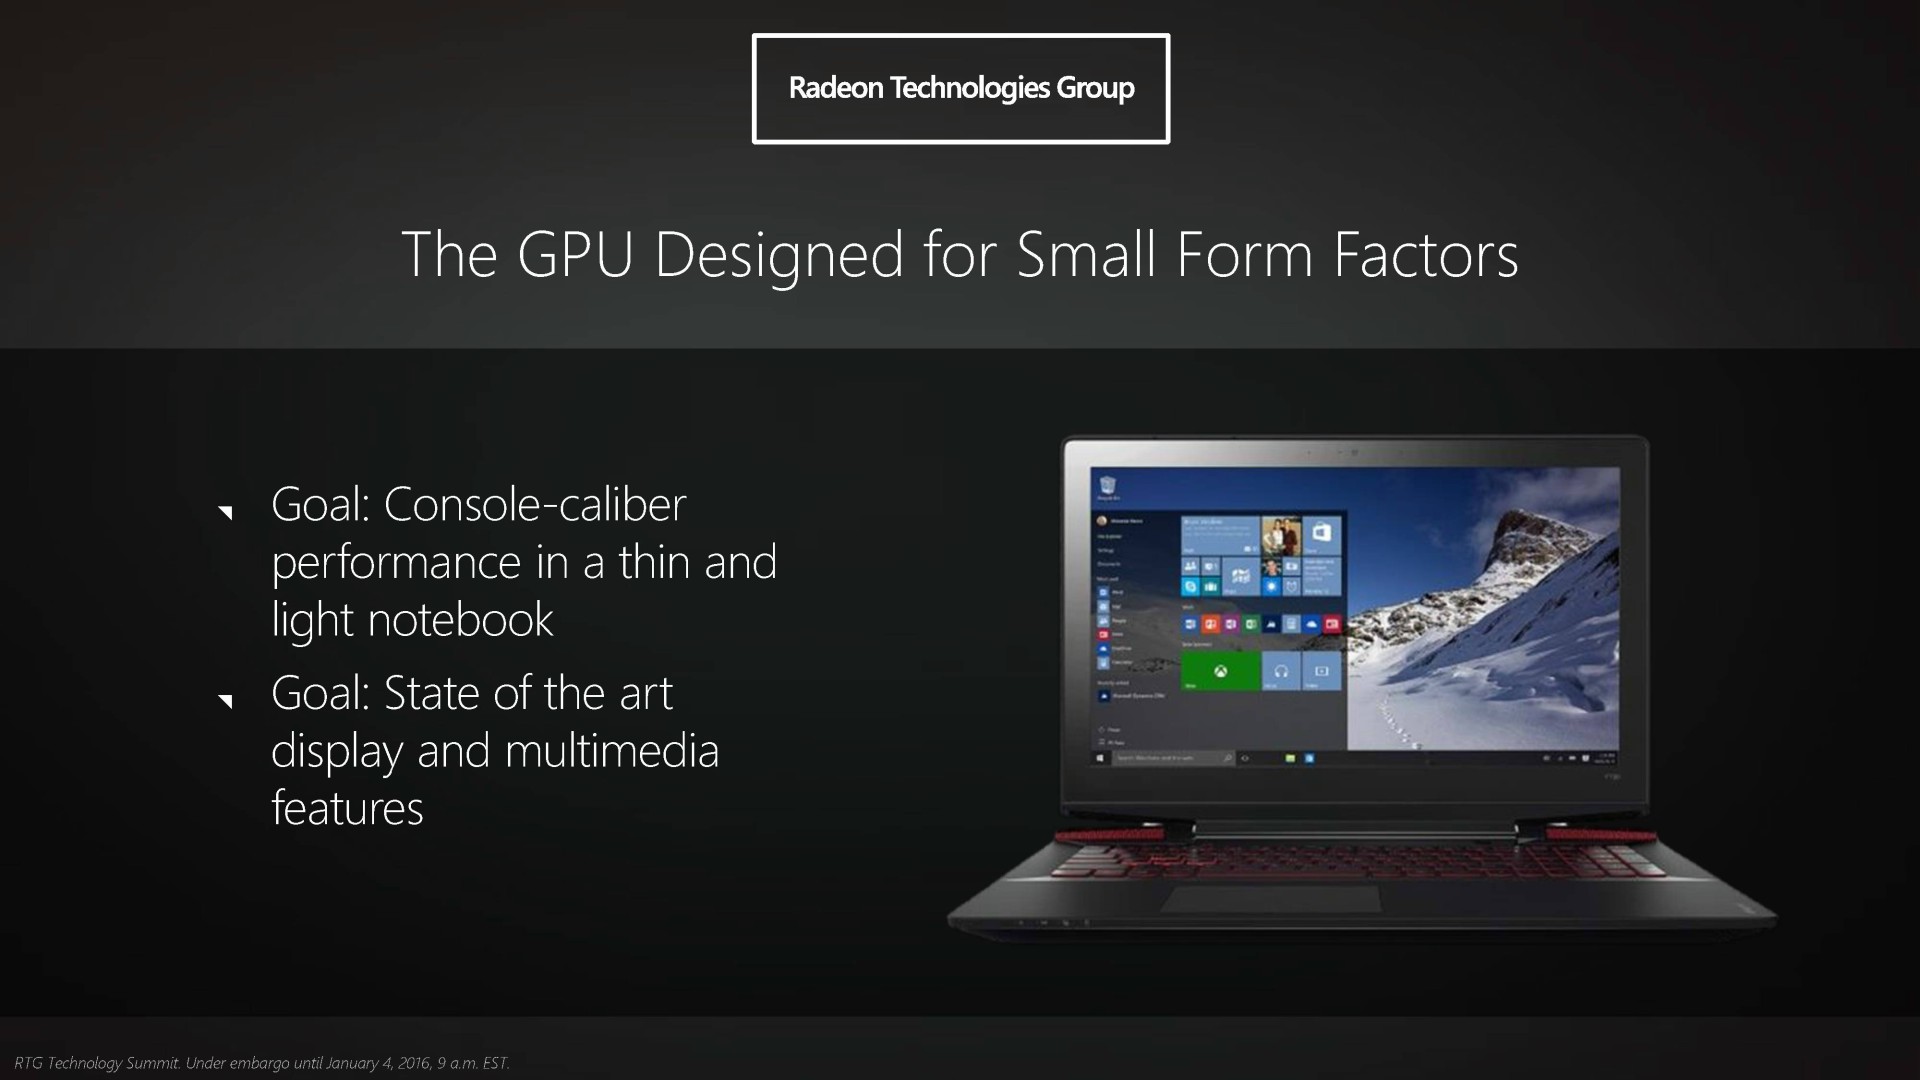
Pour introduire Polaris, contrairement à ce qui se passe habituellement (à l'exception de Maxwell 1 et des GTX 750), AMD met en avant non pas son futur haut de gamme mais un petit GPU prévu pour les PC compacts et pour les portables. Il est équipé de mémoire GDDR5. Nous n'avons pas encore de nom pour ce GPU et n'avons pu l'apercevoir que brièvement sans pouvoir en prendre une photo. Tout juste de quoi apercevoir qu'il s'agit effectivement d'une petite puce et d'un packaging compact.
Sans confirmer que ce serait le premier GPU Polaris disponible, AMD a indiqué que ce petit GPU était important pour sa division graphique, qu'il serait lancé mi-2016 et qu'il serait fabriqué en 14nm chez GlobalFoundries. En précisant ne pas exclure que d'autres GPU soient fabriqués ailleurs, chez Samsung (probablement) ou chez TSMC (de moins en moins probable).
Au niveau de ses spécifications, nous ne saurons rien. Il faudra encore patienter quelque peu, le but d'AMD aujourd'hui étant de nous mettre l'eau à la bouche pour nous faire patienter quelques mois de plus.

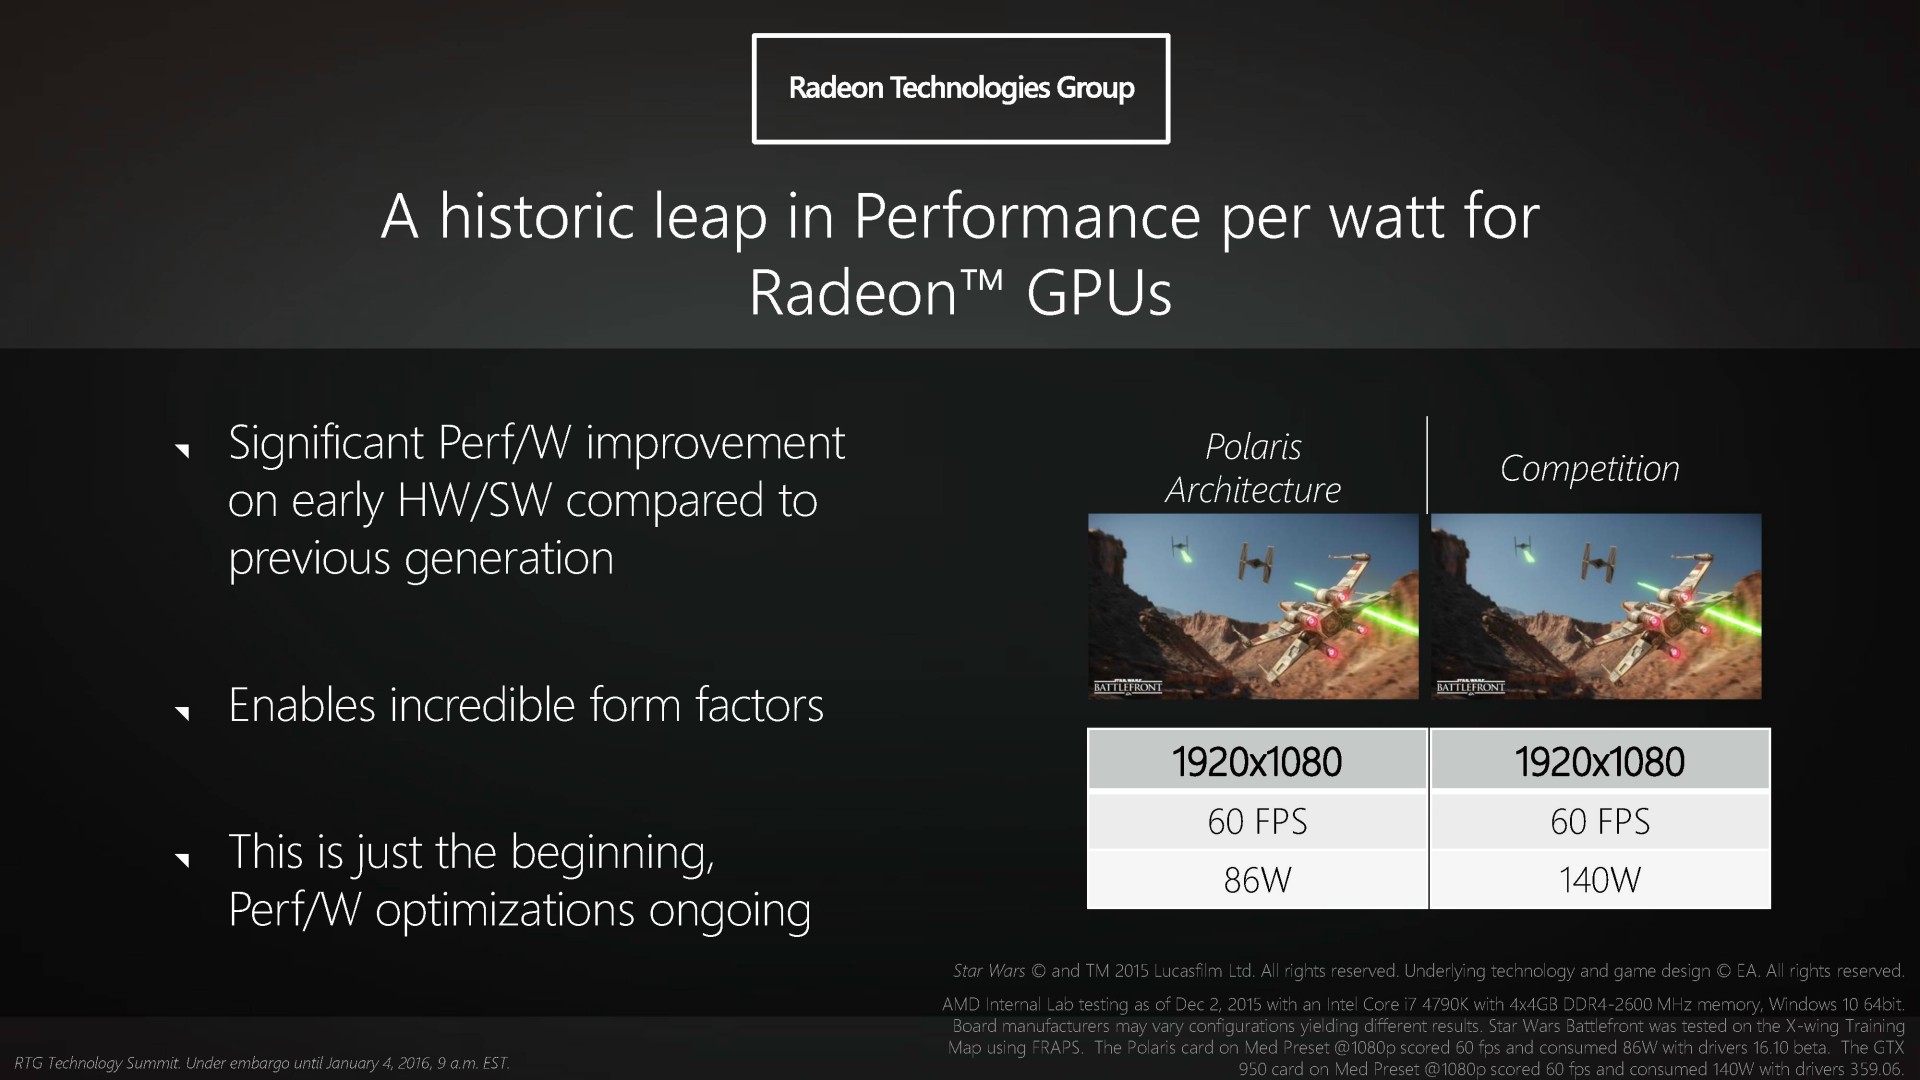
Nous avons par contre pu voir ce GPU en action dans une version alpha lors d'un événement presse organisé il y a quelques semaines. AMD a voulu illustrer les gains d'efficacité énergétique apportés par Polaris par rapport à un GPU Maxwell, déjà très efficace. Des chiffres à prendre avec des pincettes, puisqu'ils restent dans le fond assez vagues et avec des conditions de mesure discutables, mais qui font état d'une progression fulgurante du rendement de l'architecture GCN.
Un système équipé d'un petit GPU Polaris est ainsi capable de maintenir 60 fps dans Star Wars Battlefront avec une consommation totale mesurée à la prise de 86W là où un même système équipé d'une GTX 950 demande 140W. Difficile d'en déduire exactement la consommation GPU et ce gain peut en partie être lié à la combinaison d'une puissance GPU supérieure avec un V-Sync à 60 Hz qui permet de rester à une plus faible fréquence, d'ailleurs le GPU utilisé est configuré à 850 MHz pour 0,8375v seulement. Mais de toute évidence Polaris en 14nm va enfin permettre à AMD de faire mieux que Maxwell en 28nm.
AMD tient d'ailleurs à préciser que cette démonstration a été effectuée avec un support partiel de Polaris par les pilotes. Les gains d'efficacité proviennent ainsi uniquement du 14nm et des CU GCN 4, le support des nouveaux mécanismes dédiés à économiser de l'énergie n'ayant pas encore été implémenté.
Bien entendu, les GPU Polaris n'auront pas simplement affaire aux GPU Maxwell actuels mais bien aux GPU Pascal et peut-être à de petits GPU Maxwell 2 fabriqués en 16/14nm. Et il est beaucoup trop tôt pour savoir comment s'opposeront ces futurs concurrents. Pour la première fois depuis très longtemps, il est d'ailleurs intéressant de noter qu'un élément tiers pourra venir semer le trouble dans le combat AMD vs Nvidia : les fondeurs. En effet, il semble de plus en plus probable qu'AMD exploite principalement les process 14nm de GlobalFoundries et Samsung alors que Nvidia exploiterait plutôt le 16nm de TSMC. Si l'un de ces process s'avère meilleur que l'autre, le fabricant de GPU qui aura misé sur le bon cheval s'en trouvera mécaniquement avantagé même si le process ne fait pas tout.
Vous retrouverez la présentation complète ci-dessous :

Pilotes Nvidia 361.43 WHQL
 Nvidia a mis en ligne les pilotes 361.43 WHQL à destination de ses GPU GeForce. Ils intègrent le support de GameWorks VR 1.1 pour la réalité virtuelle, le support de VR SLI en OpenGL et celui du dernier SDK Oculus.
Les Fermi utilisent désormais un WDDM 2.0 leur ouvrant la porte de DirectX 12 sous Windows 10, mais en SLI on en reste au WDDM 1.3. Côté SLI on note quelques modifications des profils pour Bless, DAyZ, Dungeon Defenders 2, Elite Dangerous et Hard West. Comme d'habitude, quelques bugs ont été corrigés, par exemple sur GM20x les fréquences sur le bureau reviennent prévues pour le repos même à 144 Hz.
- Windows 10 64 bits
- Windows 7/8 64 bits
Les 5 actualités précédentes

