

Actualités cartes graphiques
 Les 5 actualités précédentes
GTC: Nvidia annonce Iray VR et Iray VR Lite
GTC: 200 mm² pour le petit GPU Pascal ?
GTC: Tesla P100: débits PCIe et NVLink mesurés
Rise of the Tomb Raider avec les GTX 960
GTC: N'attendez pas de GeForce en GP100 !

Radeon Software 16.4.2 Hotfix


 AMD a mis en ligne de nouveaux pilotes Radeon Software, les 16.4.2 Hotfix. Le support CrossFire a été revu pour Elite Dangerous et Need for Speed, et 14 bugs ont été corrigés. XConnect, qui permet de supporter un GPU externe en Thunderbolt 3, est désormais compatible avec les R9 Fury et Nano en sus des R300. Pour le téléchargement et les détails, rendez-vous sur cette page.
330mm² pour le GP104
Si nous avions entrevu lors de la GTC le GP106, un petit GPU de 200mm² environ, Nvidia prépare également un GP104 un peu plus gros. Un forumeur en avait déjà posté une photo sur Chiphell il y'a une dizaine de jours, alors accompagné de GDDR5 8 Gbps, il a de nouveau fait son apparition sur ce même forum .
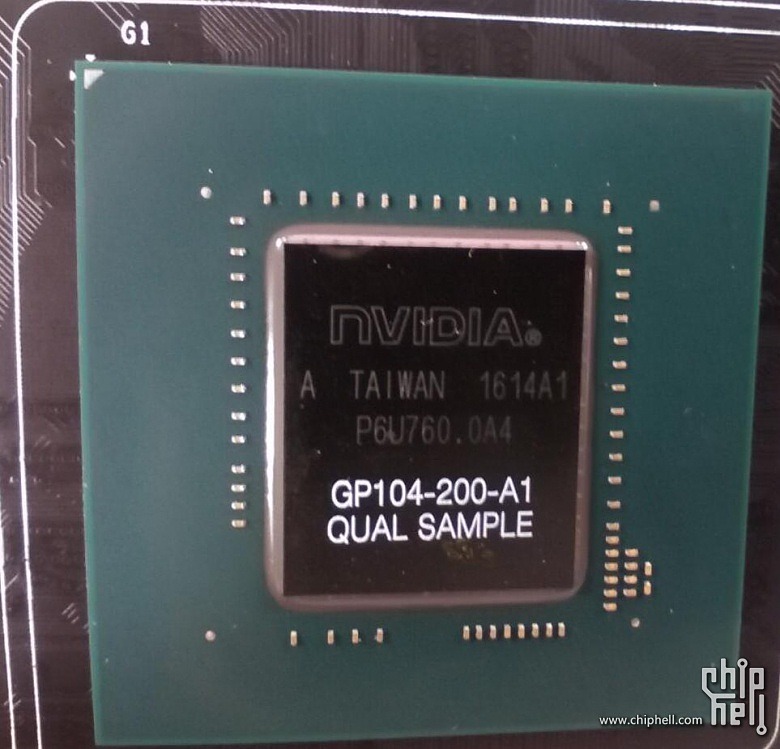

Les clichés permettent d'estimer une taille de l'ordre de 330mm², à comparer aux 398mm² d'un GM204 (GTX 970/980). De quoi embarquer avec le doublement de la densité permis par le 16nm TSMC aux alentours de 8,5 milliards de transistors, le GM200 (GTX 980 Ti/Titan X) en embarquant pour rappel 8 milliards dans 601mm².
On notera sur la photo que la puce est très récente puisque le marquage fait état d'une production début avril. L'auteur de la fuite précise que le bus mémoire est 256-bit et que 8 Go équiperont les cartes, respectivement avec de la GDDR5X pour la GTX 1080 et de la GDDR5 pour la GTX 1070. Wait & See !
GeForce GT 710 PCIe x1 chez Zotac
Zotac avait déjà lancé en 2011 une GT 520 utilisant un port PCI Express x1, il récidive cette-fois avec une GeForce GT 710. Elle est basée un petit GPU Kepler GK208 cadencé à 954 MHz avec 192 unités de calcul actives, soit la moitié de celles intégrées au GPU, qui est associé à 1 Go de DDR3 64-bit. Le tout se contente d'un TDP de 25 watts et d'un refroidissement passif.

Côté sorties on a droit à au DVI Dual Link, à l'HDMI et au VGA. Vu les usages permis par la "puissance" du GPU le PCIe x1 ne devrait pas être limitant alors qu'il permettra d'adjoindre une carte graphique sur des machines le nécessitant mais ne disposant pas d'un PCIe x16 (ou présent mais occupé). Il est noté qu'en théorie une carte x16 fonctionne sur un port x1 (ou x4), mais pour ce faire il ne faut pas que la fin du port sur la carte mère soit fermé… ce qui est systématique.
La FirePro W9100 passe à 32 Go
Lancée en avril 2014, la W9100 a détenue pendant un moment le record de mémoire vidéo pour une carte graphique de série avec 16 Go. Le mois dernier, Nvidia a repris cette couronne avec une nouvelle version 24 Go de la Quadro M6000.
La réponse du berger à la bergère ne se fait pas attendre puisque AMD annonce une FirePro W9100 32 Go qui sera disponible au cours de ce second trimestre 2016. AMD profite ici de la largeur du bus d'Hawaii, 512-bit contre 384-bit pour le GM200, pour exploiter 32 puces GDDR5 8 Gb en mode clamshell (2 puces par lien 32-bit).

Le reste des caractéristiques est identique à la version 16 Go et on a donc droit à un GPU fonctionnant à 930 MHz et de la GDDR5 à 5 Gbps pour un TDP de 275 watts. Rappelons qu'Hawaii dans cette version non bridée traite les calculs doubles précision à demi-vitesse par rapport à la précision simple, contre 1/3 pour le GK110 de Nvidia et 1/32 pour le GM200. Ceci permet à la W9100 de détenir, avec la Fire Pro S9170, le record de débit en calcul double précision avec 2,6 Tflops alors que Tesla P100 atteindra 5,3 Tflops.
Côté tarif le prix conseillé de la W9100 32 Go est de 4999$, contre 3999$ en 16 Go.
GTC: Nvidia annonce CUDA 8, prêt pour Pascal
Comme souvent, l'arrivée d'une nouvelle architecture est associée à une révision majeure de CUDA, l'environnement logiciel de Nvidia destiné au calcul massivement parallèle. Ce sera évidemment le cas pour les GPU Pascal qui pourront profiter dès cet été d'un CUDA 8 taillé sur mesure. Au menu : un support plus évolué de la mémoire unifiée, un profilage plus efficace et un compilateur plus rapide.
La principale nouveauté de CUDA 8 sera le support complet de l'architecture Pascal et particulièrement du GP100 qui équipe l'accélérateur Tesla P100. Déjà introduit avec CUDA 7.5 pour permettre aux développeurs de s'y préparer, le support de la demi-précision (FP16) sera finalisé et pourra permettre des gains conséquents pour les algorithmes qui peuvent s'en contenter. Dans le cas du GP100, CUDA 8 ajoutera évidemment le pilotage des accès mémoire à travers les liens NVLink.
La plus grosse évolution est cependant à chercher du côté de la mémoire unifiée qui va faire un bond en avant avec Pascal, ou tout du moins avec le GP100 puisque nous ne sommes pas certains que les autres GPU Pascal en proposeront un même niveau de support. Si vous avez l'impression qu'on vous a annoncé le support de cette mémoire unifiée avec chaque nouveau GPU, ne vous inquiétez pas, vous n'avez pas rêvé, nous avons la même impression.
Elle est en fait supportée depuis CUDA 6 pour les GPU Kepler et Maxwell mais de façon limitée, que nous pourrions qualifier d'émulée. Pour ces GPU, l'espace de mémoire unifié est en fait dédoublé dans la mémoire centrale et dans la mémoire physiquement associée au GPU. L'ensemble logiciel CUDA se charge de piloter et de synchroniser ces deux espaces mémoires pour qu'ils n'en représentent qu'un seul du point de vue du développeur. De quoi faciliter sa tâche mais au prix de sérieuses limitations : la zone de mémoire unifiée ne peut dépasser la quantité de mémoire rattachée au GPU, le CPU et le GPU ne peuvent y accéder simultanément et de nombreuses synchronisations systématiques sont nécessaires pour forcer la cohérence entre les copies CPU et GPU de cette mémoire.
Pour proposer un support plus avancé de la mémoire unifiée, des modifications matérielles étaient nécessaires au niveau du GPU, ce qui explique pourquoi nous estimons possible que cela soit spécifique au GP100. Tout d'abord l'extension de l'espace mémoire adressable à 49-bit pour permettre de couvrir l'espace de 48-bit des CPU ainsi que la mémoire propre à chaque GPU du système. Ensuite la prise en charge des erreurs de page qui permet d'éviter les coûteuses synchronisations systématiques. Si un kernel essaye d'accéder à une page qui ne réside pas dans la mémoire physique du GPU, il va produire une erreur qui va permettre suivant les cas soit de rapatrier localement la page en question, soit d'y accéder directement à travers le bus PCI Express ou un lien NVLink.
La cohérence peut ainsi être garantie automatiquement, ce qui permet aux CPU et aux GPU d'accéder simultanément à la zone de mémoire unifiée. Sur certaines plateformes, la mémoire allouée par l'allocateur de l'OS sera par défaut de la mémoire unifiée, et il ne sera plus nécessaire d'allouer une zone mémoire spécifique. Nvidia indique travailler à l'intégration de ce support avec Red Hat et la communauté Linux. Par ailleurs, CUDA 8 étend également le support de la mémoire unifiée à Mac OS X.
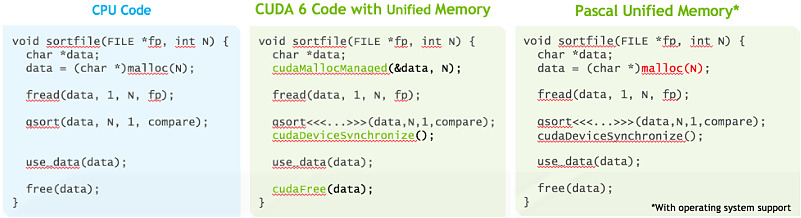
Ce support plus avancé de la mémoire unifiée va faciliter le travail des développeurs et surtout rendre plus abordable leurs premiers pas sur les GPU tout en maintenant un relativement bon niveau de performances. Tout du moins si le pilote et le runtime CUDA font leur travail correctement puisque c'est à ce niveau que tout va se jouer. A noter que les développeurs plus expérimentés conservent la possibilité de gérer explicitement la mémoire.
Parmi les autres nouveautés, Nvidia introduit une première version de la librairie nvGRAPH (limitée au mono GPU) qui fournit des routines destinées à accélérer certains algorithmes spécifiques au traitement des graphes. Traiter rapidement les opérations sur ces structures mathématique prend de plus en plus d'importance, que ce soit pour les moteurs de recherche, la publicité ciblée, l'analyse des réseaux ou encore la génomique. Faciliter l'exécution de ces opérations sur le GPU est donc important pour leur ouvrir la porte à de nouveaux marchés potentiels.
Une autre évolution importante est à chercher du côté des outils de profilages qui vont dorénavant fournir une analyse des dépendances. De quoi par exemple permettre de mieux détecter que les performances sont limitées par un kernel qui bloque le CPU trop longtemps. Ces outils revus prennent également en compte NVLink et la bande passante utilisée à ce niveau.
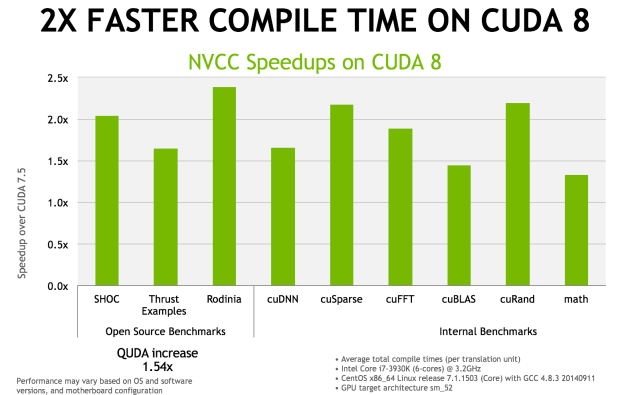
Enfin, le compilateur NVCC 8.0 a reçu de nombreuses optimisations pour réduire le temps de compilation. Nvidia annonce qu'il serait réduit de moitié, voire plus, dans de nombreux cas. Ce compilateur étend également le support expérimental des expressions lambda de C++11.
La sortie de CUDA 8.0 est prévue pour le mois d'août mais une release candidate devrait être proposée dès le mois de juin.
Les 5 actualités précédentes

